
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
Tabela de conteúdo
-
O que é regressão linear?
-
Importância da regressão linear na análise preditiva.
-
Aplicação prática de regressão linear usando R.
-
Aplicação do conjunto de dados de pressão arterial e idade.
O que é uma regressão linear?
A análise de regressão linear simples é uma técnica para encontrar a associação entre duas variáveis. As duas variáveis envolvidas são uma variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... Variável dependente responsiva à mudança e a variável independente. Observe que não estamos calculando a dependência da variável dependente da variável independente, apenas a associação.
Por exemplo, uma empresa está investindo uma certa quantia de dinheiro no marketing de um produto e também coletou dados de vendas ao longo dos anos, analisando a correlação entre o orçamento de marketing e os dados de vendas, podemos prever a venda do próximo ano se a empresa alocar uma certa quantia de dinheiro para o departamento de marketing. A ideia de previsão acima parece mágica, mas são estatísticas puras. A regressão linear consiste basicamente em ajustar uma linha reta ao nosso conjunto de dados para que possamos prever eventos futuros.
A linha de melhor ajuste seria da forma:
Y = B0 + B1X
Onde, E – Variável dependente
X – Variável independente
B0 e B1 – Parâmetro de regressão
Predição da pressão arterial por idade por regressão em R
Equação da linha de regressão em nosso conjunto de dados.
BP = 98,7147 + 0,9709 Era
Importando conjunto de dados
Importe um conjunto de dados Idade vs Pressão Arterial que é um arquivo CSV usando a função read.csv () em R e armazenar este conjunto de dados em um dataframe bp.
bp <- read.csv ("bp.csv")
Crie um quadro de dados para prever valores
Criação de um quadro de dados que armazenará a idade de 53 anos. E este quadro de dados será usado para prever a pressão arterial em 53 anos depois de criar um modelo de regressão linear.
p <-  as.data.frame(53)
colnames(p) <- "Era"
Criando um Diagrama de dispersãoO gráfico de dispersão é uma ferramenta gráfica usada em estatística para visualizar a relação entre duas variáveis. Consiste em um conjunto de pontos em um plano cartesiano, onde cada ponto representa um par de valores correspondentes às variáveis analisadas. Este tipo de gráfico permite identificar padrões, Tendências e possíveis correlações, facilitando a interpretação dos dados e a tomada de decisão com base nas informações visuais apresentadas.... Usando a biblioteca ggplot2
Com a ajuda da biblioteca ggplot2 em R, podemos ver que existe uma correlação entre a pressão arterial e a idade, como podemos ver que o aumento da idade é seguido por um aumento da pressão arterial.
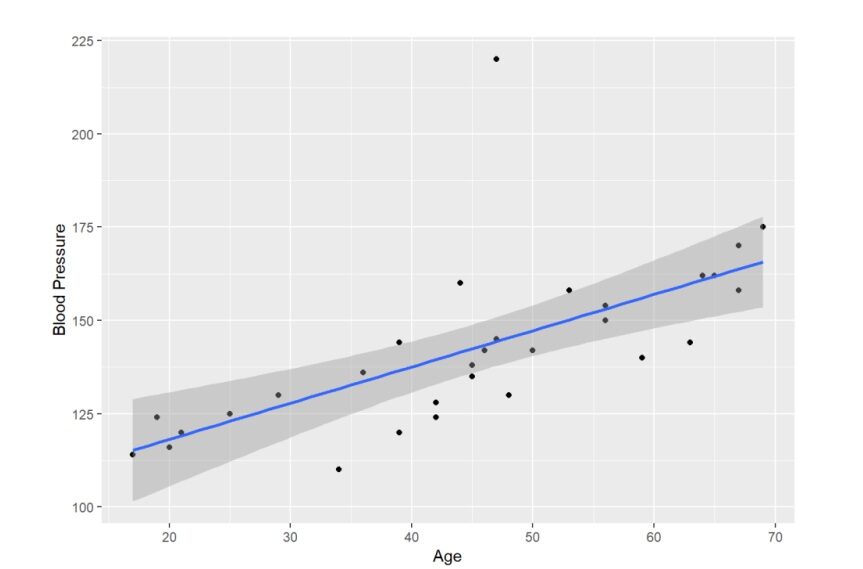
É bastante evidente a partir do gráfico que a distribuição no gráfico está espalhada de tal forma que podemos encaixar uma linha reta através dos pontos.
Calcule a correlação entre idade e pressão arterial
Também podemos verificar em nossa análise anterior que existe uma correlação entre a pressão arterial e a idade com a ajuda da função cor () em R que é usado para calcular a correlação entre duas variáveis.
cor(bp $ BP,bp $ Idade)
[1] 0,6575673
Crie um modelo de regressão linear
Agora, com a ajuda da função lm (), vamos fazer um modelo linear. A função lm () tem dois atributos, primeiro é uma fórmula onde usaremos “BP ~ Idade” porque a idade é uma variável independente e a pressão arterial é uma variável dependente e a segunda são os dados, onde iremos dar o nome do quadro de dados que contém os dados que neste caso é o quadro de dados bp.
modelo <- lm(BP ~ Idade, dados = bp)
Resumo do nosso modelo de regressão linear
resumo(modelo)
Produção:
##
## Ligar:
## lm(fórmula = BP ~ Idade, dados = bp)
##
## Resíduos:
## Mín. 1Q Mediana 3Q Máx.
## -21.724 -6.994 -0.520 2.931 75.654
##
## Coeficientes:
## Estimativa Std. Valor t de erro Pr(>|t|)
## (Interceptar) 98.7147 10.0005 9.871 1.28e-10 ***
## Era 0.9709 0.2102 4.618 7.87e-05 ***
## ---
## Signif. códigos: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Erro padrão residual: 17.31 sobre 28 graus de liberdade
## R-quadrado múltiplo: 0.4324, R-quadrado ajustado: 0.4121
## Estatística F: 21.33 sobre 1 e 28 DF, valor p: 7.867e-05
Interpretação do modelo
## Coeficientes:
## Estimativa Std. Valor t de erro Pr(>|t|)
## (Interceptar) 98.7147 10.0005 9.871 1.28e-10 ***
## Era 0.9709 0.2102 4.618 7.87e-05 ***
## ---
## Signif. códigos: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
B0 = 98.7147 (E- interceptar)
B1 = 0.9709 (Coeficiente de idade)
BP = 98.7147 + 0.9709 Era
Isso significa que uma mudança em uma unidade de idade trará 0.9709 unidades para alterar a pressão arterial.
Erro padrão É a variabilidade esperada no coeficiente que captura a variabilidade da amostragem, então a variação na interseção pode ser de até 10.0005 e a variação na idade será 0.2102 não mais do que isso
Valor T: o valor t é o coeficiente dividido pelo erro padrão, é basicamente o quão grande é estimado em relação ao erro, quanto maior o coeficiente em relação ao Std. erro, maior será o t-score e o t-score vem com um valor p devido à sua distribuição. O valor p é o quão estatisticamente significativa é a variável para o modelo para um nível de confiança do 95% vamos comparar este valor com alfa, que será 0.05 , então, em nosso caso, o valor p da interseção e a idade é menor que alfa (alfa = 0.05), isso implica que ambos são estatisticamente significativos para o nosso modelo.
## Erro padrão residual: 17.31 sobre 28 graus de liberdade
## Múltiplos quadrados R: 0,4324, R quadrado ajustado: 0,4121
## Estatística F: 21,33 sobre 1 e 28 DF, valor p: 7,867e-05
Erro padrão residual ou o erro padrão do modelo é basicamente o erro médio do modelo que é 17.31 em nosso caso e significa que nosso modelo pode ter um erro médio de 17.31 ao prever a pressão arterial. Quanto menor o erro, melhor será o modelo ao prever.
Múltiplos R-quadrados é a razão para (1- (soma do quadrado do erro / soma do quadrado total))
R quadrado ajustado:
Se adicionarmos variáveis, não importa se é significativo na previsão ou não, o valor de R ao quadrado aumentará, razão pela qual o R quadrado ajustado é usado, porque se a variável agregada não for significativa para a previsão do modelo, o valor R ajustado - quadrado irá reduzir, é uma das ferramentas mais úteis para evitar overfitting do modelo.
F – Estatisticas é a razão entre o quadrado médio do modelo e o quadrado médio do erro, Em outras palavras, é a razão de quão bem o modelo está funcionando e o que está causando o erro, e quanto maior o valor F, melhor o modelo está funcionando em comparação com o erro.
Um são os graus de liberdade do numerador da estatística F e 28 é o grau de liberdade dos erros.
Preveja o valor da pressão arterial em 53 anos
BP = 98,7147 + 0,9709 Era
A fórmula acima será usada para calcular a pressão arterial na idade de 53 anos e isso será alcançado usando a função de previsão () primeiro iremos escrever o nome do modelo de regressão linear separando-o por uma vírgula dando o valor do novo conjunto de dados em p desde a Idade 53 foi salvo anteriormente no quadro de dados p.
prever(modelo, newdata = p)
## 1
## 150.1708
Então, o valor previsto da pressão arterial é 150,17 aos 53 anos.
Como previmos a pressão arterial com a associação de Idade, agora pode haver mais de uma variável independente envolvida, mostrando uma correlação com uma variável dependente chamada de regressão múltipla.
Modelo de regressão linear múltipla
A análise de regressão multilinear é uma técnica estatística para encontrar a associação de múltiplas variáveis independentes na variável dependente.. Por exemplo, a receita gerada por uma empresa depende de vários fatores, incluindo o tamanho do mercado, o preço, A promoção, o preço da competição, etc. Basicamente, o modelo de regressão linear múltipla estabelece uma relação linear entre uma variável dependente e múltiplas variáveis independentes.
A equação de regressão linear múltipla é a seguinte:
Y = B0 + B1X1 + B2X2 + .. + BnXk + E
Onde
E – Variável dependente
X – Variável independente
B0, B1, B3,. – Coeficientes de regressão linear múltipla
E- Erro
Tomando outro exemplo do conjunto de dados Wine e com a ajuda de AGST, HarvestRain vamos prever o preço do vinho.
Importando o conjunto de dados
Usando a função read.csv (), importar o conjunto de dados wine.csv e wine_test.csv para o data frame wine e wine_test respectivamente.
vinho <- read.csv("wine.csv")
wine_test <- read.csv("wine_test.csv")
Baixe o conjunto de dados abaixo
Encontre a correlação entre as diferentes variáveis
Usando a função cor () e a função redonda () podemos arredondar a correlação entre todas as variáveis no conjunto de dados do vinho para duas casas decimais.
volta(cor(vinho),2)
Produção:
Ano Preço Inverno Chuvas AGST Colheita Idade das chuvas França Pop
## Ano 1.00 -0.45 0.02 -0.25 0.03 -1.00 0.99
## Preço -0.45 1.00 0.14 0.66 -0.56 0.45 -0.47
## WinterRain 0.02 0.14 1.00 -0.32 -0.28 -0.02 0.00
## AGST -0.25 0.66 -0.32 1.00 -0.06 0.25 -0.26
## HarvestRain 0.03 -0.56 -0.28 -0.06 1.00 -0.03 0.04
## Era -1.00 0.45 -0.02 0.25 -0.03 1.00 -0.99
## FrancePop 0.99 -0.47 0.00 -0.26 0.04 -0.99 1.00
Gráficos dispersos
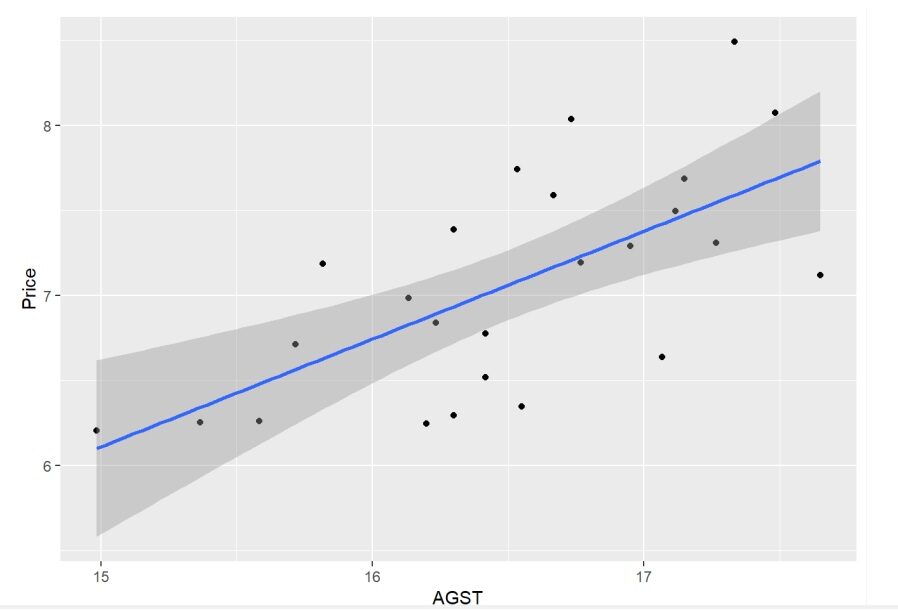
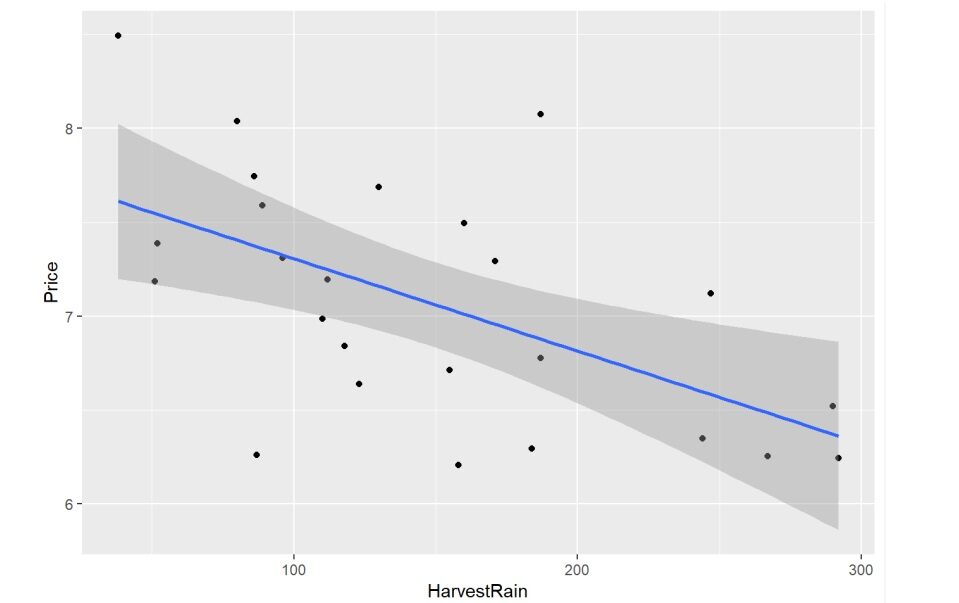
Ao usar a biblioteca ggplot2 em R, criar um gráfico de dispersão que possa mostrar claramente que AGST e o preço do vinho estão altamente correlacionados. Do mesmo modo, a gráfico de dispersãoUm gráfico de dispersão é uma representação visual que mostra a relação entre duas variáveis numéricas usando pontos em um plano cartesiano. Cada eixo representa uma variável, e a localização de cada ponto indica seu valor em relação a ambos. Esse tipo de gráfico é útil para identificar padrões, Correlações e tendências nos dados, facilitando a análise e interpretação de relações quantitativas.... entre o HarvestRain e o preço do vinho também mostra sua correlação.
ggplot(vinho,aes(x = AGST, y = preço)) + geom_point() +geom_smooth(método = "lm")
ggplot(vinho,aes(x = Colheita e chuva, y = preço)) + geom_point() +geom_smooth(método = "lm")
Crie um modelo de regressão multilinear
model1 <- lm(Preço ~ AGST + HarvestRain,data = wine)
resumo(model1)
Produção:
##
## Ligar:
## lm(fórmula = Preço ~ AGST + HarvestRain, data = wine)
##
## Resíduos:
## Mín. 1Q Mediana 3Q Máx.
## -0.88321 -0.19600 0.06178 0.15379 0.59722
##
## Coeficientes:
## Estimativa Std. Valor t de erro Pr(>|t|)
## (Interceptar) -2.20265 1.85443 -1.188 0.247585
## AGST 0.60262 0.11128 5.415 1.94e-05 ***
## HarvestRain -0.00457 0.00101 -4.525 0.000167 ***
## ---
## Signif. códigos: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Erro padrão residual: 0.3674 sobre 22 graus de liberdade
## R-quadrado múltiplo: 0.7074, R-quadrado ajustado: 0.6808
## Estatística F: 26.59 sobre 2 e 22 DF, valor p: 1.347e-06
Interpretação do modelo
## Coeficientes:
## Estimativa Std. Valor t de erro Pr(>|t|)
## (Interceptar) -2.20265 1.85443 -1.188 0.247585
## AGST 0.60262 0.11128 5.415 1.94e-05 ***
## HarvestRain -0.00457 0.00101 -4.525 0.000167 ***
## Signif. códigos: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
B0 = 98.7147 (E- interceptar)
B1 = 0.9709 (Coeficiente de idade)
Preço = -2.20265 + 0.60262 AGST - 0.00457 HarvestRain
Isso significa que uma mudança em uma unidade na AGST trará 0,60262 unidades para mudar no preço e uma mudança de unidade no HarvestRain trará 0,00457 unidades para alterar o preço.
Erro padrão é a variabilidade esperada no coeficiente que captura a variabilidade da amostragem, então a variação na interseção pode ser de até 1.85443 e a variação no AGST será 0.11128 e a variação em HarvestRain é 0.00101 não mais do que isso
Valor T: o valor t é o coeficiente dividido pelo erro padrão, é basicamente o quão grande é estimado em relação ao erro, quanto maior o coeficiente em relação ao Std. erro, maior será o t-score e o t-score vem com um valor p porque é uma distribuição. O valor p é o quão estatisticamente significativa a variável é para o modelo para um nível de confiança do 95% vamos comparar este valor com alfa para ser 0.05, então, em nosso caso, o valor p da interseção, AGST e HarvestRain são menores que alfa (alfa = 0.05), isso implica que todos são estatisticamente significativos para o nosso modelo.
## Erro padrão residual: 0.3674 sobre 22 graus de liberdade
## Múltiplos quadrados R: 0,7074, R quadrado ajustado: 0,6808
## Estatística F: 26.59 sobre 2 e 22 DF, valor p: 1.347e-06
Erro padrão residual ou o erro padrão do modelo é basicamente o erro médio do modelo que é 0.3674 em nosso caso e significa que nosso modelo pode ter uma diferença média de 0.3674 ao prever o preço dos vinhos. Quanto menor o erro, melhor será o modelo ao prever.
Múltiplos R-quadrados é a razão para (1- (soma do quadrado do erro / soma do quadrado total))
R quadrado ajustado:
Se adicionarmos variáveis, não importa se é significativo na previsão ou não, o valor de R ao quadrado aumentará, razão pela qual o R quadrado ajustado é usado, porque se a variável agregada não for significativa para a previsão do modelo, o valor R ajustado - quadrado irá reduzir, é uma das ferramentas mais úteis para evitar overfitting do modelo.
F – Estatisticas é a razão entre o quadrado médio do modelo e o quadrado médio do erro, Em outras palavras, é a razão de quão bem o modelo está funcionando e o que está causando o erro, e quanto maior o valor F, melhor o modelo está funcionando em comparação com o erro.
Dois são os graus de liberdade do numerador da estatística F e 22 é o grau de liberdade dos erros.
Valores de previsão para nosso conjunto de testes
predição <- prever(model1, newdata = wine_test)
Valores previstos com o conjunto de dados de teste
degustação de vinho
## Ano Preço Inverno Chuvas AGST Colheita Idade das chuvas França Pop
## 1 1979 6.9541 717 16.1667 122 4 54835.83
## 2 1980 6.4979 578 16.0000 74 3 55110.24
predição
## 1 2
## 6.982126 7.101033
conclusão
Como podemos ver, a partir do conjunto de dados disponível, podemos criar um modelo de regressão linear e treinar esse modelo, se houver dados suficientes disponíveis, podemos prever com precisão novos eventos ou, Em outras palavras, resultados futuros.





