
Este artigo foi publicado como parte do Data Science Blogathon.
Aviso: este artigo é para iniciantes absolutos, Acho que você acabou de entrar no campo do aprendizado de máquina com algumas habilidades matemáticas do ensino médio e alguns códigos básicos, mas isso nem é obrigatório.
Introdução
A regressão linear é o algoritmo de aprendizado de máquina supervisionado mais básico. Monitore no sentido de que o algoritmo pode responder à sua pergunta com base nos dados marcados que você fornece ao algoritmo. A resposta seria como prever os preços das casas, classifique cães versus gatos. Aqui vamos falar sobre uma tarefa de regressão usando regressão linear. Ao final, vamos prever os preços das casas com base na área da casa.
Não quero aborrecê-lo jogando fora todas as palavras do jargão do aprendizado de máquina, no princípio, então deixe-me começar com a equação linear mais básica. (y = mx + b) que todos nós sabemos de nossos dias de escola.
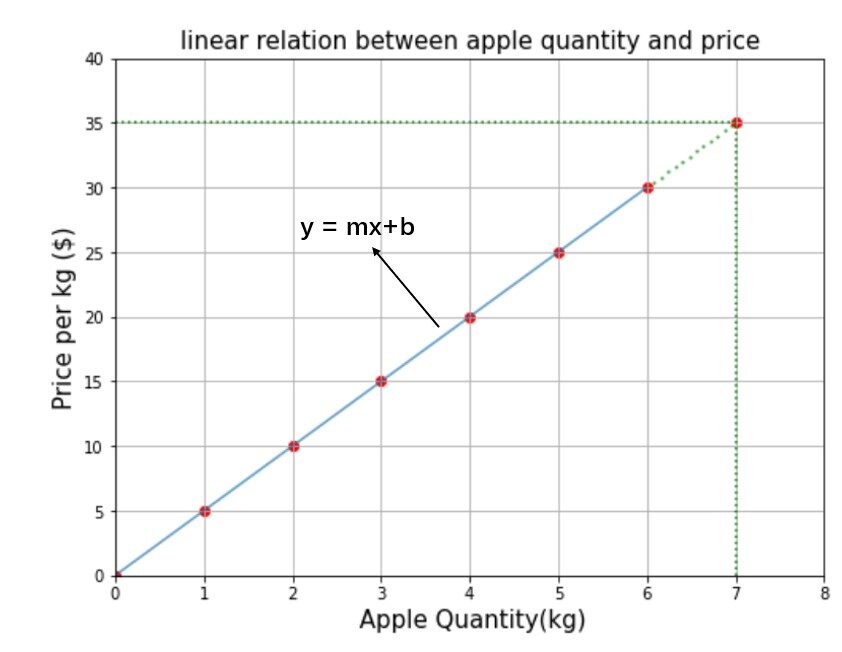
o figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... anterior muestra la relación entre la cantidad de manzana y el precio de costo. Quanto voce tem que pagar por 7 kg de maçãs? Eu sei que é fácil. E 1 custos de kg 5 $, então 7 custo de kg 7 * 5 = 35 $ ou vai apenas desenhar uma linha perpendicular do ponto 7 ao longo do eixo y até tocar a equação linear e o valor correspondente no eixo y é a resposta conforme mostrado. pela linha verde pontilhada no gráfico. Mas vamos resolver usando a fórmula de uma equação linear.

Agora, se eu tiver que encontrar o preço de 9,5 kg de maçã, de acordo com nosso modelo mx + b = 5 * 9.5 + 0 = $ 47.5 é a resposta. A estas alturas, você pode ter entendido que metro e B são os principais ingredientes da equação linear ou em outras palavras metro e B Eles são chamados parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.....
Infelizmente, este não é o problema de aprendizado de máquina, nem a equação linear é um algoritmo de previsão, mas felizmente a regressão linear gera o resultado da mesma forma que a equação linear. O principal objetivo do algoritmo de regressão linear é encontrar o valor de metro e B que se encaixam no modelo e depois disso metro e b são usados para prever o resultado dos dados de entrada fornecidos.
Previsão de preços de imóveis
Agora vamos cavar um pouco mais fundo na solução do problema de regressão. Olhe para as amostras de dados ou também denominado como ejemplos de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... dado na figura abaixo.
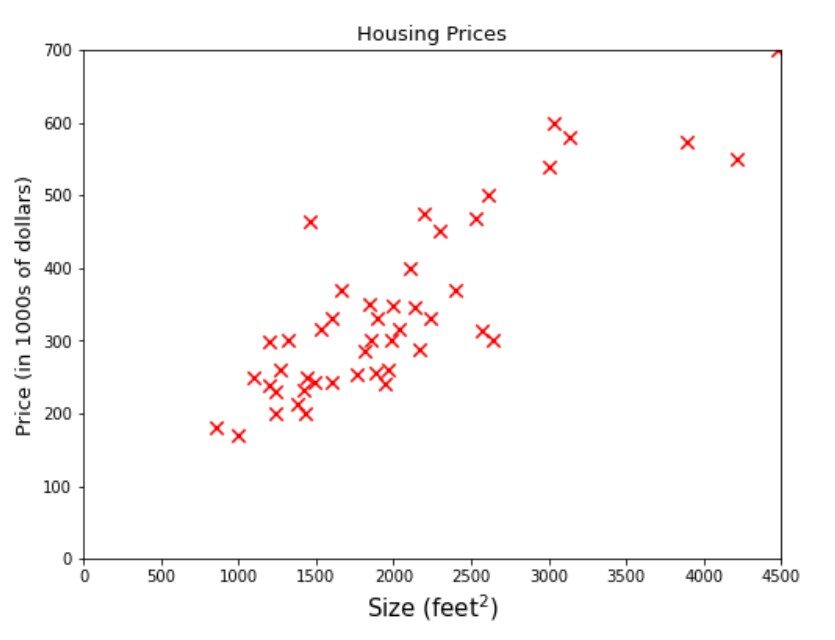
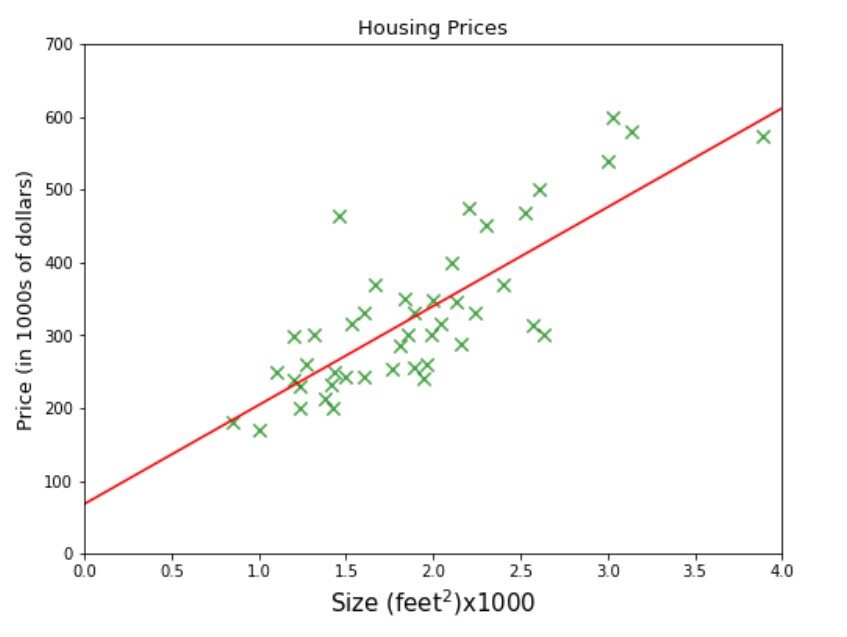
O nome de uma empresa A B C fornece a você um dados sobre ele tamanho da casa e seu preço. A empresa exige fornecendo-lhes um modelo de aprendizado de máquina que pode prever preços de casas para qualquer dado Tamanho. Digamos qual seria o melhor preço estimado para uma área de 3000 pés quadrados. Se você está pensando em enrolar uma linha em algum lugar entre o conjunto de dados e desenhe uma linha vertical de 3000 no eixo x até tocar a linha e então o valor correspondente no eixo y, quer dizer 470 seria a resposta, então você está no caminho certo, é representado pela linha pontilhada verde na figura abaixo.
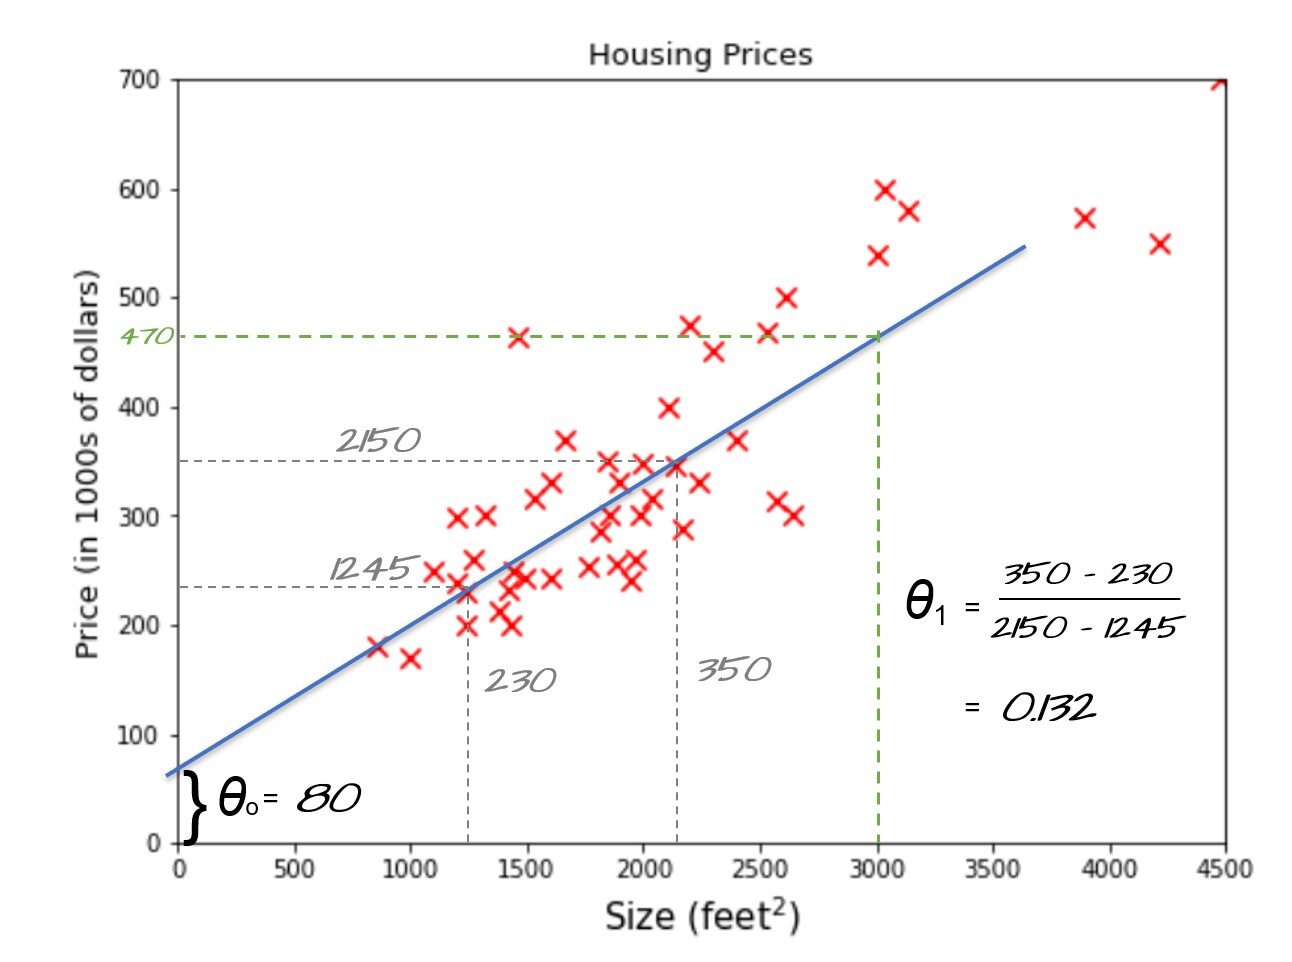
Vamos fazer de outra maneira, se pudéssemos encontrar a equação da linha y = mx + b que usamos para ajustar os dados representados pela linha azul inclinada, então podemos encontrar facilmente o modelo que pode prever os preços das casas para qualquer área. . Com base no jargão do aprendizado de máquina y = mx + b Também é chamado função de hipótese Onde myb pode ser representado por theta0 e theta1 respectivamente. theta0 também é chamado termo de viés e theta1, theta2, .. chamam-se pesos.
Veja a linha azul na imagem acima. Ao tirar duas amostras que estão se tocando ou muito perto da linha, podemos encontrar o theta1 (pendente) = 0.132 e zero theta = 80 como mostra a imagem. Agora podemos usar nossa função de hipótese para prever o preço da casa para um tamanho de 3000 pés quadrados, quer dizer. 80 + 3000 * 0,132 = 476. $ 476,000 poderia ser o melhor preço estimado para uma casa de 3000 metragem quadrada e esta pode ser uma maneira razoável de preparar um modelo de aprendizado de máquina quando você terminar 50 amostras e com apenas uma característica (Tamanho).
Mas o conjunto de dados do mundo real pode ser da ordem de milhares ou mesmo milhões e o número de recursos pode variar entre (5–100) ou mesmo em milhares. Naquela época, nossa intuição não será útil para encontrar milhares de parâmetros apenas olhando para um conjunto de dados, é por isso que precisamos de um algoritmo de aprendizado de máquina para realizar um cálculo tão complexo. tomar uma xícara de café, refresque-se e volte novamente porque a partir de agora você entenderá como o algoritmo funciona e será apresentado a uma série de novas terminologias. Se prepare!!
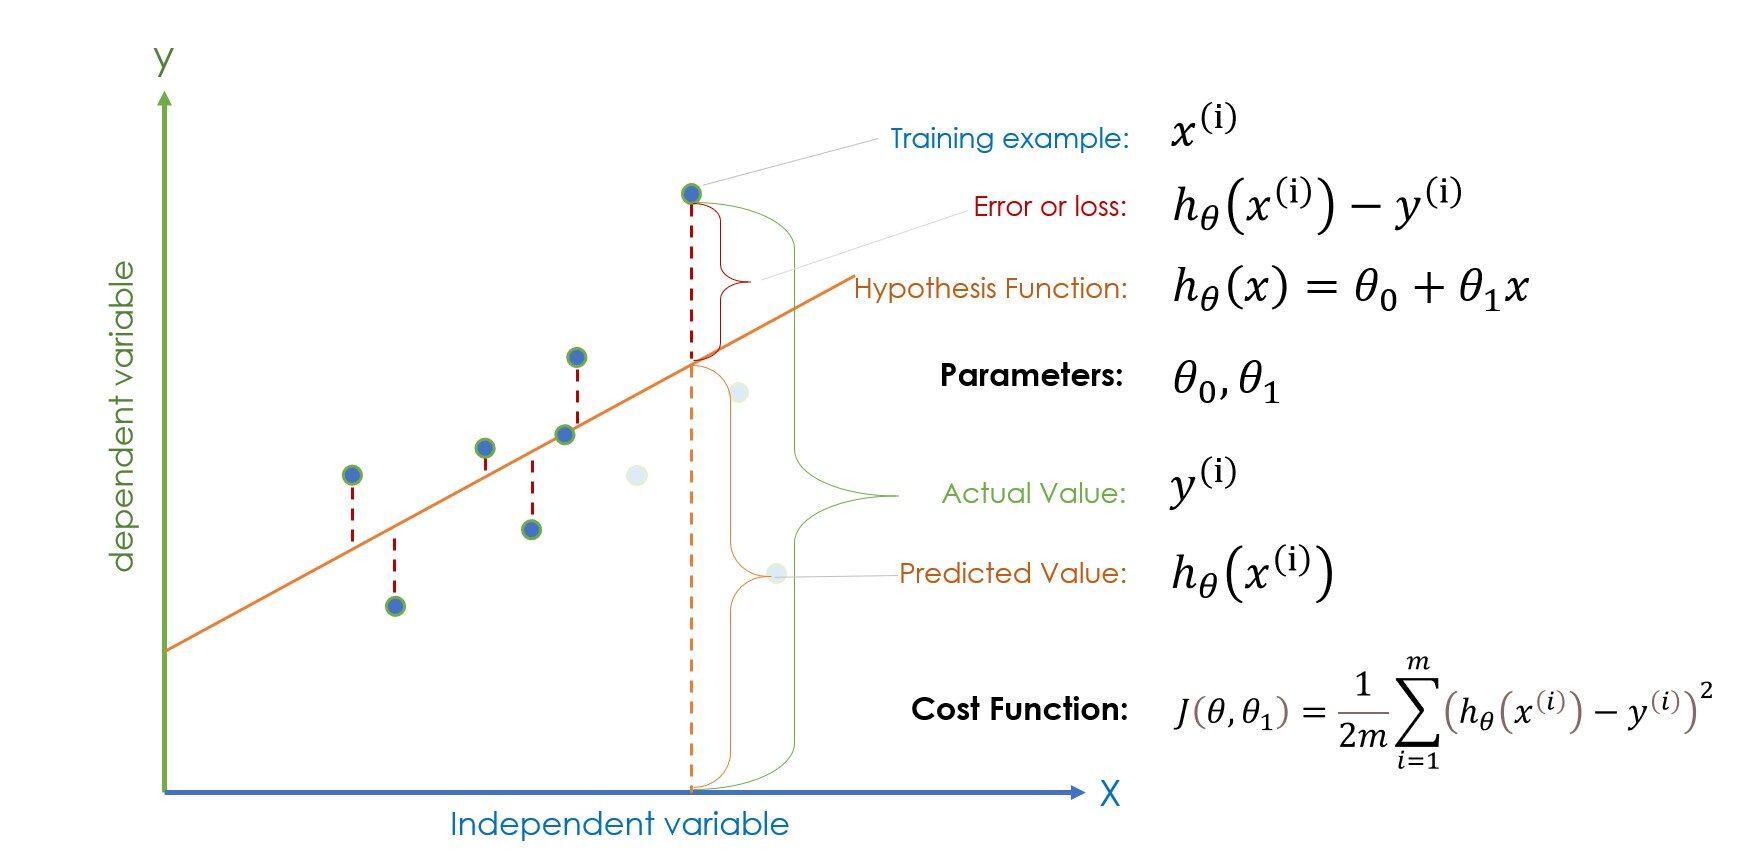
Observação: (eu) na equação representa o i-ésimo exemplo de treinamento, não o poder.
Se as terminologias fornecidas na figura acima parecem extraterrestres para você, reserve alguns minutos para se familiarizar e tente encontrar uma conexão para cada termo. Se você sabe até certo ponto, vamos continuar. Uma vez que os valores do parâmetro, quer dizer termo de viés e theta1 se inicializan aleatoriamente, a função de hipótese está pronta para predição, e então o erro (|valor predito – valor atual|) é calculado para verificar se o parâmetro inicializado aleatoriamente está fornecendo a previsão correta ou não.
Se o erro for muito alto, então o algoritmo atualiza os parâmetros com um novo valor, se o erro for alto novamente, irá atualizar os parâmetros com o novo valor novamente. O algoritmo continua este processo até que o erro seja minimizado. Para minimizar o erro temos uma função especial chamada Declínio de gradienteGradiente é um termo usado em vários campos, como matemática e ciência da computação, descrever uma variação contínua de valores. Na matemática, refere-se à taxa de variação de uma função, enquanto em design gráfico, Aplica-se à transição de cores. Esse conceito é essencial para entender fenômenos como otimização em algoritmos e representação visual de dados, permitindo uma melhor interpretação e análise em... mas antes disso, vamos entender o que Função de custo é e como funciona?
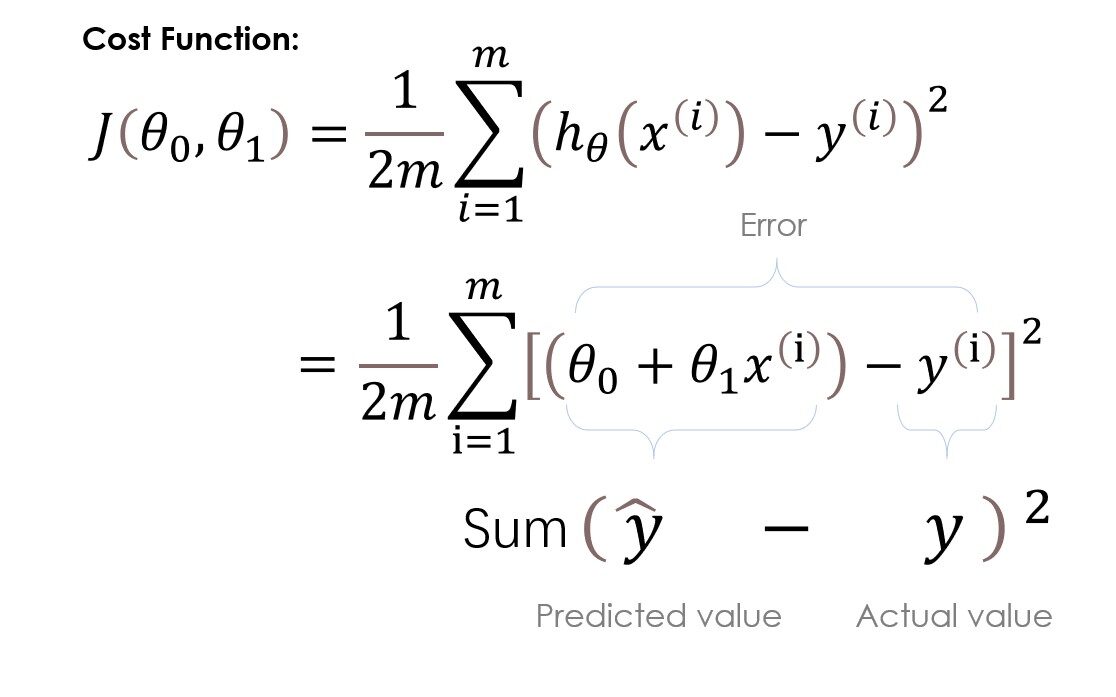
Aqui, na função de custo, estamos tentando encontrar o quadrado do diferenças entre o valor previsto e o valor real de cada exemplo de treinamento e, em seguida, adicione todos os diferenças juntos ou em outras palavras, estamos encontrando o quadrado do erro de cada exemplo de treinamento e, em seguida, resuma todos os erros juntos. A saída que obtemos é simplesmente a média erro quadrado de um determinado conjunto de parâmetros. OK, sem mais palavras, vamos fazer o cálculo. Para simplificar o cálculo, vamos usar apenas um parâmetro theta1 e um conjunto de dados muito simples.
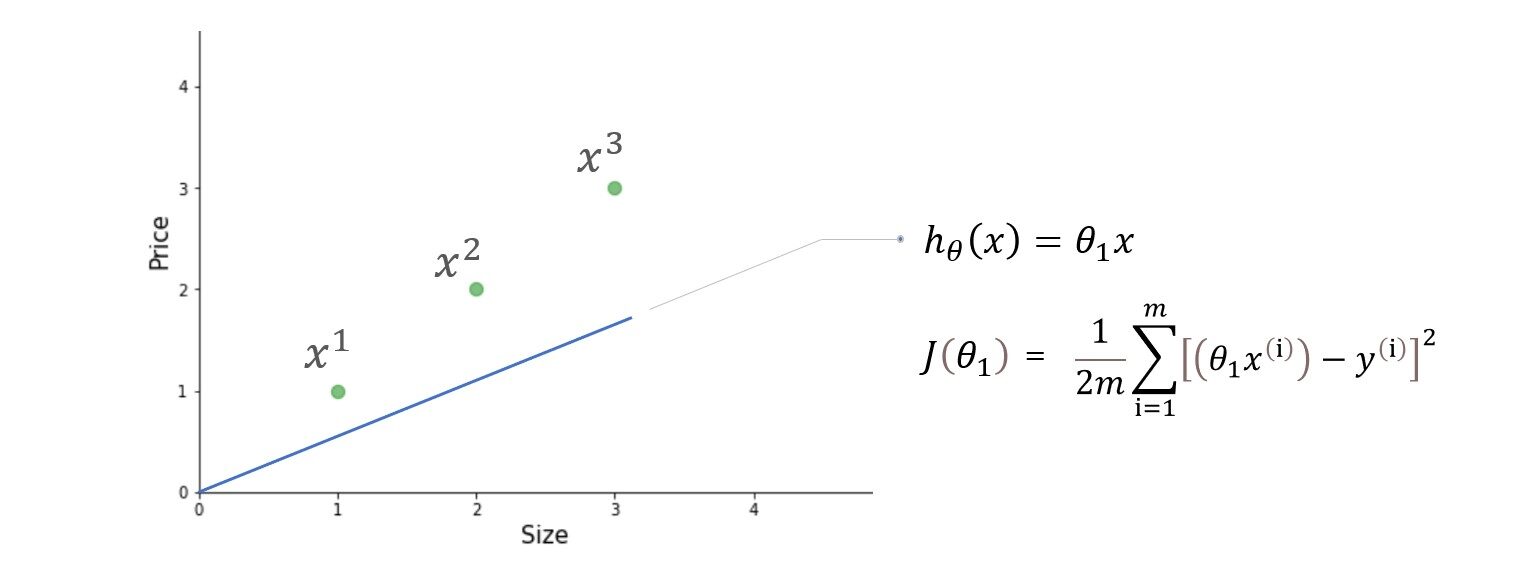
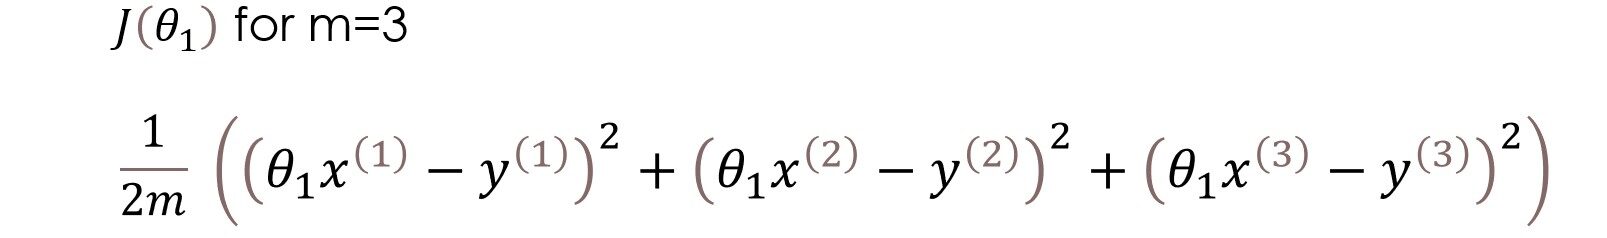
Temos três exemplos de treinamento (X1 = 1, y1 = 1), (X2 = 2, y2 = 2) e (X3 = 3, y3 = 3). a figura à esquerda é a função de hipótese e a figura à direita é a função de custo representada graficamente para diferentes valores do parâmetro.
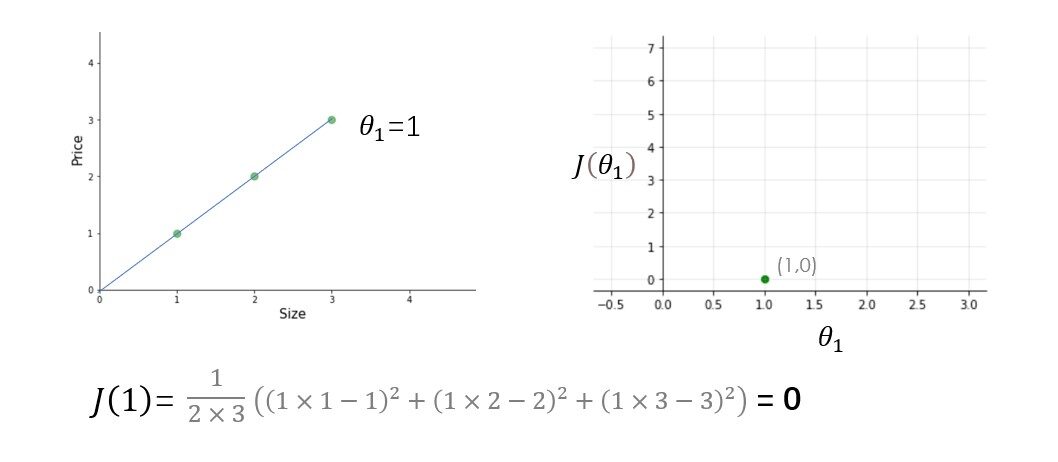
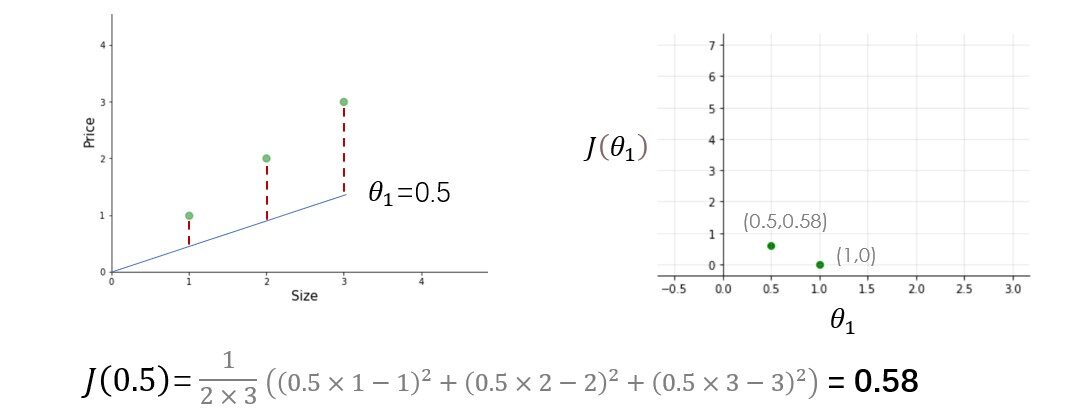
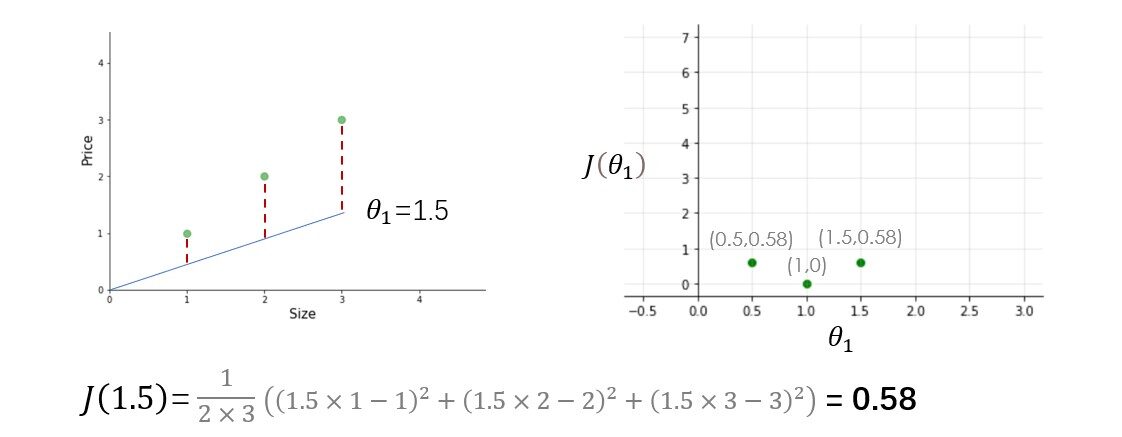
Experimente outros valores de theta1 você mesmo e calcule o custo de cada valor de theta1. Depois de desenhar todos esses pontos, a função de custo será semelhante a uma curva em forma de tigela, conforme mostrado na figura abaixo.
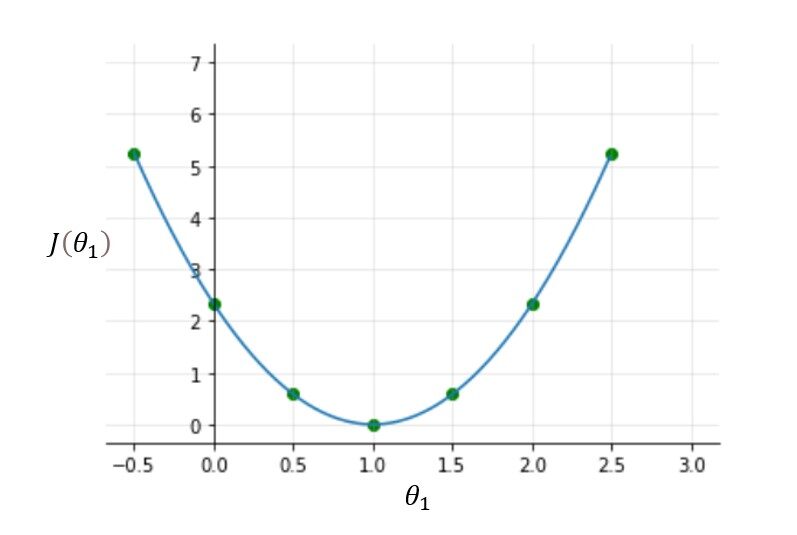
Da figura e do cálculo, é claro que a função de custo é mínima em theta1 = 1 ou na parte inferior da curva em forma de tigela. O objetivo de todo esse trabalho árduo não é calcular o valor mínimo da função de custo, nós temos uma maneira melhor de fazer isso, em seu lugar, tentamos entender o relação Entre parametros, função de hipótese, e função de custo. Certifique-se de compreender todos esses conceitos antes de prosseguir..
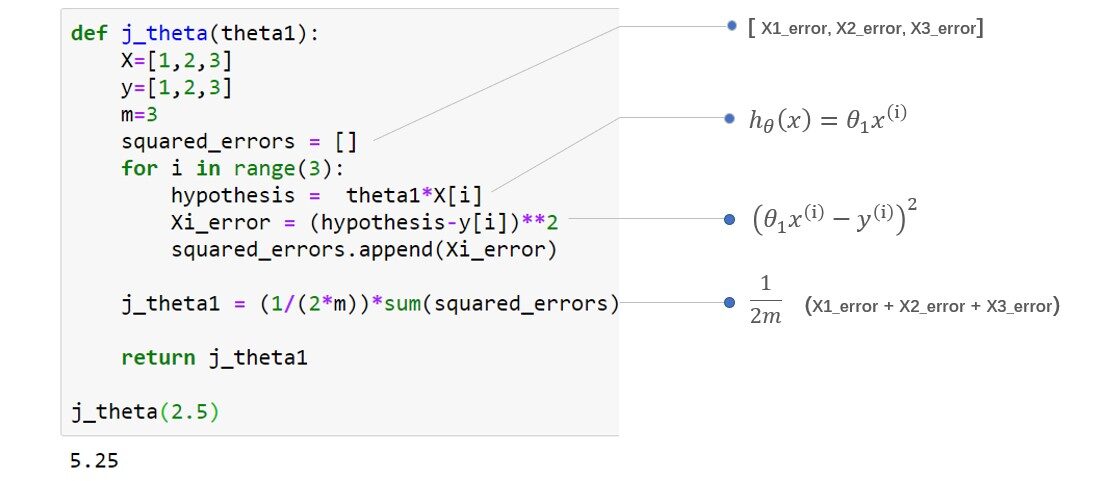
Função de custo de codificação:
Gradiente descendente:
Por que precisamos de uma descida gradiente?
- Em breve para minimizar a função de custo, Mas como? Vamos a ver
A função de custo só funciona quando você conhece os valores dos parâmetros. No exemplo de exemplo acima, nós escolhemos manualmente o valor dos parâmetros a cada vez, mas durante o cálculo algorítmico, uma vez que os valores dos parâmetros são inicializados aleatoriamente, é a descida do gradiente que deve decidir quais parâmetros. valor a ser escolhido na próxima iteração para minimizar o erro, é a descida do gradiente que decide quanto aumentar ou diminuir os valores dos parâmetros.
Analogia: Como funciona o Gradient Descent?
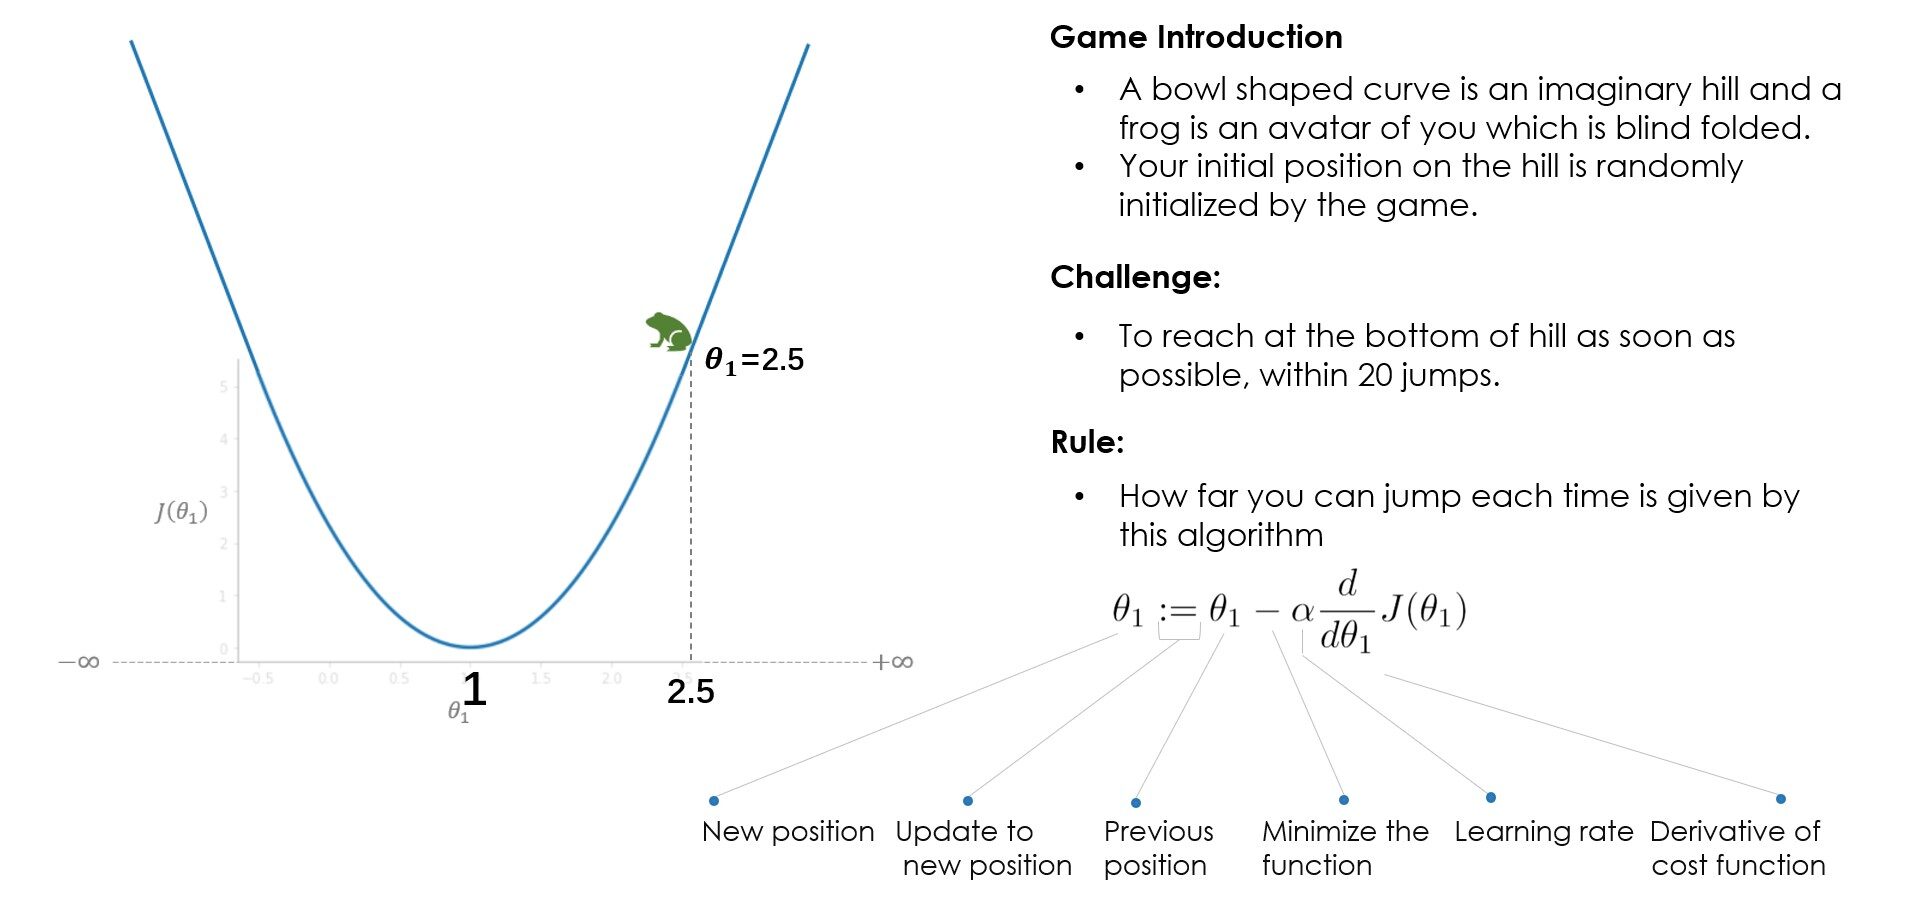
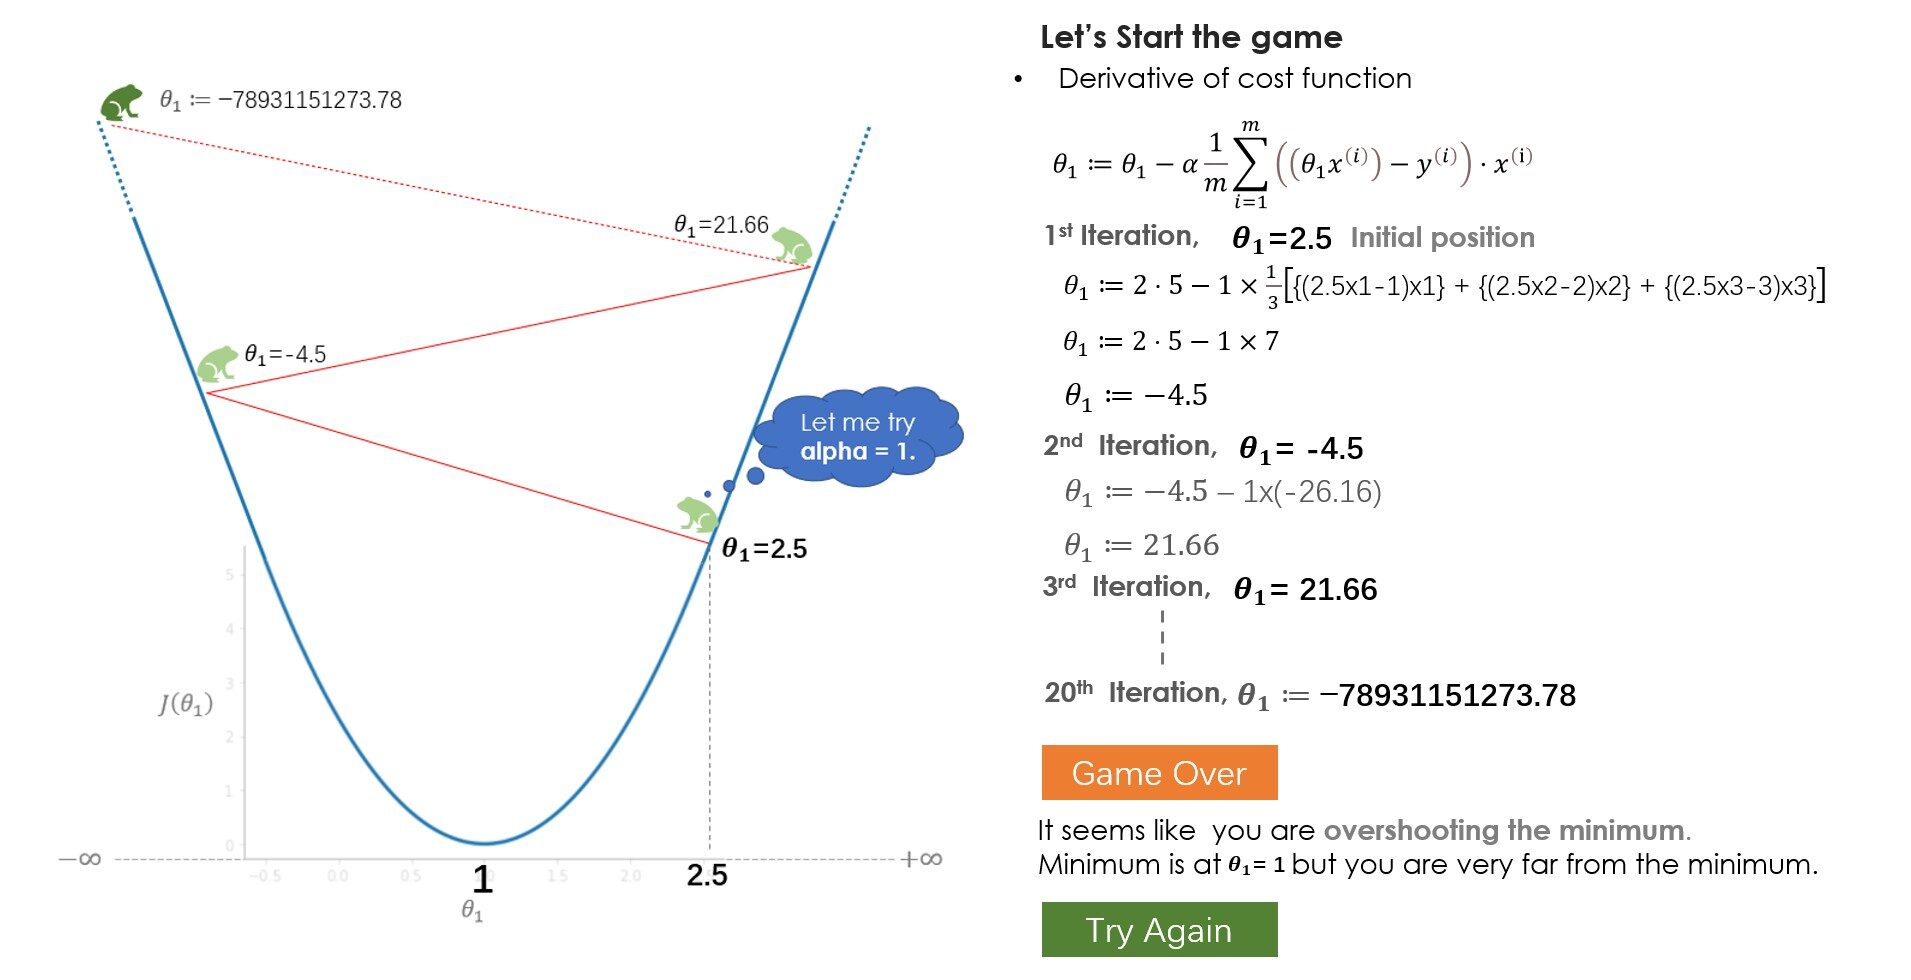
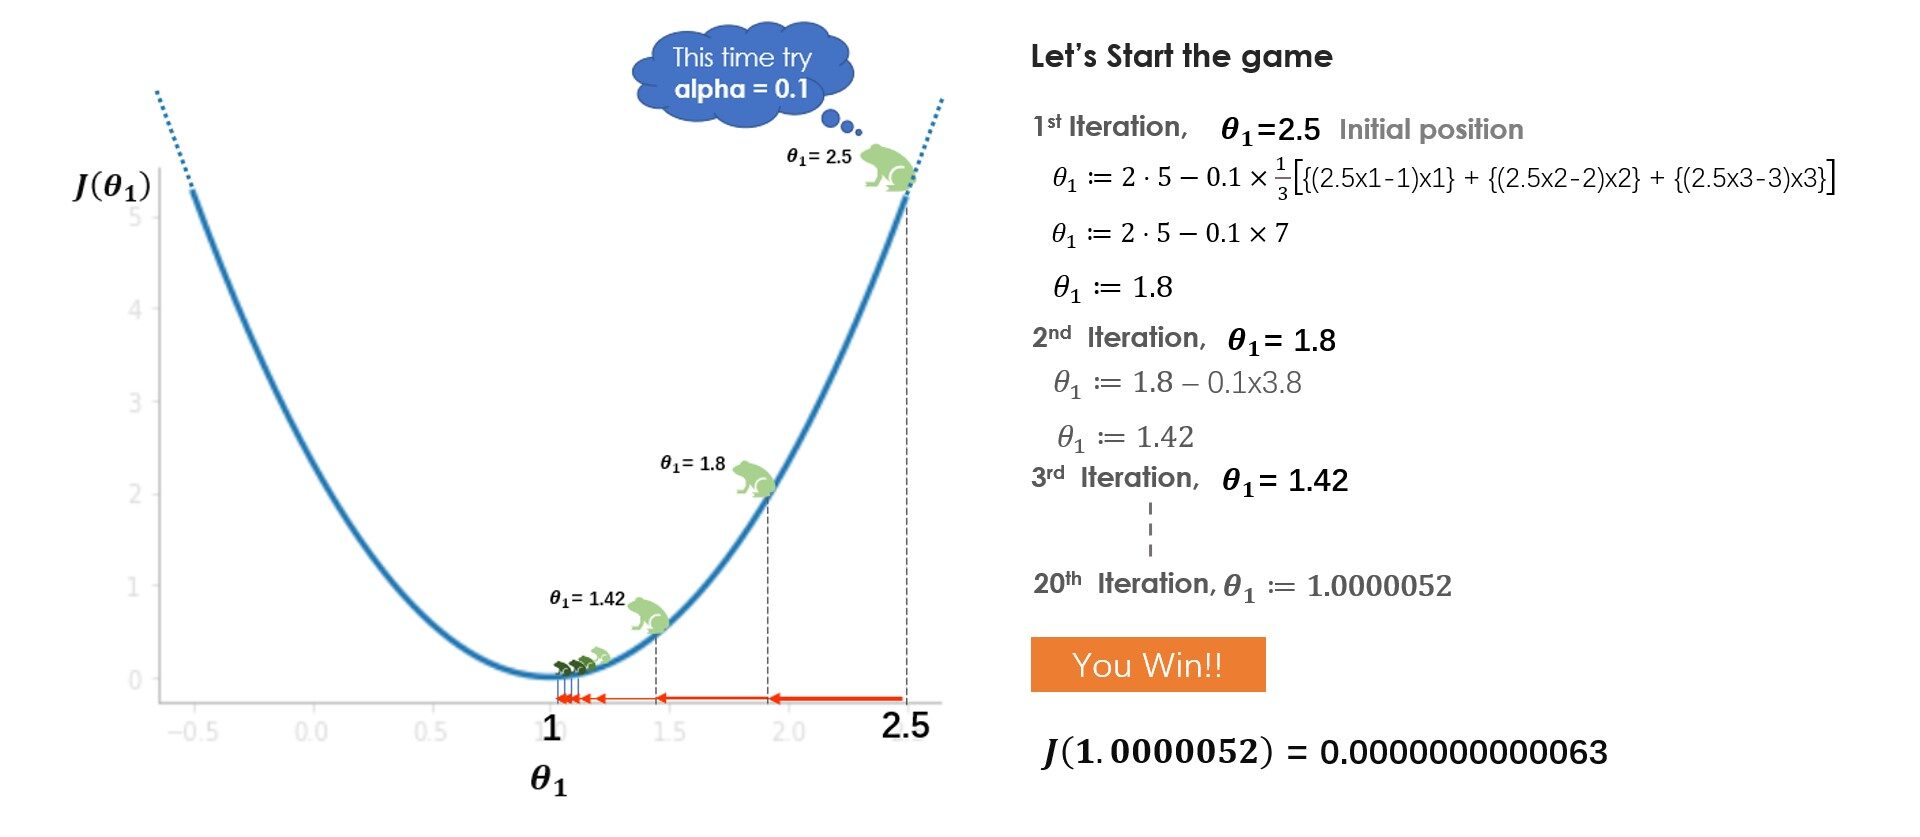
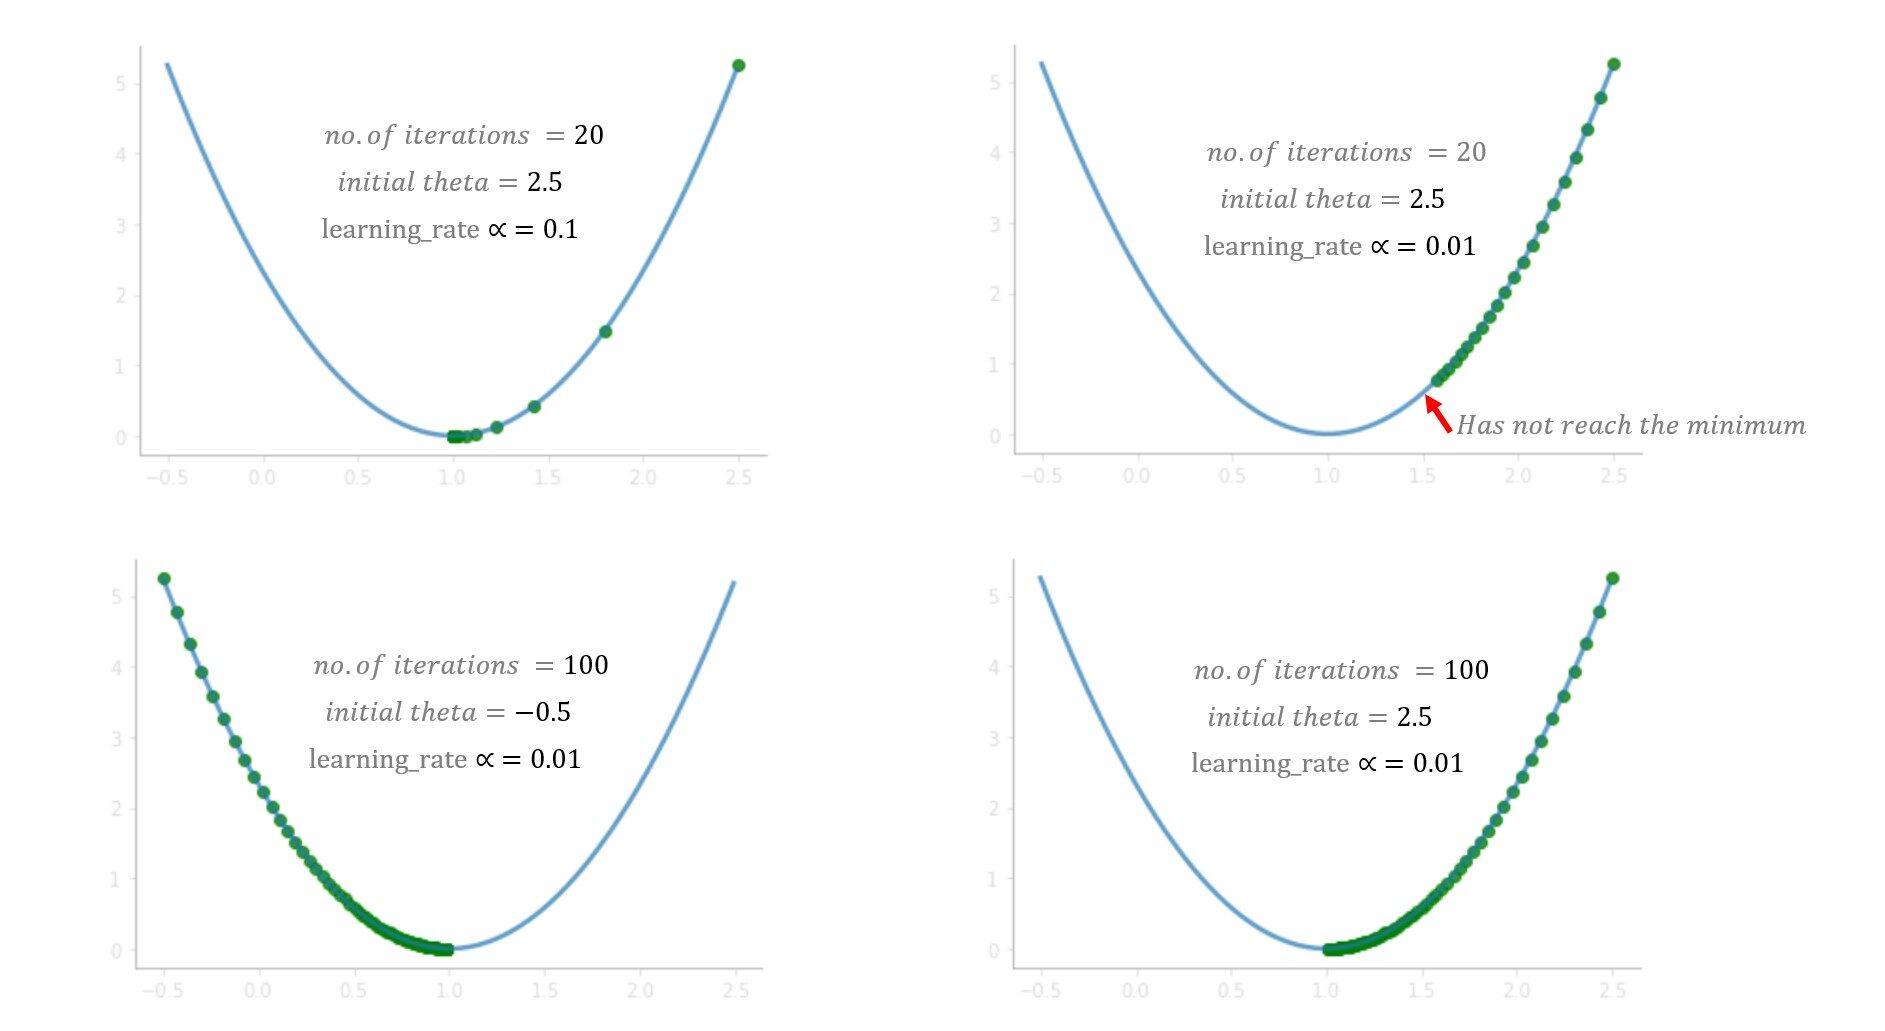
O que você aprendeu com o jogo? No princípio, você tenta uma taxa de aprendizagem (alfa) = 1 mas você não alcança o mínimo, porque os passos maiores excedem o mínimo. No próximo jogo, você tenta com alfa = 0.1, e desta vez você conseguiu chegar ao fundo com muita segurança. E se você tivesse tentado alfa = 0.01? Nós vamos, nesse caso, você vai descer gradualmente, mas não vai chegar ao fundo, 20 saltos não são suficientes para chegar ao fundo com alfa = 0.01, 100 saltos podem ser o suficiente. Ao resolver um problema do mundo real, normalmente um alfa entre 0,01–0,1 deve funcionar bem, mas varia com o número de iterações que o algoritmo realiza, alguns problemas podem exigir 100 o incluso 1000 iterações.
Com base nesses fatores, você pode tentar diferentes valores alfa. Embora ajustar o valor alfa seja uma das tarefas importantes para entender o algoritmo, Eu sugiro que você olhe para outras partes do algoritmo, bem como as partes derivadas, o sinal de menos, atualizar parâmetros e compreender quais são as funções de seus indivíduos.
Gradiente de codificação descendente
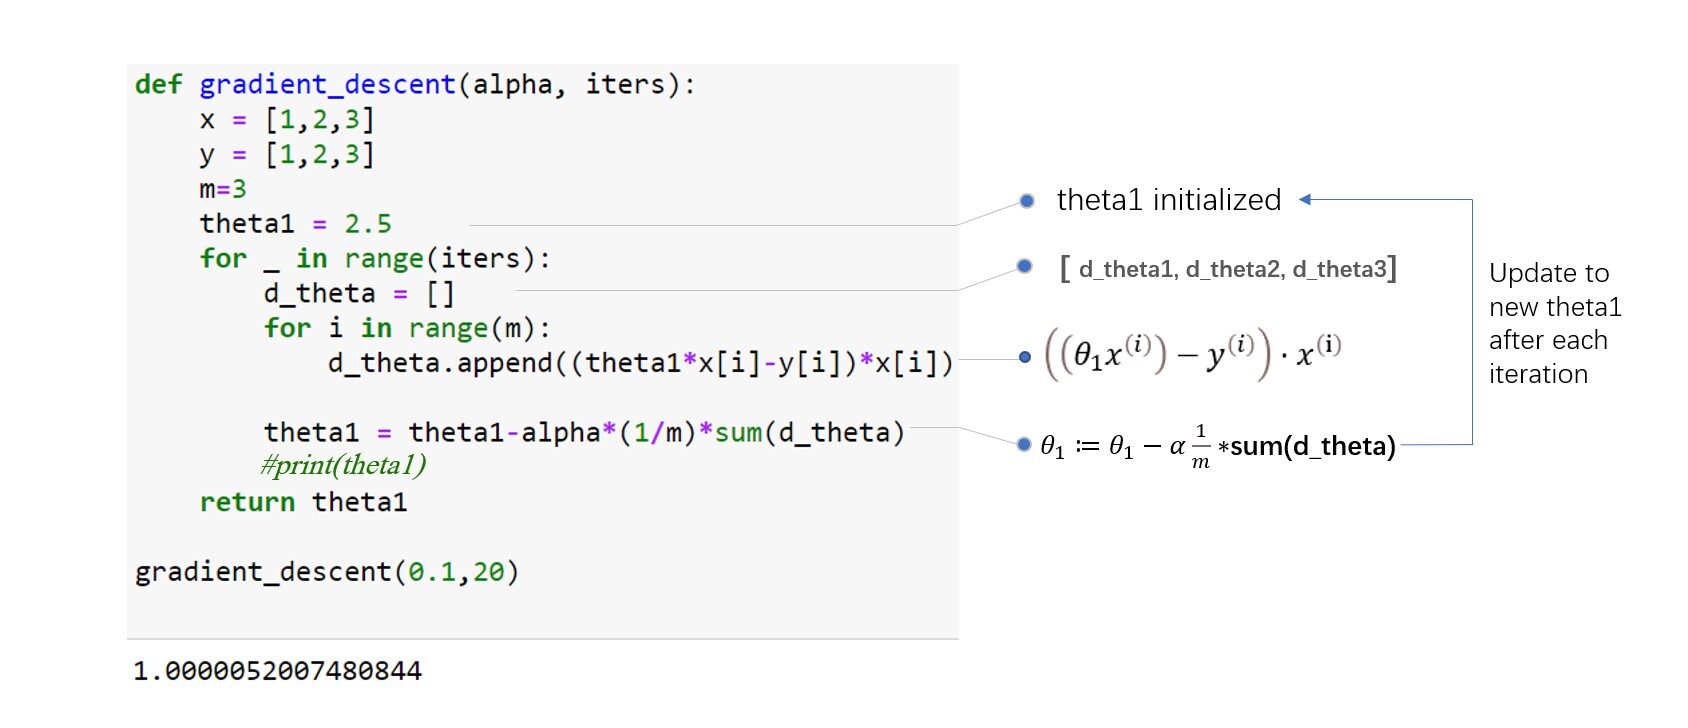
Até agora, estamos usando apenas um único parâmetro para calcular a função de custo e os algoritmos. Qual é a aparência da função de custo e como o algoritmo funciona quando temos dois ou mais parâmetros? Veja a figura abaixo para uma compreensão intuitiva. Imagine-se em algum lugar no topo da montanha e lutando para descer a base da montanha com os olhos vendados..
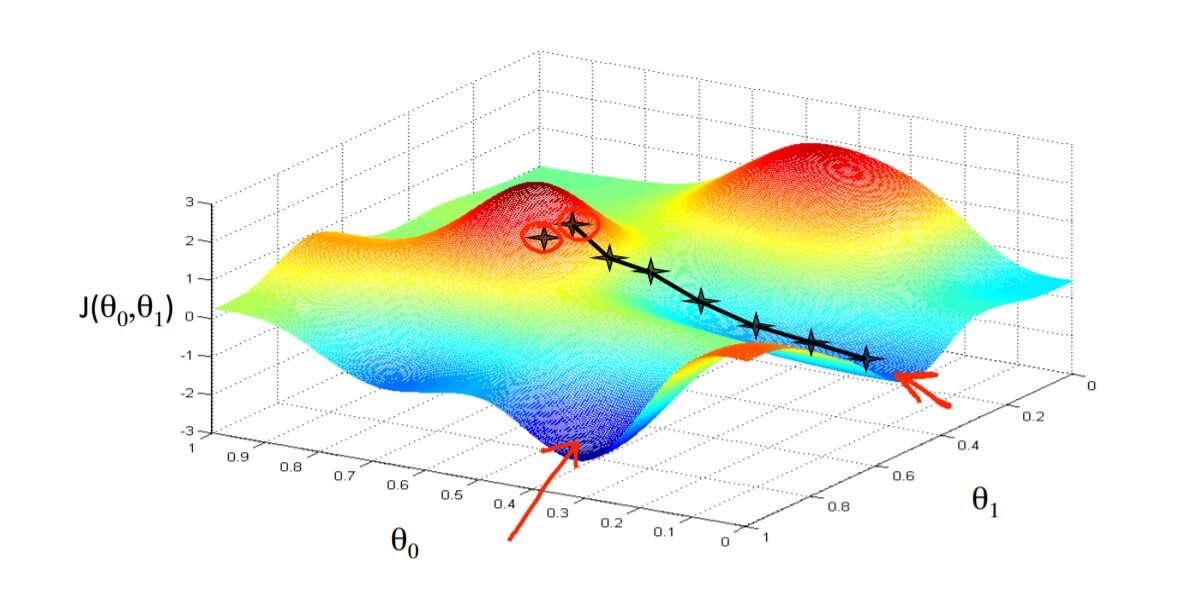
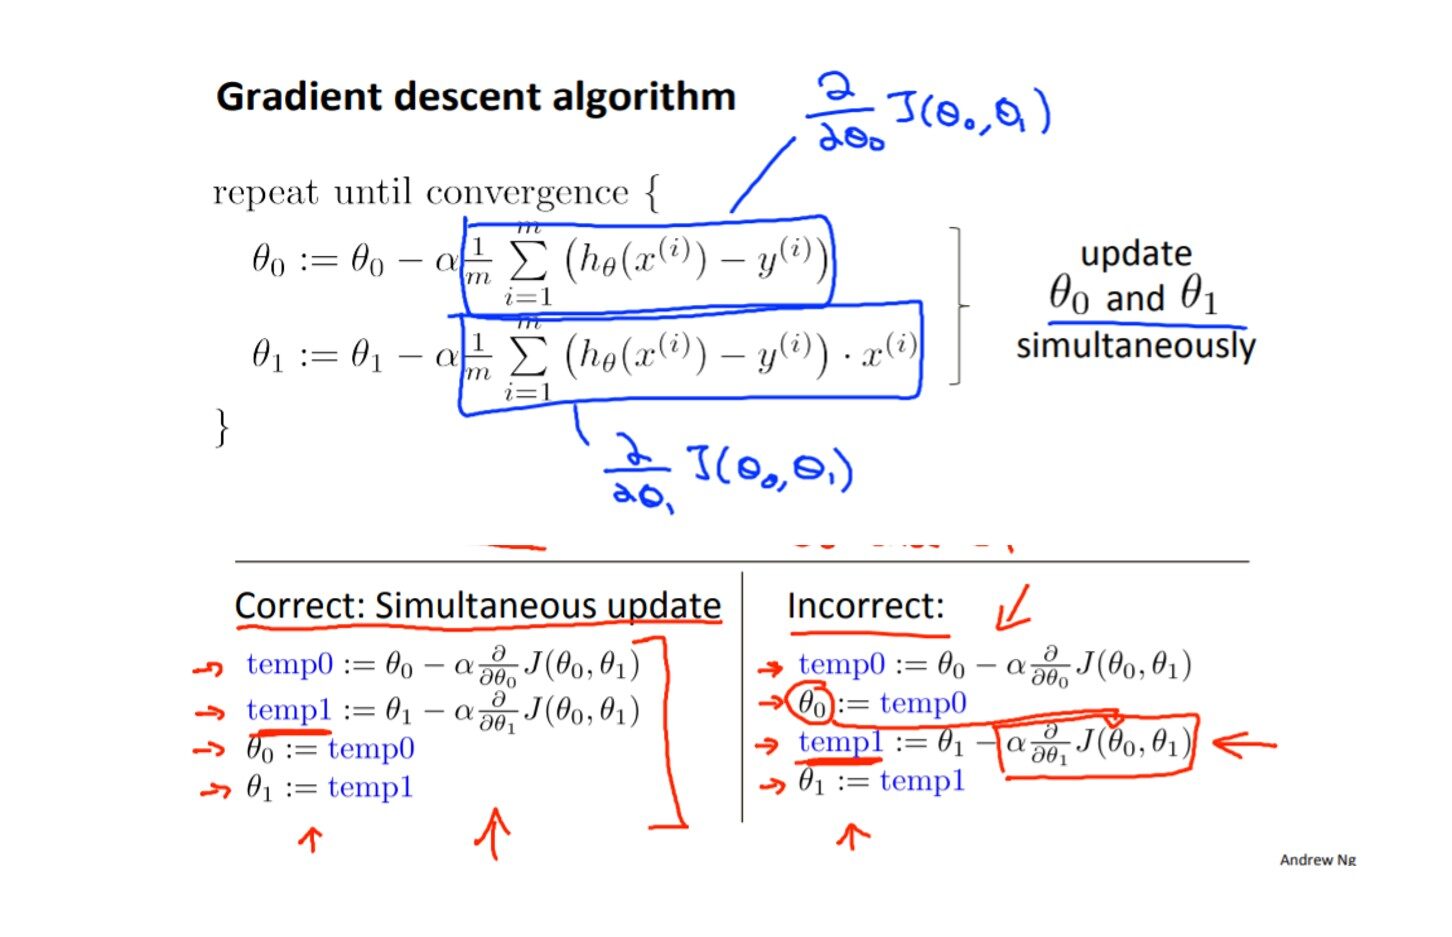
O princípio de operação do algoritmo é o mesmo para qualquer número de parâmetros, é só que quanto mais parâmetros mais a direção da inclinação. No exemplo acima da curva em forma de tigela, só precisamos observar a inclinação de theta1, mas agora o algoritmo deve olhar em ambas as direções para minimizar a função de custo. Vamos codificar e entender o algoritmo. Consulte a figura abaixo para referência:
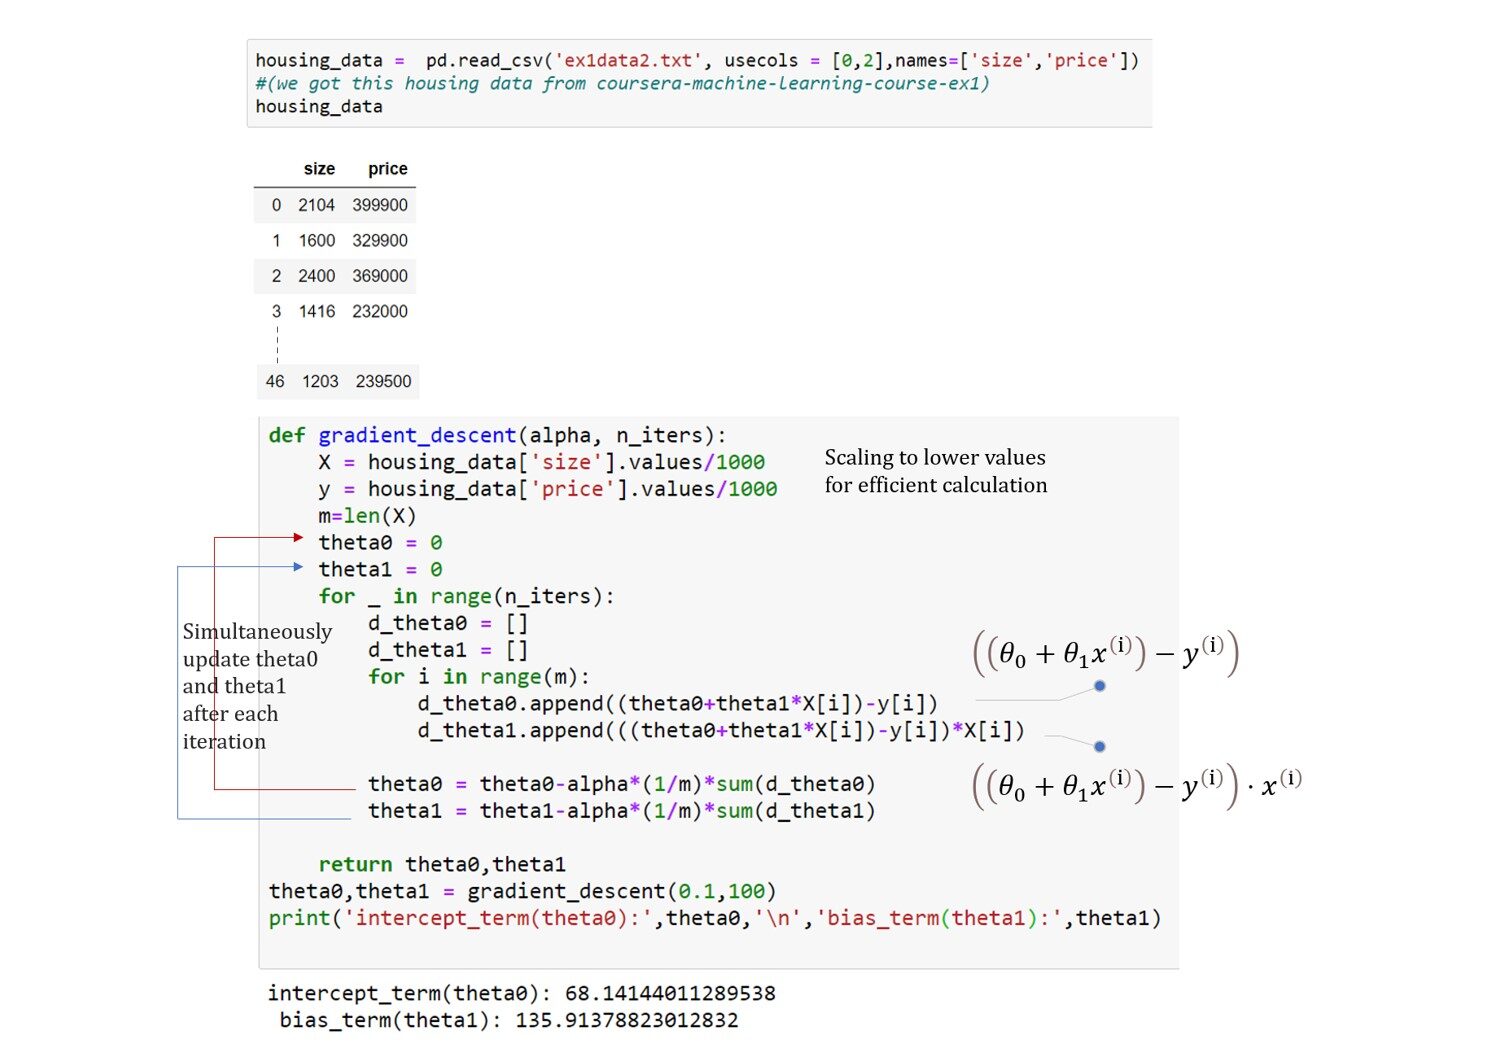
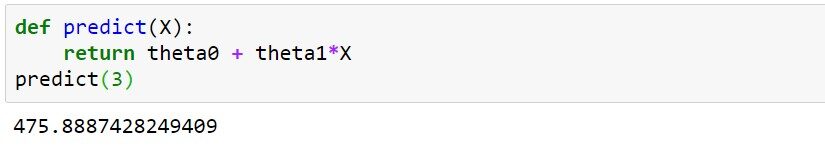
Aqui vamos nós, nosso modelo prevê 475,88 * 1000 = $ 475,880 para o tamanho da casa 3 * 1000 pés quadrados. Está muito próximo de nossa previsão que fizemos no início usando nossa intuição.
conclusão
Como um iniciante, pode ser um pouco difícil entender todos os conceitos de regressão linear em um tempo de leitura tão curto. Eu não diria que você sabe tudo sobre regressão linear deste artigo. O objetivo deste artigo é tornar os algoritmos compreensíveis da maneira mais simples possível. Siga o link do recurso abaixo para uma melhor compreensão. Eu espero que você tenha gostado de ler o artigo. Obrigado pela leitura.
Meios:
link de código
https://github.com/ravi235/LinearRegression
Gradiente descendente matemática
https://www.youtube.com/watch?v=jc2IthslyzM&ab_channel=TheCodingTrain
Regressão Linear Andrew Ng
https://www.youtube.com/watch?v=kHwlB_j7Hkc&t=8s&ab_channel=ArtificialIntelligence-AllinOne





