
Introdução
Olá a todos, por esta introdução útil ao aprendizado de máquina usando regressão linear simples.. Então vamos começar:
Então, vamos nos familiarizar com os termos que serão usados:
Aprendizado de máquina (ML): ML é um aplicativo de Inteligência Artificial (ELE) que dá aos sistemas a capacidade de aprender e melhorar automaticamente com a experiência, sem ser explicitamente programado. O ML se concentra no desenvolvimento de programas de computador que podem acessar dados e usá-los para aprender por si próprios.
Conjunto de dados: Uma coleção de conjuntos de informações relacionados que são compostos de elementos separados, mas que podem ser manipulados como uma unidade por um computador.
Visualização de dados: É uma representação de dados ou informações em um gráfico, gráfico ou outros formatos visuais que são úteis para análise, como análise preditiva, que pode servir como uma visualização útil para apresentar.
Limpeza de dados: É o processo de correção ou remoção de dados incorretos, corrupto, formatado incorretamente, duplicados ou incompletos em um conjunto de dados.
Aprendizagem supervisionadaO aprendizado supervisionado é uma abordagem de aprendizado de máquina em que um modelo é treinado usando um conjunto de dados rotulados. Cada entrada no conjunto de dados está associada a uma saída conhecida, permitindo que o modelo aprenda a prever resultados para novas entradas. Este método é amplamente utilizado em aplicações como classificação de imagens, Reconhecimento de fala e previsão de tendências, destacando sua importância em...: O modelo é treinado usando 'dados marcados'. Diz-se que os conjuntos de dados contêm etiquetas que contêm parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... de entrada e saída. Para simplificar: 'Os dados já estão marcados com a resposta correta'.
Regressão linear simples: É um Modelo de Regressão que estima a relação entre a variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... variável independente e a variável dependente usando uma linha reta [y = mx + c], onde ambas as variáveis devem ser quantitativas.
Modelos: Os resultados são obtidos por meio de algoritmos e são compostos por dados do modelo e um algoritmo de predição..
Modelo de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina....: Na aprendizagem supervisionada, um algoritmo de ML cria um modelo examinando muitos exemplos e tentando encontrar um modelo que minimize a perda e melhore a precisão da previsão.
Estes são os poucos termos usados neste artigo e com os quais você deve se familiarizar. Agora vamos começar com a análise e previsão do modelo. Neste tutorial, Vou usar dados supervisionados e regressão linear simples para análise e previsão. O objetivo final é prever a altura de uma pessoa e fornecer sua idade usando o modelo treinado com a maior precisão possível usando os dados disponíveis.. Eu usei a linguagem de programação universal favorita para ML, quer dizer. Piton para construir e treinar o modelo de ML e o ambiente do Google Colab.
As etapas envolvidas são:
1. Importação de conjunto de dados.
2. Visualização de dados
3. Limpeza de dados
4. Construir o modelo e treiná-lo
5.Faça previsões sobre dados invisíveis
——————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————————. ————————
1. Importação de conjunto de dados:
A primeira e mais importante coisa a fazer é importar o conjunto de dados. Temos vários sites que possuem esses conjuntos de dados para serem usados por qualquer pessoa. de forma similar, vamos começar a importar o conjunto de dados que vamos usar neste tutorial.

Esta única linha de código nos ajuda a obter os dados usados para o tutorial diretamente do URL.
Conjunto de dados <- Clique no link para obter o conjunto de dados, que é o URL mencionado acima.
2. Visualização de dados:
Nesta etapa, depois de importar os dados e montá-los com o Colab, vamos ter uma visão geral do conjunto de dados importando um módulo chamado pandas. Como o conjunto de dados que temos tem uma extensão .pkl, nós apenas vemos pela função disponível na biblioteca do pandas.
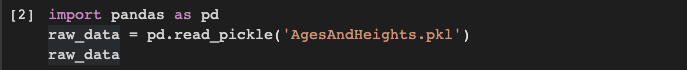
Importamos a biblioteca para ler o conjunto de dados e armazená-lo em uma variável chamada dados não tratados. Em seguida, mostramos o conteúdo de dados não tratados que está em formato tabulado.
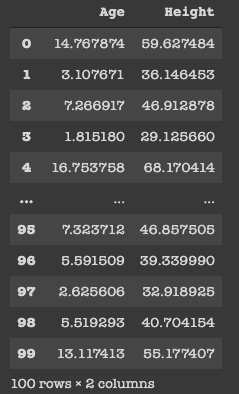
Podemos ver os dados que temos e contém apenas 2 colunas, a saber, Era (em anos) e altura (em polegadas) e 100 filas, que é na verdade a representação de uma pessoa.
Esta única linha de código tem um grande impacto na forma como olhamos para o conjunto de dados. Tínhamos apenas uma visão numérica do conjunto de dados, mas agora podemos executar esta célula para obter uma visualização do histograma do conjunto de dados, o que é muito útil. Representa os dados presentes nas colunas individuais como gráficos individuais.
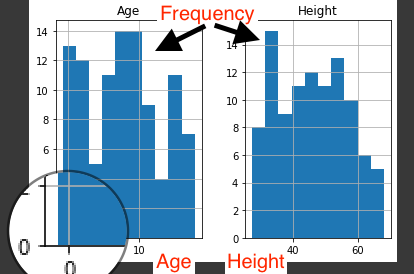
O eixo Y em ambos os gráficos se refere à frequência e o eixo X representa a Idade e a Altura, respectivamente..
3. Limpeza de dados:
Temos que construir o modelo usando conjuntos de dados válidos e limpar os dados que não devem ser contabilizados. Na foto acima, podemos saber que existem algumas entradas que têm uma idade menor que zero, o que não faz sentido. Portanto, precisamos limpar esses dados para obter mais precisão.
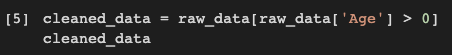
Eu uso variável data_cleaned para armazenar valores de idade válidos e exibi-los para o usuário.
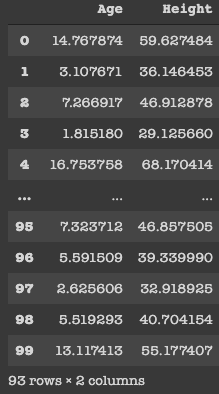
Inicialmente, tivemos 100 filas, mas depois de fazer a limpeza de dados, é bastante claro que existem sete linhas que tiveram uma idade <0 e nós os removemos. Como profissional, não devemos deletar os dados, uma vez que os estamos reduzindo e, portanto, a precisão do nosso modelo é reduzida. Para mantê-lo simples, Acabei de apagá-los.
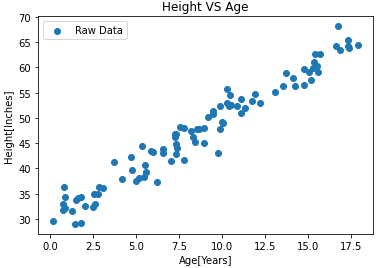
Visualize os dados limpos: agora eu usei os dados limpos e os visualizei como um gráfico.
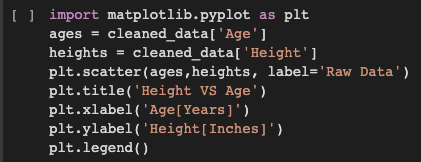
Para traçar gráficos python, Eu importo a biblioteca matplotlib.pyplot. Eu represento a idade no eixo X e a altura no eixo Y. Os pontos no gráfico referem-se aos dados brutos.
4. Construir o modelo e treiná-lo:
É aqui que entra o algoritmo de ML., quer dizer, regressão linear simples.
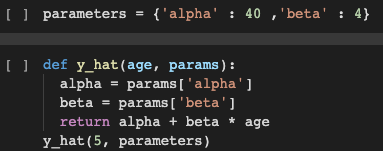
Eu usei um dicionário chamado parâmetros que tem alfa e beta como chave com 40 e 4 como valores respectivamente. Eu também defini uma função y_hat que leva idade e parâmetros como parâmetros. Esta função usa a equação básica em linha reta e retorna y, quer dizer, altura como no nosso caso. Se passarmos os parâmetros necessários e executarmos a função, descobrimos que a altura que obtemos para a idade como entrada não corresponde. Portanto, usamos a função abaixo mencionada para fazer o modelo chover.
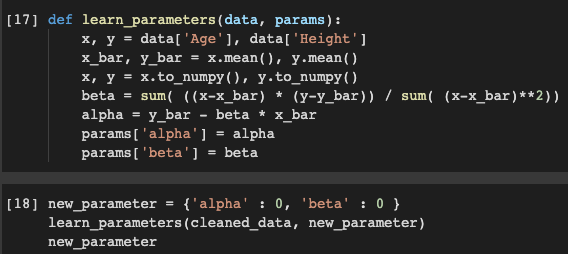
É aqui que usamos um método para encontrar o alfa e o beta corretos. A função learn_parameters você aceita data_cleaned e um dicionário fictício new_parameter que pode ter qualquer valor para alfa e beta. Então, quando os passamos como argumentos para os parâmetros e a função executa, podemos obter o valor correto de alfa e beta, que está próximo de 30 e 2 respectivamente e substituir os valores antigos pelos novos.
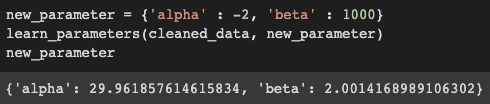
Encontramos com precisão os valores alfa e beta, e nosso próximo objetivo é treinar os dados. Mas deixe-me os valores preditos não treinados de quão precisos eles são.
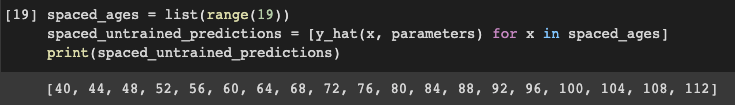
Eu uso uma lista chamada Spatial_ages que tem valores de 0 uma 18 (final – 1). Em seguida, outra lista chamada spaced_untrained_predictions que tem os valores previstos para a altura usa o y_hat função definida acima para predizê-lo. Esses valores são plotados em um gráfico e exibidos.
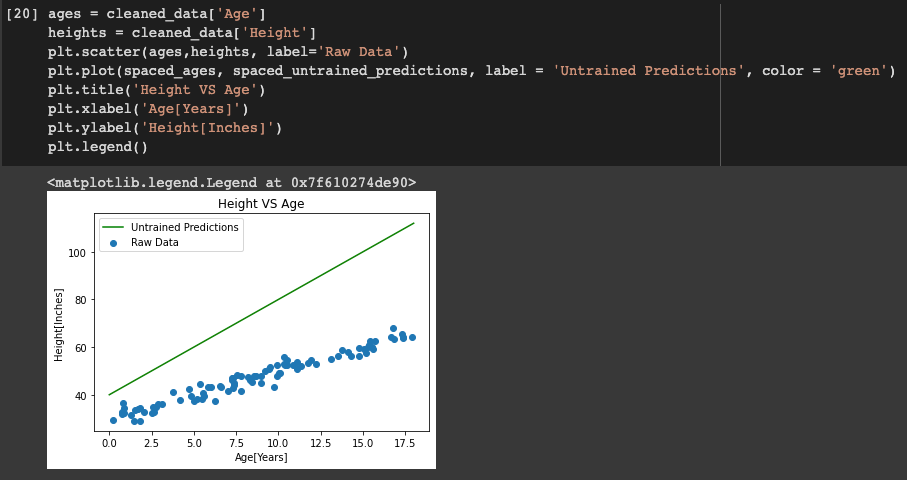
A linha verde mostra que o spaced_untrained_predictions desviaram-se muito dos valores reais e a precisão é muito pobre. Portanto, é necessário aumentar a precisão para a qual devemos treinar os dados.
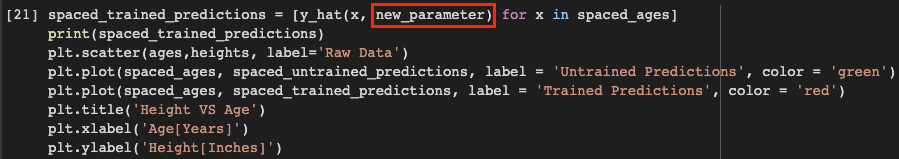
Então, em vez de usar parametros nós usamos new_parameters uma vez que contém o valor exato de alfa e beta e armazena em uma lista chamada spaced_trained_predictions. Então, quando traçamos um gráfico para este, podemos ver uma diferença visível e a precisão aumentou muito. Portanto, nós construímos e treinamos o modelo com sucesso. Prova disso são os valores de spaced_trained_predictions e o gráfico.
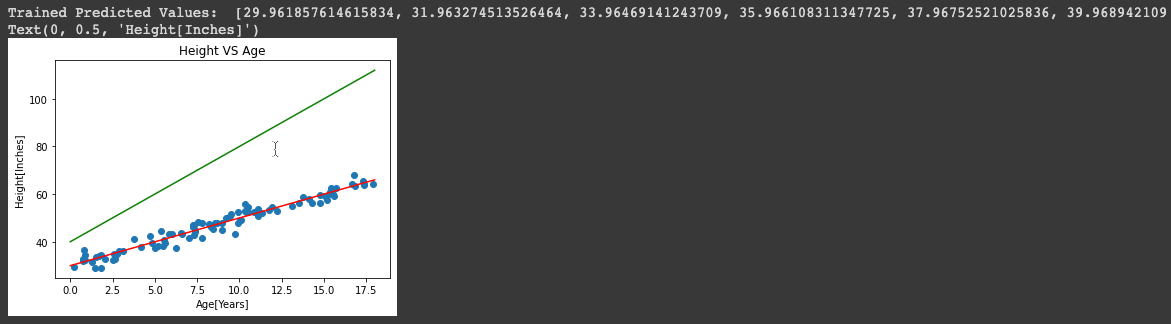
A linha verde refere-se aos valores de spaced_untrained_predictions e Redline refere-se aos valores de spaced_trained_predictions.
5.Faça previsões sobre dados invisíveis:
Com a ajuda deste modelo treinado, agora podemos fazer previsões precisas.
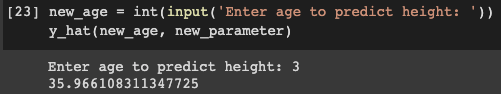
Então, podemos ver que para qualquer idade encontramos a altura possível em polegadas. Finalmente, nós treinamos o modelo com sucesso e precisão, qual é o objetivo final deste tutorial.
Como referência, Eu colei o Link para notebook você joga com ele. Espero me conectar através de LinkedIn também e compartilhe seus comentários valiosos. Fique ligado em mais blogs desse tipo😊.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





