
Esta postagem foi lançada como parte do Data Science Blogathon
O que é correspondência de string difusa?
A correspondência de string difusa é a técnica de encontrar strings que correspondam parcialmente e não exatamente a uma determinada string. Quando um usuário digita incorretamente uma palavra ou insere parcialmente uma palavra, correspondência de string difusa ajuda a encontrar a palavra correta, como vemos nos motores de busca.
O algoritmo por trás da correspondência de string difusa não se limita a observar a equivalência de duas strings, em vez disso, quantifica o quão próximas duas cordas estão uma da outra. Isso geralmente é feito usando uma métrica de distância conhecida como 'editar distância'. Isso determina a proximidade de duas strings, identificando as alterações mínimas necessárias para converter uma string em outra.. Existem diferentes tipos de distâncias de edição que podem ser usados, como a distância de Levenshtein, Distância de Hamming, A distância de Jaro, etc.
Vamos ilustrar como a distância de Levenshtein é calculada.
Exemplo 1:
Corrente 1 = ‘Colocar’
Corrente 2 = ‘Pat’
A distância de Levenshtein seria 1, já que podemos converter a string 1 Na corrente 2 substituindo 'você’ com um'.
Exemplo 2:
Corrente 1 = ‘Sol’
Corrente 2 = ‘Saturno’
A distância de Levenshtein seria 3, já que podemos converter a string 1 Na corrente 2 através de 3 inserções: 'uma', ‘T’ você 'r'.
Correspondência de string difusa em Python:
Comparando strings em Python
Para comparar duas strings em Python, podemos executar o seguinte código:
Str1 = "Voltar"
Str2 = "Livro"
Result = Str1 == Str2
print(Resultado)
O código acima dará um resultado como 'Falso'’ uma vez que as duas cordas não são as mesmas.
Distância de levenshtein em Python
Distância de Levenshtein em Python usando o pacote Python 'Levenshtein'.
import Levenshtein as lev
Str1 = "Voltar"
Str2 = "Livro"
lev.distance(Str1.inferior(),Str2.inferior())
O código acima dará uma saída de 2, podemos converter a sequência 1 Na corrente 2 por 2 Substituições.
FuzzyWuzzy em Python
FuzzyWuzzy é um pacote Python que pode ser usado para correspondência de cordas. Podemos executar o seguinte comando para instalar o pacote:
pip install fuzzywuzzy
O mesmo que o pacote Levenshtein, FuzzyWuzzy tem uma função de ligação que calcula o link de semelhança de distância levenshtein padrão entre duas sequências.
from fuzzywuzzy import fuzz
Str1 = "Voltar"
Str2 = "Livro"
Razão = fuzz.ratio(Str1.inferior(),Str2.inferior())
imprimir(Razão)
A saída do código a seguir dá 50, uma vez que a ligação Levehshtein é calculada dividindo a distância Levenshtein pelo máximo do comprimento da cadeia 1 e a corrente 2.
Vamos calcular o motivo para outro conjunto de cordas.
from fuzzywuzzy import fuzz
Str1 = "O meu nome é Ali"
Str2 = "Ali é meu nome"
Razão = fuzz.ratio(Str1.inferior(),Str2.inferior())
imprimir(Razão)
A saída do código dá 50, indicando que embora as palavras sejam as mesmas, a ordem das palavras é importante ao calcular a proporção.
Vinculação parcial usando FuzzyWuzzy
A vinculação parcial nos ajuda a combinar substrings. Isso pega a string mais curta e a compara com todas as substrings do mesmo comprimento.
Str1 = "O meu nome é Ali"
Str2 = "Meu nome é ali abdaal"
imprimir(fuzz.partial_ratio(Str1.inferior(),Str2.inferior()))
A saída do código dá 100 como parcial_ratio () apenas verifique se alguma das strings é uma substring da outra.
Este link pode ser muito útil se, como um exemplo, estamos tentando combinar o nome de uma pessoa entre dois conjuntos de dados. No primeiro conjunto de dados, a string tem o nome e o sobrenome da pessoa, e no segundo conjunto de dados, a corrente tem o nome, o nome do meio e sobrenome da pessoa. A proporção seria 100 porque a primeira string é uma substring da segunda string.
Taxa de classificação de token usando FuzzyWuzzy
Na proporção de classificação de tokens, strings são tokenizadas e pré-processadas, convertendo-as em minúsculas e removendo a pontuação. Subseqüentemente, strings são organizadas em ordem alfabética e unidas. Poste isso, o vínculo de semelhança de distância de Levenshtein é calculado entre as strings.
Str1 = "O meu nome é Ali"
Str2 = "Ali é meu nome"
imprimir(fuzz.token_sort_ratio(Str1, Str2))
A saída do código dá 100, uma vez que a proporção de classificação de token é encontrada após classificar as strings em ordem alfabética e, por isso, a ordem original das palavras não importa.
Proporção de conjunto de token usando FuzzyWuzzy
A proporção do conjunto de tokens executa uma operação de conjunto que extrai os tokens comuns em vez de apenas tokenizar as strings, classifique e cole os tokens novamente. As mesmas palavras extras ou repetidas não importam.
Str1 = "O meu nome é Ali"
Str2 = "Ali é meu nome, nome"
imprimir(fuzz.token_sort_ratio(Str1, Str2))
imprimir(fuzz.token_set_ratio(Str1, Str2))
A saída da vinculação de classificação de token torna-se 85, enquanto o de vinculação de conjunto de tokens vem para 100, porque a vinculação do conjunto de tokens não leva em conta palavras repetidas.
Vamos ilustrar outro exemplo de token set linking para uma explicação mais profunda..
Str_A = 'Read the sentence - My name is Ali'
Str_B = 'My name is Ali'
ratio = fuzz.token_set_ratio(Str_A, Str_B)
imprimir(Razão)
A saída do código acima nos dá 100. Isto é porque, underhood, associação de conjunto de tokens tem uma abordagem mais flexível. Depois de excluir as strings comuns ('O meu nome é Ali'), descobrir a ligação fuzz para os seguintes pares e, em seguida, retornar o valor máximo entre os três:
- string comum e string comum com o resto da string um
- string comum e string comum com o resto da string dois
- string comum com o resto de um e string comum com o resto de dois
Módulo de procedimento usando FuzzyWuzzy
Se tivermos uma lista de strings e quisermos encontrar a sequência correspondente mais próxima da lista para uma determinada sequência, podemos aproveitar o módulo 'procedimento'.
from fuzzywuzzy import process
query = 'My name is Ali'
choices = ['My name Ali', 'My name is Ali', 'My Ali']
# Obtenha uma lista de partidas ordenadas por pontuação, limite padrão para 5
process.extract(consulta, escolhas)
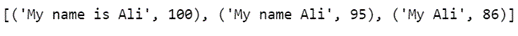
Se quisermos extrair o jogo superior, podemos executar o seguinte código:
process.extractOne(consulta, escolhas)
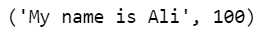
Sobre o autor
Nibedita completou seu MSc em Engenharia Química pelo IIT Kharagpur em 2014 e hoje ela trabalha como consultora sênior na AbsolutData Analytics. Em sua posição atual, atua na criação de soluções baseadas em IA / ML para clientes em diversos setores.
A mídia mostrada nesta postagem não é propriedade da DataPeaker e é usada a critério do autor.





