
Introdução
Ao criar um modelo de aprendizagem automática na vida real, é quase raro que todas as variáveis do conjunto de dados sejam úteis para criar um modelo. Adicionar variáveis redundantes reduz a capacidade de generalização do modelo e também pode diminuir a precisão geral de um classificador. O que mais, Adicionar mais e mais variáveis a um modelo aumenta a complexidade geral do modelo.
De acordo com a Lei da parcimónia a partir de ‘navalha de Occam’, a melhor explicação para um problema é aquela que envolve o menor número possível de suposições. Portanto, A seleção de características torna-se uma parte indispensável da construção de modelos de aprendizagem automática.
objetivo
O objetivo da seleção de características em aprendizagem automática é encontrar o melhor conjunto de características que permita construir modelos úteis dos fenómenos estudados.
As técnicas para a seleção de características em aprendizagem automática podem ser classificadas, em geral, nas seguintes categorias:
Técnicas supervisionadas: Estas técnicas podem ser usadas para dados rotulados e são utilizadas para identificar as características relevantes para aumentar a eficiência de modelos supervisionados, como classificação e regressão.
Técnicas não supervisionadas: Estas técnicas podem ser utilizadas para dados não rotulados.
De um ponto de vista taxonómico, estas técnicas são classificadas em:
UMA. Métodos de filtragem
B. Métodos de envoltura
C. Métodos integrados
D. Métodos híbridos
Neste artigo, analizaremos algunas técnicas populares de selección de funciones en el aprendizaje automático.
UMA. Métodos de filtragem
Los métodos de filtro recogen las propiedades intrínsecas de las características medidas a través de estadísticas univariadas en lugar del rendimiento de validación cruzada. Estos métodos son más rápidos y menos costosos computacionalmente que los métodos de envoltura. Cuando se trata de datos de alta dimensão"Dimensão" É um termo usado em várias disciplinas, como a física, Matemática e filosofia. Refere-se à extensão em que um objeto ou fenômeno pode ser analisado ou descrito. Em física, por exemplo, fala-se de dimensões espaciais e temporais, enquanto em matemática pode se referir ao número de coordenadas necessárias para representar um espaço. Compreendê-lo é fundamental para o estudo e..., es computacionalmente más económico utilizar métodos de filtrado.
Analicemos algunas de estas técnicas:
Ganho de informação
La ganancia de información calcula la reducción de la entropía a partir de la transformación de un conjunto de datos. Se puede utilizar para la selección de características evaluando la ganancia de información de cada variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... en el contexto de la variable de destino.
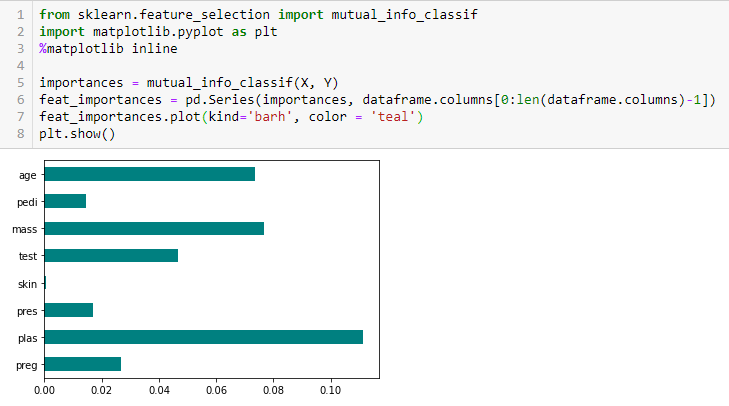
Teste qui-quadrado
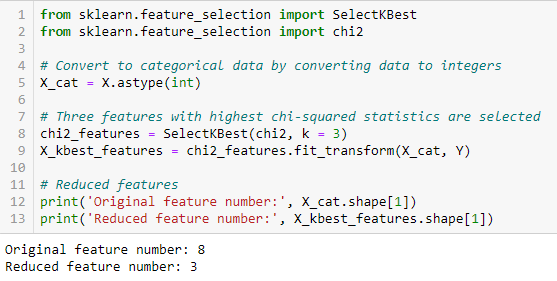
La prueba de chi-cuadrado se usa para características categóricas en un conjunto de datos. Calculamos Chi-cuadrado entre cada característica y el objetivo y selecionamos el número deseado de características con las mejores puntuaciones de Chi-cuadrado. Para aplicar correctamente el chi-cuadrado para probar la relación entre várias características en el conjunto de datos y la variable objetivo, se deben cumplir las siguientes condiciones: las variables deben ser categórico, muestreado independientemente y los valores deben tener un frecuencia esperada mayor que 5.
Puntuación de Fisher
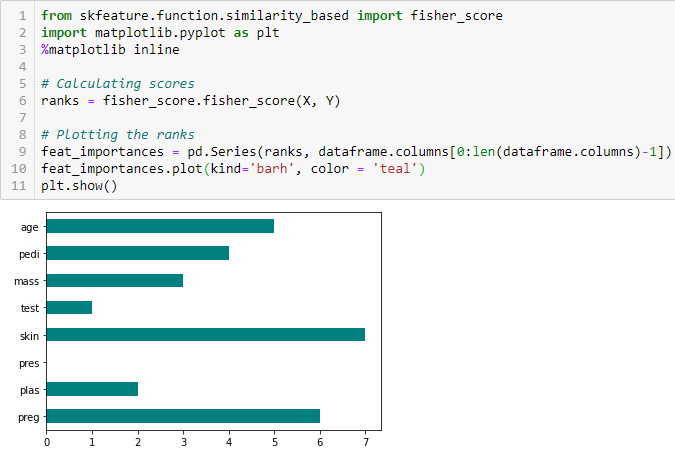
A pontuação de Fisher é um dos métodos de seleção de características supervisionadas mais utilizados. O algoritmo que iremos usar devolve os rankings das variáveis com base na pontuação de Fisher em ordem decrescente. Depois podemos selecionar as variáveis conforme o caso.
Coeficiente de correlação
A correlação é uma medida da relação linear de 2 ou mais variáveis. Através da correlação, podemos prever uma variável a partir da outra. A lógica por trás do uso da correlação para seleção de características é que boas variáveis estão altamente correlacionadas com o objetivo. O que mais, as variáveis devem estar correlacionadas com o objetivo, mas não devem estar correlacionadas entre si.
Se duas variáveis estão correlacionadas, podemos prever uma a partir da outra. Portanto, se duas características estão correlacionadas, o modelo realmente só precisa de uma delas, uma vez que a segunda não acrescenta informação adicional. Usaremos a correlação de Pearson aqui.
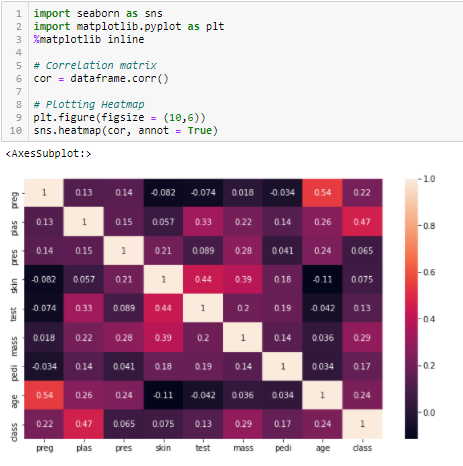
Precisamos definir um valor absoluto, Digamos 0.5 como o limiar para selecionar as variáveis. Se descobrirmos que as variáveis preditoras estão correlacionadas entre si, podemos descartar a variável que tem um valor de coeficiente de correlação mais baixo com a variável alvo. Também podemos calcular múltiplos coeficientes de correlação para verificar se mais de duas variáveis estão correlacionadas entre si. Este fenómeno é conhecido como multicolinearidade.
Limiar de variância
O limiar de variância é uma abordagem simples de referência para a seleção de características. Remove todas as características cuja variação não atinja algum limiar. Por padrão, Remove todas as características de variância zero, quer dizer, As características que têm o mesmo valor em todas as amostras. Assumimos que as características com uma variância mais elevada podem conter informação mais útil, Mas tenha em conta que não estamos a considerar a relação entre as variáveis de característica ou entre as variáveis de característica e o alvo, que é uma das desvantagens dos métodos de filtro.
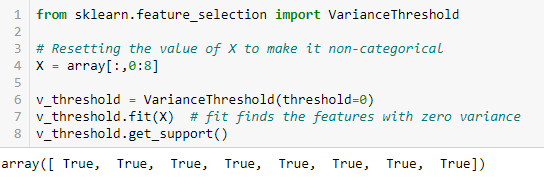
Get_support devolve um vetor booleano onde True significa que a variável não tem variância zero.
Diferença absoluta média (MAD)
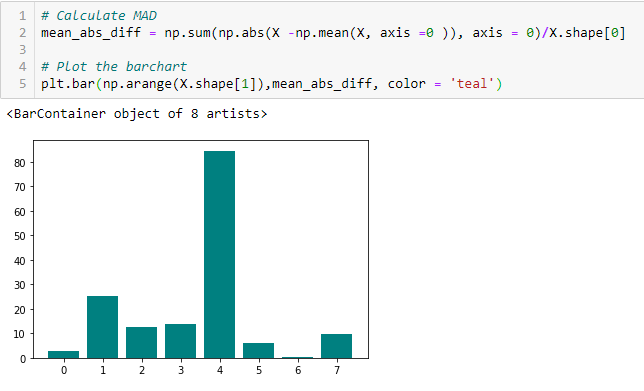
La diferencia absoluta media (MAD) calcula a diferença absoluta do valor médio. A principal diferença entre as medidas de variância e MAD é a ausência do quadrado nesta última. O MAD, assim como a variância, também é uma variante de escala ». [1] Isto significa que quanto maior o DMA, maior poder discriminatório.
Relação de dispersão
‘Outra medida de dispersão aplica a média aritmética (SOU) e a média geométrica (GM). Para uma característica dada (Positivo) Xeu em n padrões, AM e GM são dados por
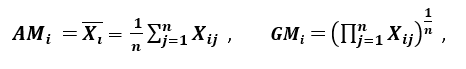
respectivamente; desde SOUeu ≥ GMeu, com igualdade se e somente se Xi1 = Xi2 =…. = Xsobre, depois a proporção
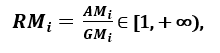
pode ser utilizada como medida de dispersão. Uma maior dispersão implica um valor maior de Ri, portanto, uma característica mais relevante. Pelo contrário, cuando todas las muestras de características tienen (aproximadamente) el mismo valor, Ri está cerca de 1, lo que indica una característica de baja relevancia '. [1]
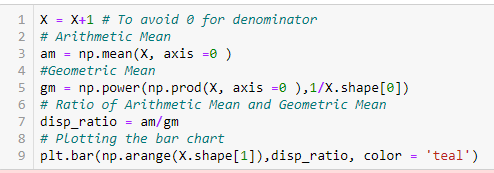
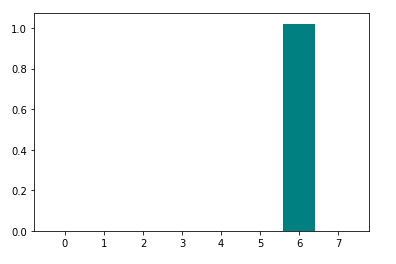 ‘
B. Métodos de envoltura:
Los envoltorios requieren algún método para buscar en el espacio todos los posibles subconjuntos de características, evaluando su calidad aprendiendo y evaluando un clasificador con ese subconjunto de características. El proceso de selección de características se basa en un algoritmo de aprendizaje automático específico que intentamos encajar en un conjunto de datos determinado. Sigue un enfoque de búsqueda codiciosa al evaluar todas las posibles combinaciones de características contra el criterio de evaluación. Los métodos de envoltura generalmente dan como resultado una mejor precisión predictiva que los métodos de filtro.
Analicemos algunas de estas técnicas:
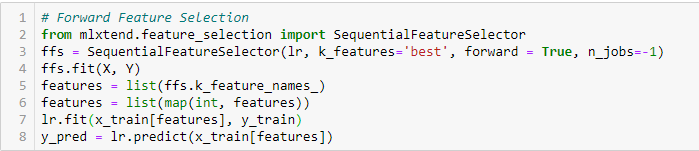
Selección de funciones avanzadas
Este es un método iterativo en el que comenzamos con la variable de mejor rendimiento contra el objetivo. A seguir, selecionamos otra variable que ofrezca el mejor rendimiento en combinación con la primera variable selecionada. Este proceso continúa hasta que se alcanza el criterio preestablecido.
Eliminación de características hacia atrás
Este método funciona exatamente de manera opuesta al método de selección de características hacia adelante. Aqui, comenzamos con todas las funciones disponibles y construimos un modelo. A seguir, tomamos la variable del modelo que da el mejor valor de medida de evaluación. Este proceso continúa hasta que se alcanza el criterio preestablecido.
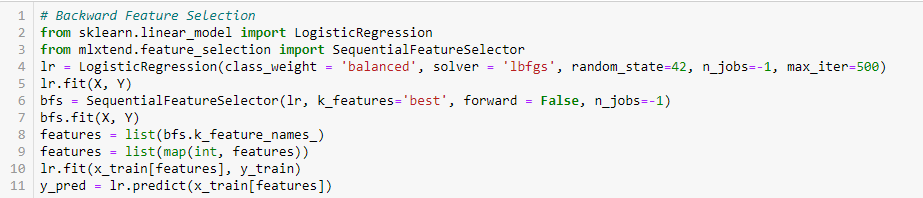
Este método, juntamente com o discutido anteriormente, também é conhecido como o método de seleção sequencial de características.
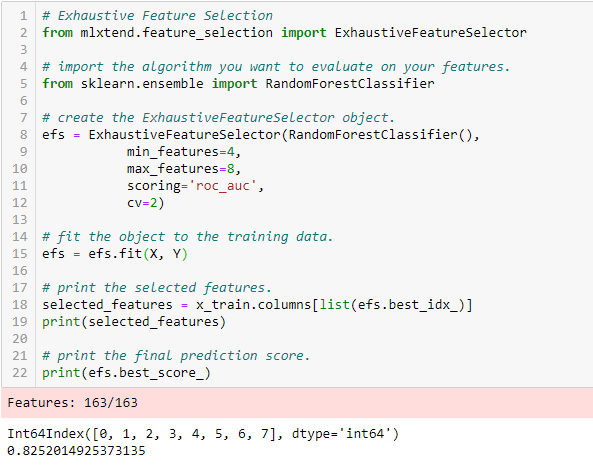
Seleção exaustiva de características
Este é o método de seleção de características mais robusto abordado até agora. Esta é uma avaliação de força bruta de cada subconjunto de características. Isto significa que tenta todas as combinações possíveis das variáveis e devolve o subconjunto com melhor desempenho.
Eliminação recursiva de características
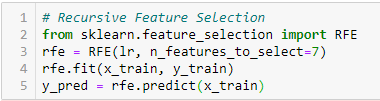
‘Dado um Estimadoro "Estimador" é uma ferramenta estatística usada para inferir características de uma população a partir de uma amostra. Ele se baseia em métodos matemáticos para fornecer estimativas precisas e confiáveis. Existem diferentes tipos de estimadores, como o imparcial e o consistente, escolhidos de acordo com o contexto e objetivo do estudo. Seu uso correto é essencial na pesquisa científica, levantamentos e análise de dados.... externo que atribui pesos às características (por exemplo, os coeficientes de um modelo linear), o objetivo da eliminação recursiva de características (RFE) es selecionar características considerando recursivamente conjuntos de características cada vez más pequeños. Primeiro, el estimador se entrena en el conjunto inicial de características y la importancia de cada característica se obtiene mediante un atributo coef_ o mediante un atributo feature_importances_.
Mais tarde, las características menos importantes se eliminan del conjunto atual de características. Ese procedimiento se repite de forma recursiva en el conjunto podado hasta que finalmente se alcanza el número deseado de características para selecionar. ‘[2]
C. Métodos integrados:
Estos métodos abarcan los beneficios de los métodos de envoltura y de filtro, al incluir interacciones de características pero también mantener un costo computacional razonable. Os métodos integrados são iterativos no sentido de que se ocupam de cada iteração do processo de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... do modelo e extraem cuidadosamente as características que mais contribuem para o treino numa iteração em particular.
Analicemos algunas de estas técnicas, Clique aqui:
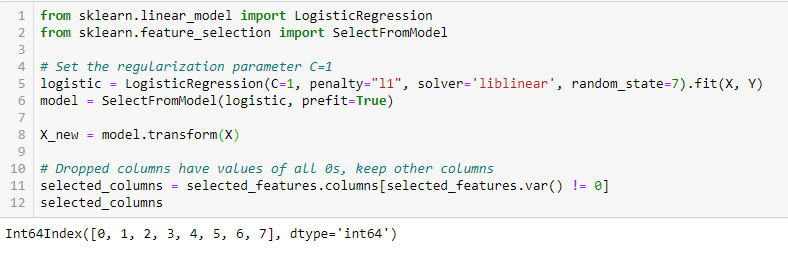
RegularizaçãoA regularização é um processo administrativo que busca formalizar a situação de pessoas ou entidades que atuam fora do marco legal. Esse procedimento é essencial para garantir direitos e deveres, bem como promover a inclusão social e econômica. Em muitos países, A regularização é aplicada em contextos migratórios, Trabalhista e Tributário, permitindo que aqueles que estão em situação irregular tenham acesso a benefícios e se protejam de possíveis sanções.... LASSO (L1)
A regularização consiste em adicionar uma penalização aos diferentes parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... do modelo de aprendizagem automática para reduzir a liberdade do modelo, quer dizer, para evitar um ajustamento excessivo. Na regularização de modelos lineares, a penalização aplica-se aos coeficientes que multiplicam cada um dos preditores. Dos diferentes tipos de regularização, Lasso ou L1 tem a propriedade de reduzir alguns dos coeficientes a zero. Portanto, essa característica pode ser eliminada do modelo.
Importância da floresta aleatória
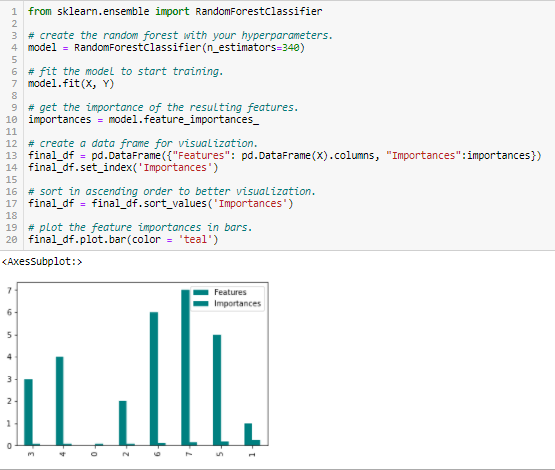
Random Forests es una especie de algoritmo de ensacado que agrega un número específico de árboles de decisión. Las estrategias basadas en árboles utilizadas por los bosques aleatorios se clasifican naturalmente según lo bien que mejoran la pureza del nóO Nodo é uma plataforma digital que facilita a conexão entre profissionais e empresas em busca de talentos. Através de um sistema intuitivo, permite que os usuários criem perfis, Compartilhar experiências e acessar oportunidades de trabalho. Seu foco em colaboração e networking torna o Nodo uma ferramenta valiosa para quem deseja expandir sua rede profissional e encontrar projetos que se alinhem com suas habilidades e objetivos...., ou em outras palavras, una disminución en la impureza (Impureza de gini) sobre todos los árboles. Los nodos con la mayor disminución de impurezas ocurren al comienzo de los árboles, mientras que las notas con la menor disminución de impurezas ocurren al final de los árboles. Portanto, al podar árboles debajo de un nodo en particular, podemos crear un subconjunto de las características más importantes.
conclusão
Hemos discutido algunas técnicas para la selección de funciones. Deixámos de propósito as técnicas de extração de características como Análise de Componentes Principais, Decomposição em Valores Singulares, Análise Discriminante Linear, etc. Estes métodos ajudam a reduzir a dimensionalidade dos dados ou reduzir o número de variáveis preservando a variância dos dados.
Para além dos métodos discutidos anteriormente, existem muitos outros métodos de seleção de características. Também existem métodos híbridos que utilizam técnicas de filtragem e embrulho. Se quiser explorar mais sobre as técnicas de seleção de características, na minha opinião, um excelente material de leitura completo seria ‘Seleção de características para reconhecimento de padrões e dados«por Urszula Stańczyk e Lakhmi C. Jain.
Referências
Documento denominado 'Filtros de selección de características eficientes para datos de alta dimensión’ por Artur J. Ferreira, Mário AT Figueiredo [1]
https://scikit-learn.org/stable/modules/generated/sklearn.feature_selection.RFE.html%20%5b2%5d [2]





