
Este artigo foi publicado como parte do Data Science Blogathon
Introdução
Processamento de linguagem natural (PNL) é um campo no qual a inteligência artificial e a linguística convergem. O objetivo é fazer com que os computadores entendam a linguagem do mundo real ou a linguagem natural para que possam realizar tarefas em resposta a perguntas, tradução de idiomas e muito mais.
A PNL tem muitas aplicações em diferentes campos.
1. A PNL permite o reconhecimento e a previsão de doenças com base em registros médicos eletrônicos.
2. Usado para obter feedback do cliente.
3. Para ajudar a identificar notícias falsas.
4. Chatbots.
5. Monitoramento de mídia social, etc.
Qual é o transformador?
A arquitetura do modelo do Transformer foi apresentada por Ashish Vaswani, Shazeer Noam, Niki Parmar, Jakob Razoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser e Illia Polosukhin no seu artigo “Atenção é tudo que você precisa”. [1]
O modelo Transformer extrai as características de cada palavra usando um mecanismo de autoatenção para saber a importância de cada palavra na frase. Nenhuma outra unidade recorrente é usada para extrair este recurso, são apenas ativações e somas ponderadas, então eles podem ser muito eficientes e paralelizáveis.
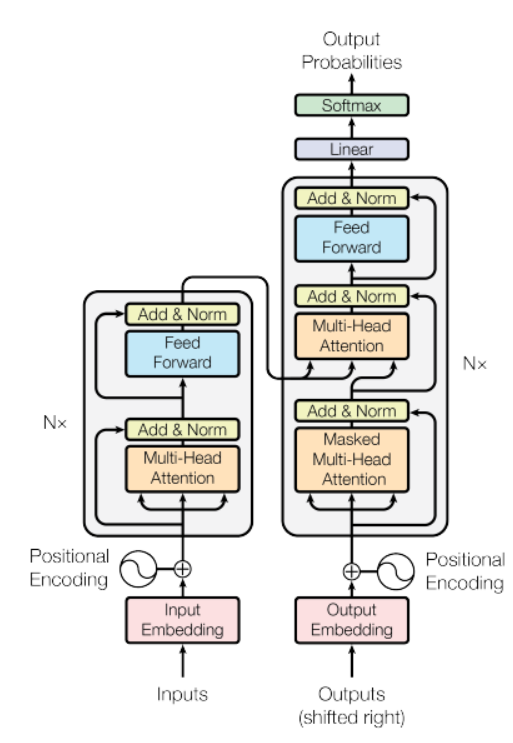
Fonte: documento “Atenção é tudo que você precisa”
No figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... anterior, há um modelo de codificador do lado esquerdo e o decodificador à direita. Tanto o codificador quanto o decodificador contêm um bloco central de atenção e uma rede de feedback repetido número N de vezes.
Na figura acima, há um modelo de codificador do lado esquerdo e o decodificador à direita. Tanto o codificador quanto o decodificador contêm um bloco de atenção central e uma rede de feedback repetida N várias vezes.
Tem uma pilha de 6 codificadores e 6 decodificadores, o codificador contém duas camadas (subcamadas), quer dizer, uma camada de autocuidado com várias cabeças e uma rede de alimentação direta totalmente conectada. O decodificador contém três camadas (subcamadas), uma camada de autocuidado com várias cabeças, outra camada de autocuidado com várias cabeças para realizar autocuidado nas saídas do codificador e uma rede de alimentação direta totalmente conectada. Cada subcapa en Decoder y Encoder tiene una conexión residual con padronizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos.... da camada.
Vamos começar a construir um modelo de tradução de linguagem
Aqui, usaremos o conjunto de dados Multi30k. Não se preocupe, o conjunto de dados será baixado com um snippet de código.
Primeiro, a parte de processamento de dados, usaremos o Tocha Módulo PyTorch. a Tocha tem utilitários para criar conjuntos de dados que podem ser facilmente iterados a fim de criar um modelo de tradução de idioma. O código a seguir fará o download do conjunto de dados e também tokenizará um texto bruto, construirá o vocabulário e converterá tokens em um tensorOs tensores são estruturas matemáticas que generalizam conceitos como escalares e vetores. São utilizados em diversas disciplinas, incluindo física, engenharia e aprendizagem automática, para representar dados multidimensionais. Um tensor pode ser visualizado como uma matriz de múltiplas dimensões, o que permite modelar relações complexas entre diferentes variáveis. A sua versatilidade e capacidade para lidar com grandes volumes de informação tornam-no uma ferramenta fundamental na análise e processamento de dados.....
importar matemática
importar texto da tocha
importar tocha
import torch.nn as nn
de torchtext.data.utils import get_tokenizer
do contador de importação de coleções
de torchtext.vocab import Vocab
de torchtext.utils import download_from_url, extract_archive
de torch.nn.utils.rnn import pad_sequence
de torch.utils.data import DataLoader
do Tensor de importação da tocha
da importação torch.nn (TransformEncode, TransformerDecoder,TransformerEncoderLayer, TransformerDecoderLayer)
importar io
tempo de importação
url_base ="https://raw.githubusercontent.com/multi30k/dataset/master/data/task1/raw/"
train_urls = ('train.de.gz', 'train.en.gz')
val_urls = ('val.de.gz', 'val.en.gz')
test_urls = ('test_2016_flickr.de.gz', 'test_2016_flickr.en.gz')

train_filepaths = [extract_archive(download_from_url(url_base + url))[0] para url em train_urls]
val_filepaths = [extract_archive(download_from_url(url_base + url))[0] para url em val_urls]
test_filepaths = [extract_archive(download_from_url(url_base + url))[0] para url em test_urls]

de_tokenizer = get_tokenizer('spacy', linguagem ="de_core_news_sm")
en_tokenizer = get_tokenizer('spacy', linguagem ="en_core_web_sm")

def build_vocab(caminho de arquivo, tokenizer):
contador = contador()
com io.open(caminho de arquivo, codificação ="utf8") como f:
para string_ em f:
counter.update(tokenizer(fragmento_))
retornar Vocab(contador, especiais =['<desconhecido>', '<almofada>', '<Monte>', '<eos>'])

de_vocab = build_vocab(train_filepaths[0], de_tokenizer)
en_vocab = build_vocab(train_filepaths[1], en_tokenizer)

def data_process(caminhos de arquivo):
raw_de_iter = iter(io.open(caminhos de arquivo[0], codificação ="utf8"))
raw_en_iter = iter(io.open(caminhos de arquivo[1], codificação ="utf8"))
dados = []
para (raw_de, raw_en) em zip(raw_de_iter, raw_en_iter):
de_tensor_ = torch.tensor([de_vocab[símbolo] para token em de_tokenizer(raw_de.rstrip("n"))],
dtype = torch.long)
en_tensor_ = torch.tensor([en_vocab[símbolo] para token em en_tokenizer(raw_en.rstrip("n"))],
dtype = torch.long)
data.append((de_tensor_, en_tensor_))
dados de retorno


train_data = data_process(train_filepaths)
val_data = data_process(val_filepaths)
test_data = data_process(test_filepaths)
device = torch.device('cuda' se torch.cuda.is_available() senão 'cpu')


BATCH_SIZE = 128
PAD_IDX = de_vocab['<almofada>']
BOS_IDX = de_vocab['<Monte>']
EOS_IDX = de_vocab['<eos>']
Em seguida, usaremos o módulo PyTorch DataLoader que combina um conjunto de dados e um amostrador, e nos permite iterar sobre o conjunto de dados fornecido. O DataLoader suporta conjuntos de dados iteráveis e de estilo de mapa com carregamento único ou multithread, também podemos personalizar a ordem de carregamento e a fixação de memória.
# DataLoader
def generate_batch(data_batch):
  de_batch, en_batch = [], []
  para (de_item, en_item) em data_batch:
    de_batch.append(torch.cat([torch.tensor([BOS_IDX]), de_item, torch.tensor([EOS_IDX])], dim = 0))
    en_batch.append(torch.cat([torch.tensor([BOS_IDX]), en_item, torch.tensor([EOS_IDX])], dim = 0))
  de_batch = pad_sequence(de_batch, padding_value = PAD_IDX)
  en_batch = pad_sequence(en_batch, padding_value = PAD_IDX)
  return de_batch, en_batch
train_iter = DataLoader(train_data, batch_size = BATCH_SIZE,
shuffle = True, collate_fn = generate_batch)
valid_iter = DataLoader(val_data, batch_size = BATCH_SIZE,
shuffle = True, collate_fn = generate_batch)
test_iter = DataLoader(dados de teste, batch_size = BATCH_SIZE,
shuffle = True, collate_fn = generate_batch)
Então, estamos projetando o transformador. Aqui, o codificador processa o fluxo de entrada propagando-o através de uma série de camadas de rede de atendimento multi-head feed. A saída deste codificador é chamada de memória abaixo e é fornecida ao decodificador junto com os tensores alvo. Codificador e decodificador são treinados ponta a ponta.
# transformador
classe Seq2SeqTransformer(nn.Module):
    def __init__(auto, num_encoder_layers: int, num_decoder_layers: int,
                 emb_size: int, src_vocab_size: int, tgt_vocab_size: int,
                 dim_feedforward:int = 512, cair fora:float = 0.1):
        super(Seq2SeqTransformer, auto).__iniciar__()
        encoder_layer = TransformerEncoderLayer(d_model = emb_size, nhead = NHEAD,
                                                dim_feedforward = dim_feedforward)
        self.transformer_encoder = TransformerEncoder(encoder_layer, num_layers = num_encoder_layers)
        decoder_layer = TransformerDecoderLayer(d_model = emb_size, nhead = NHEAD,
                                                dim_feedforward = dim_feedforward)
        self.transformer_decoder = TransformerDecoder(decoder_layer, num_layers = num_decoder_layers)
        self.generator = nn.Linear(emb_size, tgt_vocab_size)
        self.src_tok_emb = TokenEmbedding(src_vocab_size, emb_size)
        self.tgt_tok_emb = TokenEmbedding(tgt_vocab_size, emb_size)
        self.positional_encoding = PositionalEncoding(emb_size, dropout = dropout)

    def frente(auto, src: Tensor, trg: Tensor, src_mask: Tensor,
                tgt_mask: Tensor, src_padding_mask: Tensor,
                tgt_padding_mask: Tensor, memory_key_padding_mask: Tensor):
        src_emb = self.positional_encoding(self.src_tok_emb(src))
        tgt_emb = self.positional_encoding(self.tgt_tok_emb(trg))
        memory = self.transformer_encoder(src_emb, src_mask, src_padding_mask)
        outs = self.transformer_decoder(tgt_emb, memória, tgt_mask, Nenhum,
                                        tgt_padding_mask, memory_key_padding_mask)
        return self.generator(outs)

    def codificar(auto, src: Tensor, src_mask: Tensor):
        return self.transformer_encoder(self.positional_encoding(
                            self.src_tok_emb(src)), src_mask)

    def decodificar(auto, tgt: Tensor, memória: Tensor, tgt_mask: Tensor):
        return self.transformer_decoder(self.positional_encoding(
                          self.tgt_tok_emb(tgt)), memória,
                          tgt_mask)
O texto que é convertido em tokens é representado por incorporação de tokens. A função de codificação posicional é adicionada ao token embedding para que possamos obter as noções de ordem das palavras.
classe PositionalEncoding(nn.Module):
    def __init__(auto, emb_size: int, cair fora, maxlen: int = 5000):
        super(PositionalEncoding, auto).__iniciar__()
        den = torch.exp(- torch.arange(0, emb_size, 2) * math.log(10000) / emb_size)
        pos = torch.arange(0, maxlen).remodelar(maxlen, 1)
        pos_embedding = torch.zeros((maxlen, emb_size))
        pos_embedding[:, 0::2] = torch.sin(pos * a)
        pos_embedding[:, 1::2] = torch.cos(pos * a)
        pos_embedding = pos_embedding.unsqueeze(-2)
        self.dropout = nn.Dropout(cair fora)
        self.register_buffer('pos_embedding', pos_embedding)

    def frente(auto, token_embedding: Tensor):
        return self.dropout(token_embedding +
                            self.pos_embedding[:token_embedding.size(0),:])

classe TokenEmbedding(nn.Module):
    def __init__(auto, tamanho_do_ vocabulário: int, emb_size):
        super(TokenEmbedding, auto).__iniciar__()
        self.embedding = nn.Embedding(tamanho_do_ vocabulário, emb_size)
        self.emb_size = emb_size
    def frente(auto, tokens: Tensor):
        return self.embedding(tokens.long()) * math.sqrt(self.emb_size)
Aqui, no código abaixo, uma máscara de palavra subsequente é criada para evitar que uma palavra-alvo preste atenção às suas palavras subsequentes. As máscaras também são criadas aqui, para mascarar tokens de preenchimento de origem e destino.
def generate_square_subsequent_mask(sz):
    máscara = (tocha.triu(torch.ones((sz, sz), dispositivo = DEVICE)) == 1).transpor(0, 1)
    mask = mask.float().masked_fill(máscara == 0, flutuador('-inf')).masked_fill(máscara == 1, flutuador(0.0))
    máscara de retorno
def create_mask(src, tgt):
    src_seq_len = src.shape[0]
    tgt_seq_len = tgt.shape[0]

    tgt_mask = generate_square_subsequent_mask(tgt_seq_len)
    src_mask = torch.zeros((src_seq_len, src_seq_len), dispositivo = DEVICE).modelo(torch.bool)

    src_padding_mask = (src == PAD_IDX).transpor(0, 1)
    tgt_padding_mask = (tgt == PAD_IDX).transpor(0, 1)
    return src_mask, tgt_mask, src_padding_mask, tgt_padding_mask
Luego defina los parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... do modelo e crie uma instância do modelo.
SRC_VOCAB_SIZE = len(de_vocab)
TGT_VOCAB_SIZE = len(en_vocab)
EMB_SIZE = 512
NHEAD = 8
FFN_HID_DIM = 512
BATCH_SIZE = 128
NUM_ENCODER_LAYERS = 3
NUM_DECODER_LAYERS = 3
NUM_EPOCHS = 50
DEVICE = torch.device('cuda:0' se torch.cuda.is_available() senão 'cpu')
transformer = Seq2SeqTransformer(NUM_ENCODER_LAYERS, NUM_DECODER_LAYERS,
                                 EMB_SIZE, SRC_VOCAB_SIZE, TGT_VOCAB_SIZE,
                                 FFN_HID_DIM)

para p em transformer.parameters():
    se p.dim() > 1:
        nn.init.xavier_uniform_(p)

transformer = transformer.to(dispositivo)

loss_fn = torch.nn.CrossEntropyLoss(ignore_index = PAD_IDX)

optimizer = torch.optim.Adam(
    transformer.parameters(), lr = 0,0001, betas =(0.9, 0.98), eps = 1º-9º
)
Defina duas funções diferentes, quer dizer, para treinamento e avaliação.
def train_epoch(modelo, train_iter, otimizador):
    model.train()
    perdas = 0
    para idx, (src, tgt) em enumerar(train_iter):
        src = src.to(dispositivo)
        tgt = tgt.to(dispositivo)
        tgt_input = tgt[:-1, :]

        src_mask, tgt_mask, src_padding_mask, tgt_padding_mask = create_mask(src, tgt_input)

        logits = modelo(src, tgt_input, src_mask, tgt_mask,
                       src_padding_mask, tgt_padding_mask, src_padding_mask)

        optimizer.zero_grad()

        tgt_out = tgt[1:, :]
        perda = perda_fn(logits.reshape(-1, logits.shape[-1]), tgt_out.reshape(-1))
        loss.backward()

        optimizer.step()
        perdas + = perda.item()
    torch.save(modelo, CAMINHO)

    perdas de retorno / len(train_iter)


def avaliar(modelo, val_iter):
    model.eval()
    perdas = 0
    para idx, (src, tgt) no (enumerar(valid_iter)):
        src = src.to(dispositivo)
        tgt = tgt.to(dispositivo)

        tgt_input = tgt[:-1, :]

        src_mask, tgt_mask, src_padding_mask, tgt_padding_mask = create_mask(src, tgt_input)

        logits = modelo(src, tgt_input, src_mask, tgt_mask,
                       src_padding_mask, tgt_padding_mask, src_padding_mask)
        tgt_out = tgt[1:, :]
        perda = perda_fn(logits.reshape(-1, logits.shape[-1]), tgt_out.reshape(-1))
        perdas + = perda.item()
    perdas de retorno / len(val_iter)
Agora treinando o modelo.
para época no intervalo(1, NUM_EPOCHS + 1):
    start_time = time.time()
    train_loss = train_epoch(transformador, train_iter, otimizador)
    end_time = time.time()
    val_loss = avaliar(transformador, valid_iter)
    imprimir((f"Época: {época}, Perda de trem: {perda de trem:.3f}, Perda de val: {val_loss:.3f}, "
           f"Tempo da época = {(Fim do tempo - start_time):.3f}s"))
Este modelo é treinado usando a arquitetura do transformador de forma que treine mais rápido e também converta para uma menor perda de validação em comparação com outros modelos RNN..
def greedy_decode(modelo, src, src_mask, max_len, start_symbol):
    src = src.to(dispositivo)
    src_mask = src_mask.to(dispositivo)
    memory = model.encode(src, src_mask)
    ys = torch.ones(1, 1).preencher_(start_symbol).modelo(torch.long).para(dispositivo)
    para eu no alcance(max_len-1):
        memory = memory.to(dispositivo)
        memory_mask = torch.zeros(ys.shape[0], memory.shape[0]).para(dispositivo).modelo(torch.bool)
        tgt_mask = (generate_square_subsequent_mask(ys.size(0))
                                    .modelo(torch.bool)).para(dispositivo)
        out = model.decode(sim, memória, tgt_mask)
        out = out.transpose(0, 1)
        prob = model.generator(Fora[:, -1])
        _, next_word = torch.max(prob, dim = 1)
        next_word = next_word.item()

        ys = torch.cat([sim,
                        torch.ones(1, 1).type_as(src.data).preencher_(next_word)], dim = 0)
        if next_word == EOS_IDX:
          pausa
    retornar sim


def traduzir(modelo, src, src_vocab, tgt_vocab, src_tokenizer):
    model.eval()
    tokens = [BOS_IDX] + [src_vocab.stoi[tomou] para tok em src_tokenizer(src)] + [EOS_IDX]
    num_tokens = len(tokens)
    src = (tocha.LongTensor(tokens).remodelar(num_tokens, 1))
    src_mask = (torch.zeros(num_tokens, num_tokens)).modelo(torch.bool)
    tgt_tokens = greedy_decode(modelo, src, src_mask, max_len = num_tokens + 5, start_symbol = BOS_IDX).achatar()
    Retorna " ".Junte([tgt_vocab.itos[tomou] para tok em tgt_tokens]).substituir("<Monte>", "").substituir("<eos>", "")
Agora, Vamos testar nosso modelo de tradução.
output = traduzir(transformador, "Um grupo de pessoas em frente a um iglu .", de_vocab, en_vocab, de_tokenizer)
imprimir(saída)
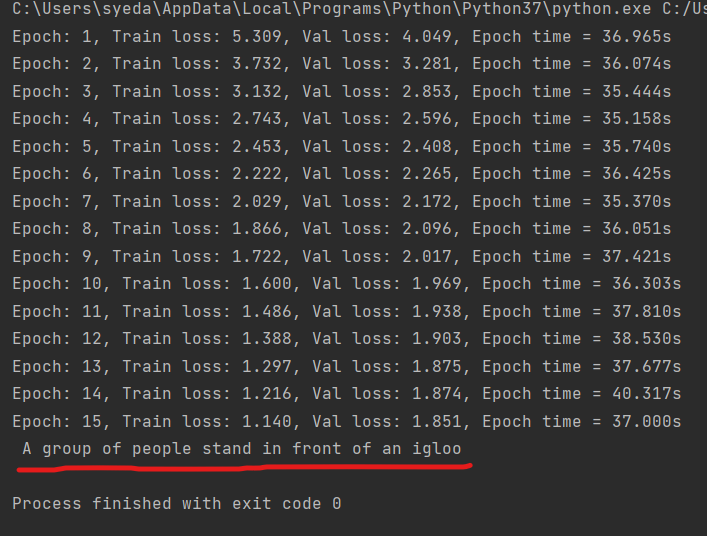
Acima da linha vermelha está o resultado do modelo de tradução. Você também pode compará-lo com o google tradutor.
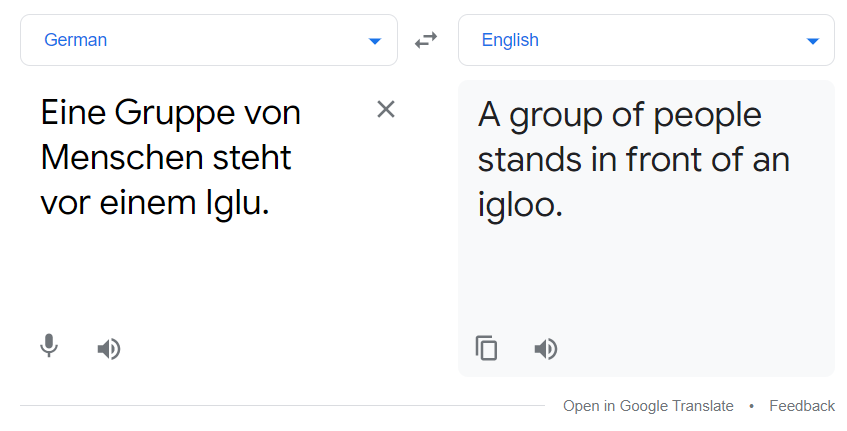
A tradução acima e a saída do nosso modelo corresponderam. O modelo não é o melhor, mas ainda funciona até certo ponto.
Referência
[1]. Ashish Vaswani, Shazeer Noam, Niki Parmar, Jakob Razoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser e Illia Polosukhin: atenção é tudo que você precisa, Dezembro de 2017, DOI: https://arxiv.org/pdf/1706.03762.pdf
Também para mais informações, consulte https://pytorch.org/tutorials/
Obrigado
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





