
Este artigo foi publicado como parte do Data Science Blogathon
As seções da sua melodia principal são uma espécie de arranhões na teia de aranha! Sem considerar, As palavras “raspagem web” geralmente implicam uma conexão que incorpora informatização. Alguns destinos poderiam prescindir dele quando os depuradores personalizados recolhem os seus dados, enquanto outros não se importariam.
Esperando que esteja a raspar uma página deliberadamente à procura de elementos informativos, supõe-se que não terá qualquer problema. Tendo tudo em consideração, é uma boa ideia fazer uma avaliação isolada e garantir que não está a ignorar os Termos de serviço antes de iniciar um enorme projeto de graduação. Para se sentir confortável com as partes legais da raspagem web, Dê uma vista de olhos em Perspectivas legais sobre o web scraping moderno.
Por que fazer web scraping?
Exatamente quando fazemos web scraping, Criamos um código que envia um pedido que funciona com a página que escolhemos. O especialista devolverá o código-fonte – HTML, em geral – da página (ou páginas) às quais fizemos referência.
Até muito recentemente, basicamente estamos a fazer mais do que um programa web: enviar interesse com uma URL específica e mencionar que o especialista devolve o código para essa página.
Em qualquer caso, ao contrário de um programa web, o nosso código de web scraping não vai traduzir o código-fonte da página nem mostrar a página de forma aparente. Tendo tudo isto em consideração, pensaremos en algún código personalizado que canalice a través del código fuente de la página buscando partes expresas que hayamos demostrado y quitando cualquier sustancia que le hayamos enseñado a eliminar.
Por exemplo, en caso de que esperáramos obtener el total de los datos del interior de una tabla que apareció en la página de un sitio, nuestro código se formaría para seguir estos métodos en la recopilación:
1 Solicitud de la sustancia (código-fonte) de una URL específica del trabajador
2 Descargue la sustancia que se devuelve.
3 Distingue los segmentos de la página que son fundamentales para la tabla que necesitamos.
4 Concentre y (si es crucial) reformatee esos segmentos en un conjunto de datos que podamos desarmar o utilizar de la forma que necesitemos.
Si todo eso suena particularmente complicado, ¡no presiones! Python y Beautiful Soup tienen características naturales propuestas para que esto sea en su mayor parte inmediato.
Una cosa que es fundamental para tener en cuenta: desde la perspetiva de un especialista, hacer referencia a una página a través del web scratching es comparável a apilarla en un programa web. Exatamente cuando usamos código para introducir estas solicitudes, podríamos estar “apilando” páginas significativamente más rápido que un cliente estándar, y de esta manera consumiendo rapidamentemente los recursos de mano de obra del propietario del sitio.
Web Scraping de datos para aprendizaje automático:
En caso de que raspe los datos para la IA, prometa que verificou as concentrações baixas antes de se aproximar da extração de dados.
Formato de dados:
Os modelos de inteligência simulada podem simplesmente aumentar abruptamente a popularidade dos dados que estão numa associação simples ou semelhante a uma tabela. Nesse sentido, a raspagem de dados não estruturados exigirá, desta forma, uma maior liberdade para tratar os dados antes de poderem ser utilizados.
Lista de dados:
Visto que o objetivo principal é a inteligência artificial, quando tiver as localizações ou as páginas web que deseja remover, deve fazer uma visão geral dos centros de dados ou das fontes de dados que deseja remover de cada página do site. Se o caso for com o objetivo final de faltar uma grande quantidade de centros de dados para cada página do site, então deve cortar e escolher os centros de dados que geralmente estão presentes. A razão para isto é que tantas características NA ou vazias irão diminuir o desempenho e a precisão do modelo de IA (ML) que treina e testa com os dados.
Etiquetagem de dados:
A verificação de dados pode ser um tormento mental. Em qualquer caso, se conseguir acumular os metadados necessários enquanto os dados são raspados e armazená-los como um ponto de dados alternativo, beneficiará as etapas correspondentes no ciclo de vida dos dados.
Limpo, preparar e armazenar os dados
Embora este movimento possa parecer básico, habitualmente es quizás el avance más enredado y triste. Este es el resultado direto de una clara aclaración: no hay una conexión que sirva para todos. Depende de los datos que haya borrado y de dónde los haya borrado. Necesitará estrategias rápidas para limpiar los datos.
Lo más importante es que debe revisar los datos para comprender qué degradaciones se encuentran en las fuentes de datos. Puede hacer esto usando una biblioteca como Pandas (disponible en Python). En el momento en que se realiza su evaluación, debe crear una sustancia para eliminar las deformidades en las fuentes de datos y normalizar los centros de datos que no son como los demás. Mais tarde, realizaria grandes verificações para verificar se os centros de dados têm todos os dados num único tipo de dados. Um fragmento que deveria conter números não pode ter uma linha de dados. Por exemplo, Um que deveria conter dados na configuração dd / milímetros / aaaa não pode conter dados em qualquer outra associação. Além destas verificações do plano, As características que faltam, As características inválidas e qualquer outra coisa que possa comprometer o tratamento dos dados, Devem ser detetadas e corrigidas.
Por que Python para Web Scraping?
Python é uma ferramenta conhecida para executar web scraping. A linguagem de programação Python também é utilizada para outras atividades valiosas relacionadas com a segurança da rede, os testes de acesso, assim como as aplicações mensuráveis avançadas. Usando a programação básica em Python, o web scraping pode ser realizado sem utilizar qualquer outro dispositivo externo.
A linguagem de programação Python está a ganhar uma prevalência imensa e as razões que fazem de Python uma combinação sólida para projetos de web scraping são as seguintes:
Simplicidade de sintaxe
Python tem a construção mais simples em comparação com outras linguagens de programação. Este aspeto do Python simplifica os testes e um engenheiro pode concentrar-se em programação adicional.
Módulos incorporados
Otra justificación para utilizar Python para hacer scratching en la web es la incorporación de las valiosas bibliotecas externas que tiene. Podemos realizar numerosas ejecuciones identificadas con web scratching utilizando Python como base para la programación.
Lenguaje de programación de código abierto
Python cuenta con una gran ayuda del área local ya que es un lenguaje de programación de código abierto.
Amplia gama de aplicações
Python se pode utilizar para diferentes asignaciones de programación que van desde pequeños contenidos de shell hasta aplicaciones web de grandes empresas.
Módulos de Python para web scraping
El raspado web es el camino hacia el desarrollo de un especialista que pueda extraer, analisar, descarregar e coordenar dados valiosos da web em conformidade. No final do dia, em vez de guardar fisicamente a informação dos sites, a programação web scraping irá carregar e concentrar a informação de diferentes sites de acordo com o nosso pré-requisito.
Aplicativo
É uma biblioteca de web scraping em Python simples. É uma biblioteca HTTP eficaz utilizada para aceder às páginas. Com a ajuda de Requests, podemos obter o HTML bruto das páginas do site que depois poderia ser analisado para recuperar a informação.
Uma das principais razões pelas quais a biblioteca Beautiful Soup é tão popular é que é mais fácil de trabalhar e é adequada para iniciantes.
Beautiful Soup é uma biblioteca em Python para extrair informação de registos HTML e XML. Tende a ser utilizada com Requests, uma vez que precisa de um pedaço de informação (relatório ou URL) para criar um objeto soup, ya que no puede traer una página del sitio sin la ayuda de nadie más. Puede utilizar el contenido de Python adjunto para ensamblar el título de la página y los hipervínculos.
Código –
import urllib.request
from urllib.request import urlopen, Request
from bs4 import BeautifulSoup
wiki= "https://www.thestar.com.my/search/?q=HIV&qsort=oldest&qrec=10&qstockcode=&pgno=1"
html=urlopen(wiki)
bs= BeautifulSoup(html,'lxml')
bs
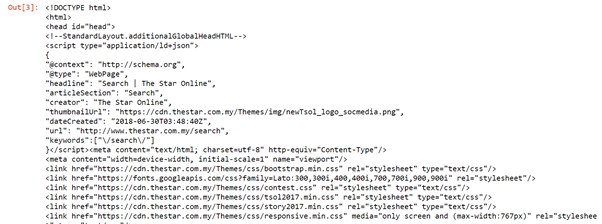
Beautiful Soup is used to extract the website page
(fuente de la imagen: cuaderno Jupyter)
Código-
from bs4 import BeautifulSoup
base_url="https://www.thestar.com.my/search/?q=HIV&qsort=oldest&qrec=10&qstockcode=&pgno="
# Add 1 because Python range.
url_list = ["{}{}".formato(base_url, str(página)) for page in range(1, 408)]
s=[]
for url in url_list:
    imprimir (url)
    s.append(url)
Produção-
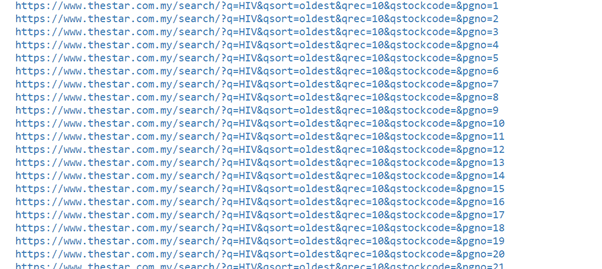
El código anterior enumerará el número de páginas web en el rango de 1 uma 407.
(fuente de la imagen: cuaderno Jupyter)
Código –
dados = []
data1= []
import csv
from urllib.request import urlopen, HTTPError
from datetime import datetime, timedelta
for pg in s:
    # query the website and return the html to the variable 'page'
    page = urllib.request.urlopen(pg)
    Experimente:
        search_response = urllib.request.urlopen(pg)
    exceto urllib.request.HTTPError:
        passar
    # parse the html using beautiful soap and store in variable `soup`
    soup = BeautifulSoup(página, 'html.parser')
    # Tire o <Div> of name and get its value
    ls = [x.get_text(strip=True) for x in soup.find_all("h2", {"classe": "f18"})]
    ls1=  [x.get_text(strip=True) for x in soup.find_all("span", {"classe": "encontro"})]
    # save the data in tuple
    data.append((ls))
    data1.append(ls1)
Produção-
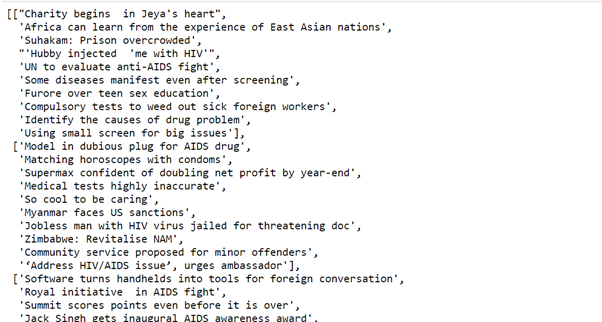
El código anterior tomará todos los datos con la ayuda de una hermosa sopa y los guardará en la tupla.
(fuente de la imagen: cuaderno Jupyter)
Código
import pandas as p
df=p.DataFrame(f,colunas =['Topic of article'])
df['Date']=f1
Produção-
Pandas
Pandas es un instrumento de investigación y control de información de código abierto rápido, incrível, adaptável e fácil de usar, baseado na parte superior da linguagem de programação Python.
O código acima armazena o valor no dataframe.

(fuente de la imagen: cuaderno Jupyter)
Espero que gostem do código.
Pequena introdução
Mim, Sonia Singla, realizei um mestrado em bioinformática na Universidade de Leicester, Reino Unido. Também realizei alguns projetos sobre ciência de dados no CSIR-CDRI. Atualmente sou membro consultor do conselho editorial da IJPBS.
Linkedin – https://www.linkedin.com/in/soniasinglabio/
A mídia mostrada neste artigo sobre a implementação de modelos de aprendizado de máquina que tiram proveito do CherryPy e do Docker não é propriedade do DataPeaker e é usada a critério do autor.





