
“Predição é muito difícil, especialmente se for sobre o futuro”.
alguma ideia depois de ler a bela citação acima. Eu expliquei diferentes bibliotecas automatizadas para automatizar o aprendizado de máquina e o dever de casa de PNL em meus artigos anteriores. de forma similar, neste artigo, Vou explicar "Como automatizar a previsão de séries temporais usando o Auto-TS".
O Auto-TS é parte do AutoML que automatizará alguns dos componentes do processo de aprendizado de máquina. Isso automatiza bibliotecas e ajuda não especialistas a treinar um modelo básico de aprendizado de máquina sem ter muito conhecimento na área. Aqui neste artigo, Discutirei como automatizar a implementação de um modelo de previsão de série temporal usando a biblioteca Auto-TS.
O que é Auto-TS?
É uma biblioteca Python de código aberto que é basicamente usada para automatizar a previsão de séries temporais. Ele treinará automaticamente vários modelos de série temporal usando uma única linha de código, que nos ajudará a escolher o melhor para a nossa declaração de problema.
Na biblioteca Python de código aberto, Auto-TS, auto-ts.Auto_TimeSeries () é a função principal que você chamará com seus dados de trem. Mais tarde, nós podemos escolher que tipo de modelo você quer, como modelos baseados em estatísticas, ml o FB. Também podemos ajustar o parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... que selecionará automaticamente o melhor modelo com base no parâmetro de pontuação em que queremos que ele se baseie. Ele retornará o melhor modelo e um dicionário contendo previsões para o número de Forecast_periods que você mencionou (default = 2).
Recursos da biblioteca Auto-TS:
- Encontre o modelo de predição de série temporal ideal, otimizando a programação genética.
- Treine modelos ingênuas, Estatisticas, aprendizado de máquina e aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde..., com todas as configurações possíveis de hiperparmetro e validação cruzada.
- Realiza transformações de dados para lidar com dados confusos, aprendendo a imputação ótima da NaN e eliminação outlier.
- Escolhendo o Mix Métrico para Seleção de Modelos.
Instalação:
pip instalar autots  OU
pip3 instalar auto-ts   OU
pip instalar git+git://github.com/AutoViML/Auto_TS
Requisitos:
dask
scikit-learn
FB Prophet
statsmodels
pmdarima
XGBoost
Biblioteca de importação usando:
de auto_ts import auto_timeseries
Parâmetros disponíveis em auto_timeseries:
model = auto_timeseries( score_type ="rmse", time_interval ="Mês", non_seasonal_pdq = Nenhum, sazonalidade = False, sazonal_período = 12, model_type =['Prophet'], verboso = 2)
Você pode ajustar os parâmetros e analisar a mudança no desempenho do modelo. Para mais detalhes sobre os parâmetros, Clique em aqui.
Conjunto de dados usado:
Aqui eu usei o Preço da ação Amazon conjunto de dados para janeiro 2006 a janeiro 2018, que é baixado do Kaggle. Esta biblioteca oferece apenas modelos de previsão de séries temporais de trens. O conjunto de dados deve ter uma coluna de formato de data ou hora.
Inicialmente, Carregue o conjunto de dados do Série temporalUma série temporal é um conjunto de dados coletados ou medidos em momentos sucessivos, geralmente em intervalos de tempo regulares. Esse tipo de análise permite identificar padrões, Tendências e ciclos nos dados ao longo do tempo. Sua aplicação é ampla, abrangendo áreas como economia, Meteorologia e saúde pública, facilitando a previsão e a tomada de decisões com base em informações históricas.... com uma coluna de data e hora:
df = pd.read_csv("Amazon_Stock_Price.csv", usecols =['Date', 'Fechar'])
df['Date'] = pd.to_datetime(df['Date'])
df = df.sort_values('Date')
Agora, dividir todos os dados em dados de teste e treinamento:
train_df = df.iloc[:2800]
test_df = df.iloc[2800:]
Agora, vamos visualizar a divisão de teste do trem:
train_df.Close.plot(figsize =(15,8), título ="Preço da ação AMZN", fontsize = 14, rótulo ="Trem")
test_df.Close.plot(figsize =(15,8), título ="Preço da ação AMZN", fontsize = 14, rótulo ="Teste")
plt.legend()
plt.grid()
plt.show()
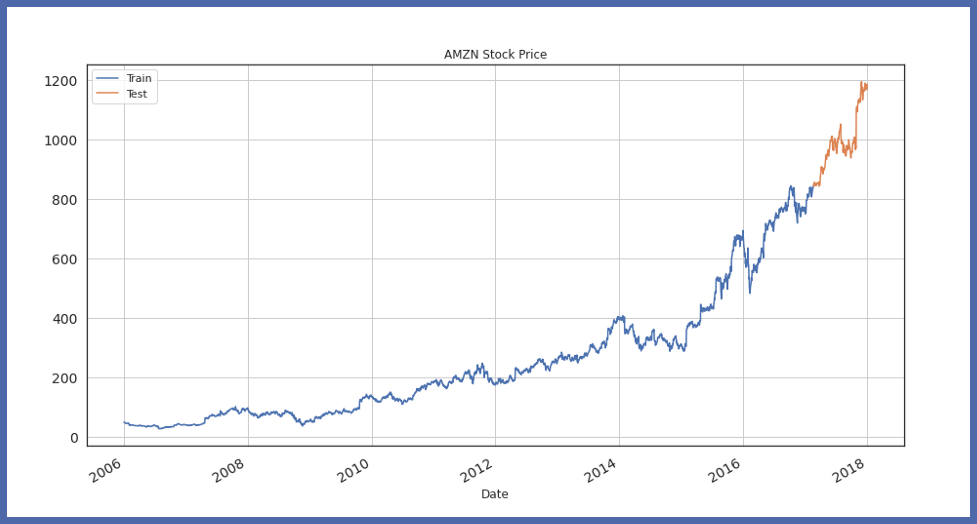
Agora, inicializar o objeto de modelo Auto-TS e ajustar os dados de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina....:
model = auto_timeseries(forecast_period = 219, score_type ="rmse", time_interval ="D", model_type ="melhor")
model.fit(traindata = train_df, ts_column ="Encontro", alvo ="Fechar")
Agora vamos comparar a precisão de diferentes modelos:
model.get_leaderboard()
model.plot_cv_scores()
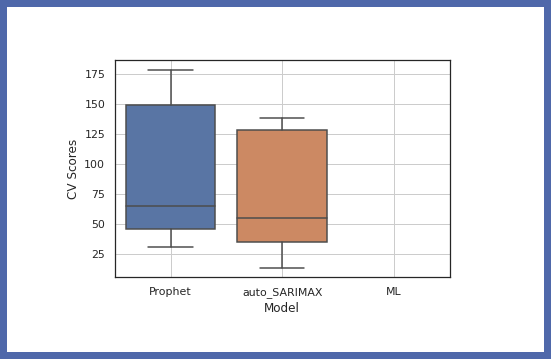
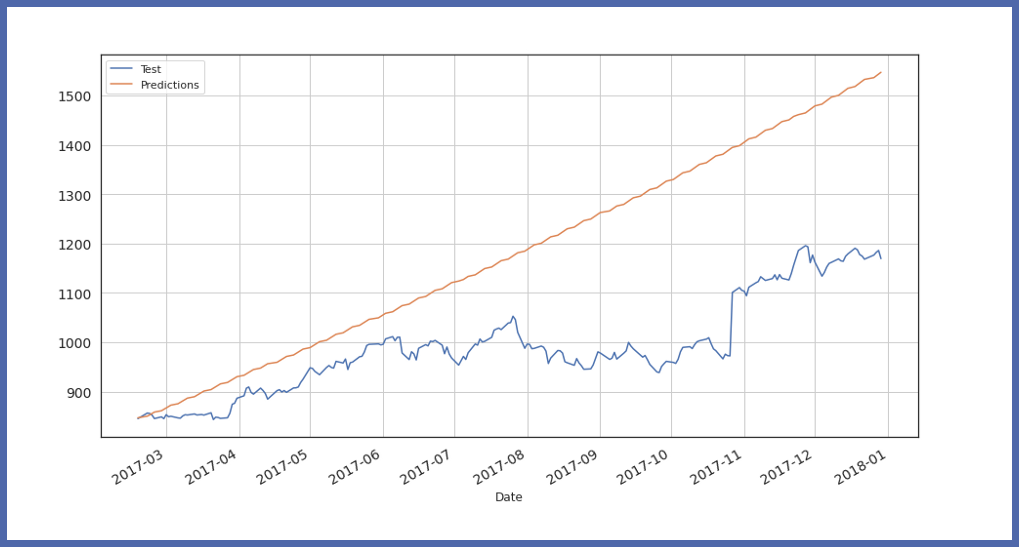
Agora vamos testar nosso modelo com dados de teste:
previsões_futuras = model.predict(testdata = 219)
Finalmente, ver o valor e a previsão dos dados de teste:
Parâmetros disponíveis em auto_timeseries:
model = auto_timeseries( score_type ="rmse", time_interval ="Mês", non_seasonal_pdq = Nenhum, sazonalidade = False, sazonal_período = 12, model_type =['Prophet'], verboso = 2)
Parâmetros disponíveis em model.fit ():
model.fit( traindata = train_data, ts_column = ts_column, target = target, cv = 5, sep ="," )
Parâmetros disponíveis em model.predict ():
predictions = model.predict( testdata = pode ser um dataframe ou um inteiro que representa o forecast_period, modelo ="melhor" ou qualquer outra corda que represente o modelo treinado )
Você pode brincar com todos esses parâmetros e analisar o desempenho do nosso modelo e, então, selecionar o modelo mais adequado para a definição do seu problema.. Você pode verificar todos esses parâmetros em detalhes clicando em aqui.
conclusão:
Neste artigo, Eu discuti como o modelo de série temporal pode ser automatizado em uma linha de código Python. Auto-TS realiza pré-processamento de dados, uma vez que remove outliers de dados e lida com dados confusos, aprendendo a imputação NaN ideal. Usando apenas uma linha de código, inicializar o objeto Auto-TS e ajustar os dados do trem, treinará automaticamente vários modelos de série temporal como ARIMA, SARIMAX, Profeta FB, ONDE, e irá gerar o modelo de melhor desempenho que é adequado para nossa declaração de problema. A saída do modelo parece depender do tamanho do conjunto de dados. Se tentarmos aumentar o tamanho do conjunto de dados, o resultado pode definitivamente melhorar.
EndNote
Espero que tenha gostado deste artigo. Qualquer pergunta? Eu perdi algo? Por favor, contate-me LinkedIn Ou deixe um comentário abaixo. E finalmente, … Não precisa dizer,
Obrigado pela leitura!
Saúde!!
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





