
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Datenvisualisierung
Datenvisualisierungstechniken beinhalten die Erzeugung von grafischen oder bildlichen Darstellungen. von Dateien, Formular, das Ihnen hilft, die Informationen in einem bestimmten Datensatz zu verstehen. Diese Visualisierungstechnik zielt darauf ab, die Muster zu identifizieren, Trends, Korrelationen und Ausreißer von Datensätzen.
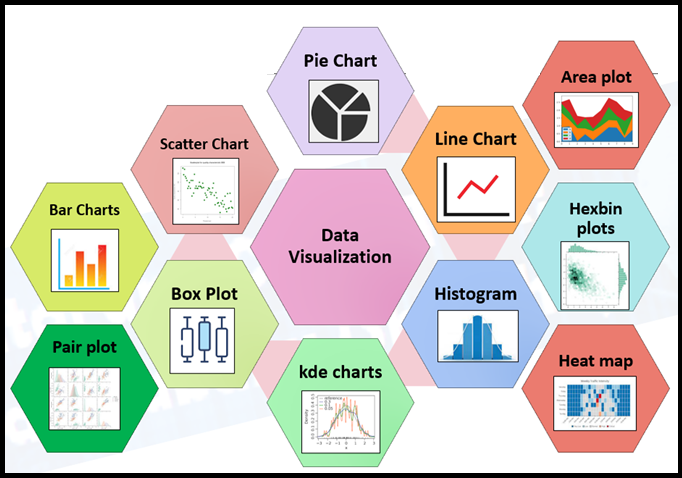
Vorteile der Datenvisualisierung
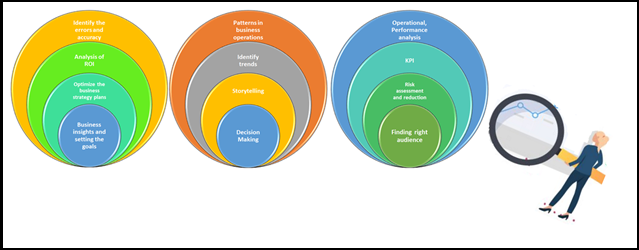
- Muster im Geschäftsbetrieb: Datenvisualisierungstechniken helfen uns, Muster von Geschäftsabläufen zu bestimmen. Die Problemstellung verstehen und die Lösungen in Form von Mustern identifizieren und zur Beseitigung eines oder mehrerer der inhärenten Probleme anwenden.
- Identifizieren Sie Geschäftstrends und interagieren Sie mit Daten: Sind Die Techniken helfen uns, Markttrends zu erkennen, indem wir Daten über die täglichen Geschäftsaktivitäten sammeln und Trendberichte erstellen., was hilft zu verfolgen, wie das Unternehmen den Markt beeinflusst. Damit wir den Wettbewerb und die Kunden verstehen. Sicherlich, das hilft, eine langfristige Perspektive zu haben.
- Erzählung und Entscheidungsfindung: Das Wissen um Storytelling aus verfügbaren Daten gehört zu den Nischenkompetenzen für die Unternehmenskommunikation, speziell für den Bereich Data Science, wer spielt eine entscheidende rolle. Mit der besten Visualisierung kann diese Rolle viel besser verbessert und die Ziele von Geschäftsproblemen erreicht werden.
- Verstehen Sie aktuelle Geschäftsinformationen und setzen Sie sich Ziele: Las empresas pueden comprender la información de los KPIKennzahlen, o Wichtige Leistungsindikatoren, Dabei handelt es sich um Kennzahlen, die von Organisationen verwendet werden, um ihren Erfolg beim Erreichen bestimmter Ziele zu bewerten. Diese Indikatoren ermöglichen es Ihnen, den Fortschritt zu überwachen und fundierte Entscheidungen zu treffen. Es gibt verschiedene Arten von KPIs, die je nach Branche und den strategischen Zielen des Unternehmens variieren kann. Die korrekte Umsetzung ist unerlässlich, um die Effizienz und Effektivität der Abläufe zu verbessern.... kommerziell, greifbare Ziele und Geschäftsstrategiepläne finden, damit sie die Daten für Geschäftsstrategiepläne für laufende Aktivitäten optimieren können.
- Betriebs- und Leistungsanalyse:
- Steigern Sie die Produktivität der Fertigungseinheit: Mit Hilfe von Visualisierungstechniken, Klarheit der KPIs, die die Produktivitätstrends von Fertigungseinheiten darstellen, und Leitlinien sollten die Produktivität der Anlage verbessern.
Datenvisualisierung in der Datenwissenschaft
Datenvisualisierungstechniken sind der wichtigste Teil der Data Science, daran wird kein zweifel sein. Und sogar im Bereich der Datenanalyse, Datenvisualisierung spielt eine wichtige Rolle. Wir werden dies ausführlich mit Hilfe von Python-Paketen besprechen und wie es im Ablauf des Data Science-Prozesses hilft.. Dies ist ein sehr interessantes Thema für alle Wissenschaftler und Datenanalysten..
ich. LiniendiagrammDas Liniendiagramm ist ein visuelles Werkzeug, das zur Darstellung von Daten im Zeitverlauf verwendet wird. Es besteht aus einer Reihe von Punkten, die durch Linien verbunden sind, die es Ihnen ermöglicht, Trends zu beobachten, Schwankungen und Muster in den Daten. Diese Art von Diagramm ist besonders nützlich in Bereichen wie der Wirtschaft, Meteorologie und wissenschaftliche Forschung, Dies erleichtert den Vergleich verschiedener Datensätze und die Identifizierung von Verhaltensweisen auf breiter Front..
Liniendiagramm ist eine einfache Datenvisualisierung in Python, das ist erhältlich in Matplotlib.
Liniendiagramme werden verwendet, um die Beziehung zwischen zwei Daten X und Y auf der jeweiligen Achse darzustellen. Sehen wir uns einige Beispiele an
Stichprobe #1
# Importieren der benötigten Bibliotheken
import matplotlib.pyplot als plt
numpy als np importieren
#einfaches Array
x = np.array([1, 2, 3, 4])
#y-Werte erzeugen
y = x*2
plt.plot(x, Ja)
plt.zeigen()
Stichprobe #2
x = np.array([1, 2, 3, 4])
y = np.array([2, 4, 6, 8])
plt.plot(x, Ja)
plt.xlabel("Uhrzeit in Stunden")
plt.ylabel("Entfernung in Km")
plt.titel("Zeit vs. Entfernung")
plt.zeigen()
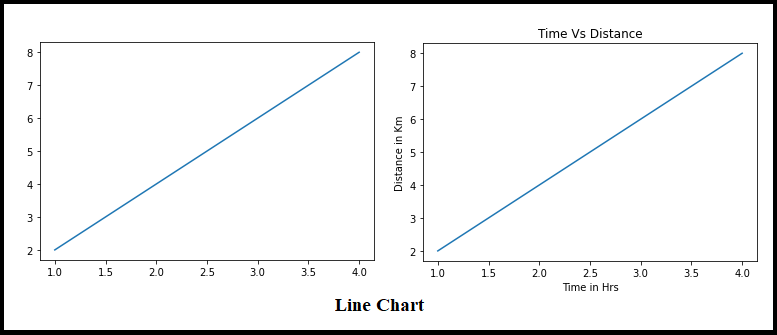
Liniendiagramm immer eine lineare Beziehung zwischen der X- und Y-Achse, wir können es im Bild oben sehen.
II.Histogramm
Das Histogramm ist die grafische Darstellung einer Reihe von Verteilungen numerischer Daten. Es ist ein bisschen wie BalkengrafikDas Balkendiagramm ist eine visuelle Darstellung von Daten, die rechteckige Balken verwendet, um Vergleiche zwischen verschiedenen Kategorien anzuzeigen. Jeder Balken stellt einen Wert dar, und seine Länge ist proportional zu ihm. Diese Art von Diagramm ist nützlich, um Trends zu visualisieren und zu analysieren, Erleichterung der Interpretation quantitativer Informationen. Es ist in verschiedenen Disziplinen weit verbreitet, wie z.B. Statistiken, Marketing und Forschung, Aufgrund seiner Einfachheit und Effektivität.... con el eje X y el eje Y representa los rangos y la frecuencia de los intervalos, beziehungsweise. Wie man diese Tabelle liest oder darstellt.
Sagen wir das Beispiel, Satz von Schülernoten in den unten aufgeführten Bereichen und Häufigkeiten. Hier konnten wir den Bereich und die Grenzfrequenz genau verstehen.
aus Matplotlib importieren Sie pyplot als plt

numpy als np importieren

Feige,ax = plt.subplots(1,1)

a = np.array([25,42,48,55,60,62,67,70,30,38,44,50,54,58,75,78,85,88,89,28,35,90,95])

ax.hist(ein, Behälter = [20,40,60,80,100])

ax.set_title("Student's Score")

ax.set_xticks([0,20,40,60,80,100])

ax.set_xlabel('Punkte erzielt')

ax.set_ylabel('Nein. von Studenten')

plt.zeigen()
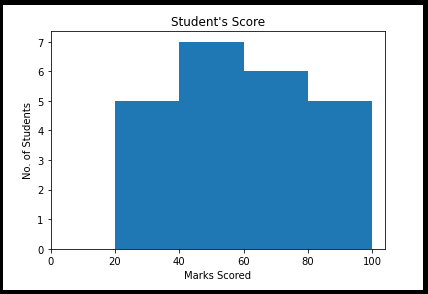
Histogrammeigenschaften
- das Histogramm wird verwendet, um ungewöhnliche Beobachtungen im Datensatz von give . zu erhalten.
- Gemessen auf einer Skalenskala von Zahlenwerten, die mit mehreren Datencontainern angegeben werden.
- Die Y-Achse repräsentiert die Anzahl von % Vorkommen in den Daten
- Die X-Achse repräsentiert Datenverteilungen.
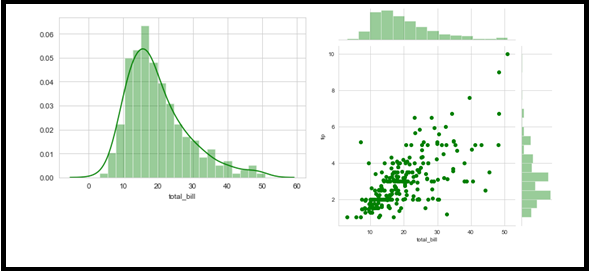
Show – Dies ähnelt dem Histogramm im Diagramm, aber mit Zusatzfunktionen. Und bringen Schätzung der Korndichte (WO).
Gemeinschaftsgrundstück – Eine Kombination aus Streuung und Histogramm.
Seegeboren als sns importieren
import matplotlib.pyplot als plt
aus Warnungen Filterwarnungen importieren
df = sns.load_dataset('Tips')
sns.distplot(df['total_bill'], wobei = wahr, Farbe="Grün", Behälter = 20)
sns.jointplot(x ='total_bill',Farbe="Grün", y ='tipp', Daten = df)
III Kreisdiagramm
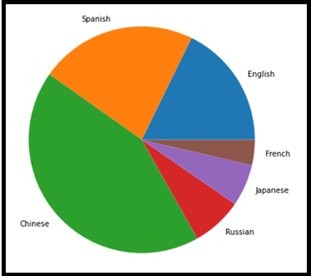
Dies ist ein sehr bekanntes Diagramm und ein Tortendiagramm, das ein Statistikdiagramm aus einer Datenreihe darstellt. Dies wird häufig in Geschäftspräsentationen verwendet, um Bestellungen darzustellen, Der Umsatz, Profite, Verluste, etc. Es besteht aus Teilen von Daten, die Teil der Sammlung derselben Menge sind, und Unterscheidung nach Zeichen. Jedes der Kuchenstücke wird als Keil mit Werten unterschiedlicher Größe bezeichnet.
Diese Tabelle wird häufig verwendet, um die Kompositionssammlung darzustellen.. Perfekt für kategoriale Datentypen.
aus Matplotlib importieren Sie pyplot als plt
numpy als np importieren
Sprache = ['Englisch', 'Spanisch', 'Chinesisch',
        'Russisch', 'Japanisch', 'Französisch']
Daten = [379, 480, 918, 154, 128, 77.2]
# Plot erstellen
fig = plt.figur(Feigengröße =(10, 7))
plt.pie(Daten, Etiketten = Sprache)
# Handlung anzeigen
plt.zeigen()
import matplotlib.pyplot als plt
numpy als np importieren
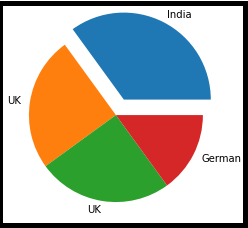
y = np.array([35, 25, 25, 15])
mylabels = ["Indien", "Vereinigtes Königreich", "Vereinigtes Königreich", "Deutsch"]
myexplodieren = [0.2, 0, 0, 0]
plt.pie(Ja, Etiketten = mylabels, explodieren = meinexplodieren)
plt.zeigen()
NS. Flächenparzelle
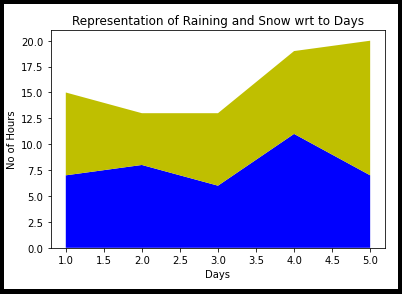
Dies ist einem Liniendiagramm mit Zäunen sehr ähnlich, die von einer Grenzlinie in verschiedenen Farben umgeben sind.. Repräsentation einfach von der Entwicklung der unen VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... numerisch.
import matplotlib.pyplot als plt

Tage = [1, 2, 3, 4, 5]

regnet = [7, 8, 6, 11, 7]

Schnee =  [8, 5, 7, 8, 13]

plt.stackplot(Tage, regnet, Schnee,Farben =['b', 'y'])

plt.xlabel('Tage')

plt.ylabel('Keine Stunden')

plt.titel('Repräsentation von Regen und Schnee in Bezug auf Tage')

plt.zeigen()
V. Streudiagramme
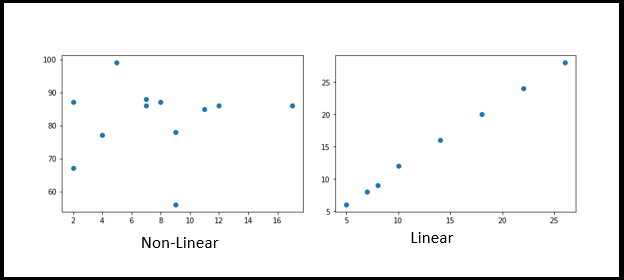
Streudiagramme werden verwendet, um Datenpunkte auf beiden Achsen zu zeichnen (horizontal und vertikal) y stellen dar, wie jede Achse miteinander korreliert. Hauptsächlich in der Implementierung von Data Science / Maschinelles Lernen und vor dem EDA-Prozess, wir müssen im Allgemeinen analysieren, wie abhängig und unabhängig sie aufeinander abgestimmt sind. Es könnte positiv oder negativ sein oder, manchmal, auf der Grafik verstreut sein.
import matplotlib.pyplot als plt
x = [5,7,8,7,2,17,2,9,4,11,12,9]
y = [99,86,87,88,67,86,87,78,77,85,86,56]
plt.streuung(x, Ja)
plt.zeigen()
import matplotlib.pyplot als plt

x = [5,7,8,10,14,18,22,26]

y = [6,8,9,12,16,20,24,28]

plt.streuung(x, Ja)

plt.zeigen()
WIR. Hexbin-Portionen
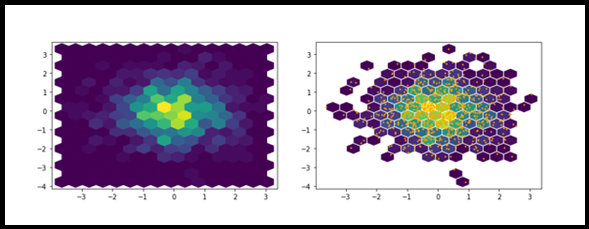
Das Ziel Hexbins wird verwendet, um die beiden Sätze numerischer Werte zu gruppieren. Hexbins hilft, die Visualisierung von Streudiagrammen zu verbessern. Denn für einen größeren Datensatz, ein AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen.... Crea un puñado de puntos confusos. Wir können dies mit Hexbins verbessern. Bietet zwei Rendering-Modi: 1. Koordinatenliste 2. Georäumliches Objekt.
numpy als np importieren
import matplotlib.pyplot als plt
x = np.zufällig.normal(Größe=(1, 1000))
y = z.B. zufällig.normal(Größe=(1, 1000))
plt.hexbin(x, Ja, Rastergröße=15)
plt.hexbin(x,Ja,Rastergröße=15, Hackfleisch 1 =, Kantenfarben="Weiß")

plt.streuung(x,Ja, s=2, c="Orange")

plt.zeigen()
VII. Heatmapein "Heatmap" ist eine grafische Darstellung, die Farben verwendet, um die Dichte von Daten in einem bestimmten Bereich anzuzeigen. Häufig in der Datenanalyse verwendet, Marketing und Verhaltensstudien, Diese Art der Visualisierung ermöglicht es Ihnen, Muster und Trends schnell zu erkennen. Durch chromatische Variationen, Heatmaps erleichtern die Interpretation großer Informationsmengen, dabei helfen, fundierte Entscheidungen zu treffen....
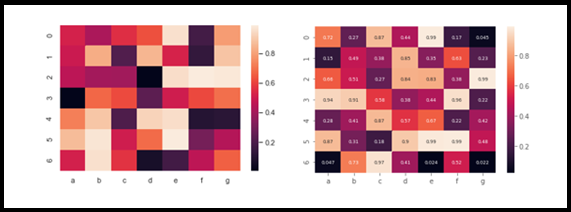
EIN Heatmap ist eine meiner Lieblingsvisualisierungstechniken unter den anderen Grafiken. Grundsätzlich, ein Satz variabler Korrelationen wird durch mehrere Schattierungen derselben Farbe dargestellt. Wie gewöhnlich, die dunkleren Töne in der Grafik repräsentieren die höheren Korrelationswerte als der hellere Ton. Diese Karte würde Datenwissenschaftlern helfen, herauszufinden, wie die Zielvariable mit anderen abhängigen Variablen im gegebenen Datensatz korreliert. Weniger korrelierte Variablen können für eine detailliertere Analyse entfernt werden, Wir könnten sagen, dass uns dies bei der Feature-Auswahl hilft. Dann gruppiere sie in X, Und als unser Ziel und gefolgt von Test und Teilung des Zuges.
import seaborn als sn
numpy als np importieren
Pandas als pd importieren
df=pd.DataFrame(np.zufällig.zufällig((7,7)),Spalten=['a','b','c','d','e','f','g'])
sn.heatmap(df)
sn.heatmap(df,annot=Wahr,annot_kws ={'Größe':7})
VIII. Box-Plot
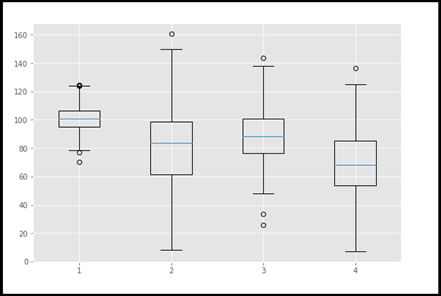
Ein Boxplot ist ein Diagrammtyp, der häufig im Data Science-Lebenszyklus verwendet wird., insbesondere bei der erklärenden Datenanalyse (EDA). Darstellung der Datenverteilung in Form von Quartilen oder Perzentilen. Q1 repräsentiert das erste Quartil (Perzentil 25), Q2 ist das zweite Quartil (Perzentil 50 / MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird....), Q3 repräsentiert das dritte Quartil (Q3) und Q4 repräsentiert das vierte Quartil oder den größten Wert.
Verwenden dieser Grafik, Ausreißer konnten wir sehr schnell und einfach identifizieren. Dies ist ein sehr effektiver Plot unter allen Plots. Deswegen, nach dem Entfernen von Ausreißern, der Datensatz muss einer Art statistischer Prüfung unterzogen und für eine detailliertere Analyse angepasst werden.
#import matplotlib.pyplot als plt
np.random.seed(10)
one=np.zufällig.normal(100,10,200)
two=np.zufällig.normal(80, 30, 200)
drei=np.zufällig.normal(90, 20, 200)
vier=np.zufällig.normal(70, 25, 200)
to_plot=[einer,zwei,drei,vier]
fig=plt.figur(1,Feigengröße=(9,6))
ax=fig.add_subplot()
bp=ax.boxplot(to_plot)
fig.savefig('boxplot.png',bbox_inches="fest")
IX. Portion
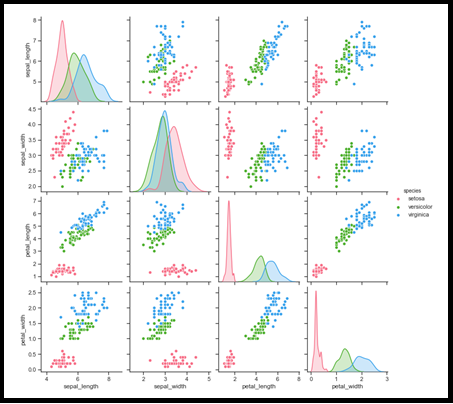
Ein Diagramm ist ein weiteres wichtiges Diagramm im Data Science-Lebenszyklus während des EDA-Prozesses., zu analysieren, wie Merkmale miteinander zusammenhängen, als Miniaturraster-basierte grafische Darstellung entlang der X- und Y-Achse, positiv korreliert oder negativ korreliert. . Dann, offensichtlich, wir könnten negativ korrelierte eliminieren, Berücksichtigung der positiv korrigierten Paare und Übergang zu einer detaillierteren Analyse. Dies ist der Heatmap sehr ähnlich, aber hier konnten wir die Beziehung mit bloßem Auge sehen. Das ist hier besonders. Ich hoffe du kannst dir das leisten. Nochmal, Dies ist der beste Weg, um den Rollenauswahlprozess zu durchlaufen.
Pandas als pd importieren
Seegeborenen als jdn importieren
aus Matplotlib importieren Sie pyplot als plt
df = sb.load_dataset('iris')
sb.set_style("Zecken")
jdn.pairplot(df,Farbton="Spezies",diag_kind = "wo",Art = "streuen",Palette = "husl")
plt.zeigen()
Der Liniengraph ist immer eine lineare Beziehung zwischen der X- und Y-Achse, wir stellen fest, dass das obige Bild
x. Balkengrafik
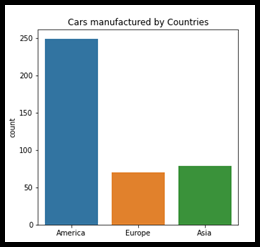
Ein Balkendiagramm oder Balkendiagramm ist im Allgemeinen ein sehr vertrautes Diagramm zur Darstellung kategorialer Daten mit rechteckigen Balken. Kann horizontal oder vertikal gezeichnet werden. Dieses Diagramm würde den Einfluss der Kategorie der Person auf den gegebenen Datensatz darstellen. Erster Blick zuerst. In der Grafik unten, "Amerika" hat viel mehr Einfluss als "Europa" und "Asien". Dies würde zu einer gewissen Beobachtung des Datensatzes führen und sich auf die Darstellung des Problems konzentrieren.
Feige, ax = plt.subplots(Feigengröße = (5, 5))


sns.countplot(x = df_cars.origin.values, data=df_cars)

Etiketten = [item.get_text() für Artikel in ax.get_xticklabels()]

Etiketten[0] = 'America'

labels[1] = 'Europe'

labels[2] = 'Asia'

ax.set_xticklabels(Etiketten)

ax.set_title("Autos hergestellt nach Ländern")

plt.zeigen()
Univariante – Bivariate und multivariate Analyse
Variantenanalyse im Data Science Prozess, könnte univariat sein (Ö) Bi-variabel (Ö) Multivariat.
- Univariante: immer nur eine Variable.
- Bi-variabel: zwei Variablen vergleichen.
- Multivariat: mehr als zwei Variablen vergleichen
Mit der Grafik kann man sehr gut auf die älteren Modelle verweisen / Visualisierung, die wir zu Beginn des Artikels besprochen haben. Schau einfach nochmal nach. Sicherlich, Sie können die Bedeutung dieser Datenvisualisierungstechniken verstehen.
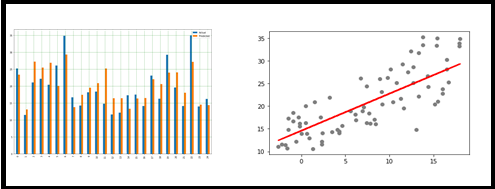
Vielen Dank für das Lesen dieses Artikels und ich denke, es ist nützlich für Sie.. und Sie können dies realisieren, wenn Sie sich vor der Modellauswahl für die Implementierung der Data Science-Lösung entscheiden. Auch Modellbewertungen und Vorhersagen sind schließlich das Ergebnis von Vergleichen. Wie unten in den Referenzbildern gezeigt.
Vielen Dank! Ein Mal noch. Wir melden uns bei einem weiteren interessanten Thema. Bis dahin tschüss! Beeindruckend! – Shanthababu
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





