
Dieser Artikel wurde als Eintrag für die . veröffentlicht Data Science Blogathon.
Einführung
Markov-Ketten sind außerordentlich nützlich für die Modellierung eines stochastischen Prozesses mit diskretem Raum in diskreten Zeiträumen verschiedener Domänen, wie z. B. der Finanzwirtschaft. (Aktienkursbewegung), NLP-Algorithmen (endliche Wandler, Hidden-Markov-Modell für die POS-Beschriftung), oder sogar in der physikalischen Technik ( Brownsche Bewegung).
Unter Berücksichtigung der immensen Nützlichkeit dieses Konzepts in verschiedenen Domänen und seiner grundlegenden Bedeutung für eine beträchtliche Anzahl von Algorithmen in der Datenwissenschaft, Wir werden in diesem Artikel die folgenden Aspekte der Markov-Kette behandeln:
- Markov-Kettenformulierung und intuitive Erklärung
- Aspekte und Eigenschaften einer Markov-Kette
- Anwendungen und Anwendungsfälle
Markov-Kettenformulierung und intuitive Erklärung
Um zu verstehen, was eine Markov-Kette ist, Sehen wir uns zuerst an, was ein stochastischer Prozess ist, da die Markov-Kette ein spezieller stochastischer Prozess ist.
Ein stochastischer Prozess ist definiert als eine Sammlung von Zufallsvariablen X = {xT: t∈T} definiert in einem gemeinsamen Wahrscheinlichkeitsraum, Werte in einer gemeinsamen Menge nehmen S (Zustandsraum), und indiziert durch eine Menge T, Nicht oft [0, ∞) und als Zeit gedacht (diskret bzw. stetig) (Oliver, 2009). Das bedeutet, dass wir Beobachtungen zu einem bestimmten Zeitpunkt haben und das Ergebnis zufällig ist VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern..... Einfach gesagt, ein stochastischer Prozess ist jeder Prozess, der die zeitliche Entwicklung eines zufälligen Phänomens beschreibt.
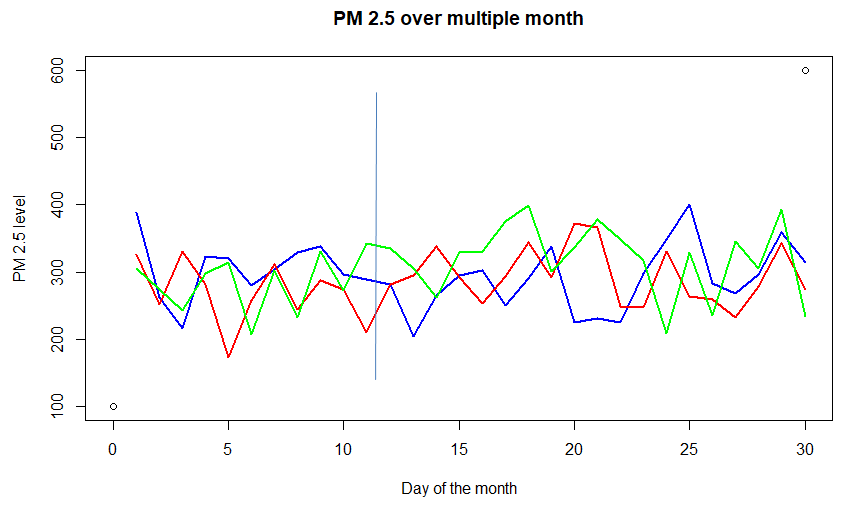
Betrachten Sie das obige Diagramm der Konzentration von PM (Feinstaub) 2.5 in der Luft über einer Stadt für verschiedene Monate. Jede der farbigen Linien -rot, Blau, und Grün - (namens Probenpfad) stellt eine zufällige Funktion der Zeit dar. Ebenfalls, bedenke jeden Tag (sagen 15. eines jeden Monats), es repräsentiert eine Zufallsvariable. Somit kann es als stochastischer Prozess betrachtet werden, d.h. ein Prozess, der nimmt unterschiedliche funktionale Eingaben zu unterschiedlichen Zeiten an. Dieses spezielle Beispiel ist ein Fall für zeitdiskret (da die Zeit nicht kontinuierlich ist, einmal täglich beobachtet) mit ein kontinuierlicher Zustand (es kann jeden positiven Wert annehmen, nicht unbedingt eine ganze Zahl).
Da wir nun eine grundlegende Intuition eines stochastischen Prozesses haben, Lassen Sie uns eines der nützlichsten mathematischen Konzepte für Data Science verstehen: Markov-Ketten!
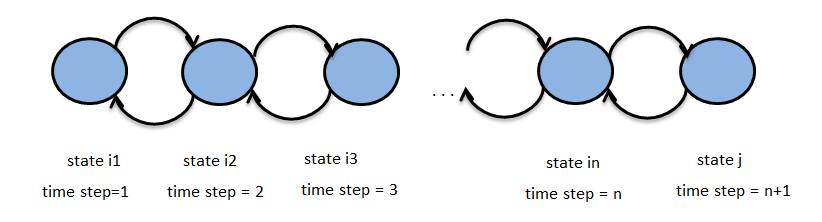
Die obige Abbildung stellt eine Markov-Kette dar, mit Zuständen i1, ich2 ,… , ichn , j für Zeitschritte 1, 2, .., n+1. Lassen {MITn}n∈N sei der obige stochastische Prozess mit Zustandsraum S. N ist hier die Menge der ganzen Zahlen und repräsentiert die Zeiteinstellung und Zn repräsentiert der Staat der Markov-Kette zum Zeitpunkt n. Angenommen, wir haben die Eigenschaft :
P(MITn+1 = j | MITn = ichn , MITn-1 = ichn-1 , … , MIT1 = ich1) = P(MITn+1 = j | MITn = ichn)
dann {MITn}n∈N heißt Markov-Kette.
Dieser Begriff P(MITn+1 = j | MITn= ichn) wird genannt Übergangswahrscheinlichkeit. Somit können wir intuitiv erkennen, dass um die Markov-Kette probabilistisch zu beschreiben, wir brauchen (ein) die Anfangszustandsverteilung und (B) Übergangswahrscheinlichkeiten.
Nehmen wir die unten gezeigte Markov-Kette, um diese beiden Begriffe formaler zu verstehen,
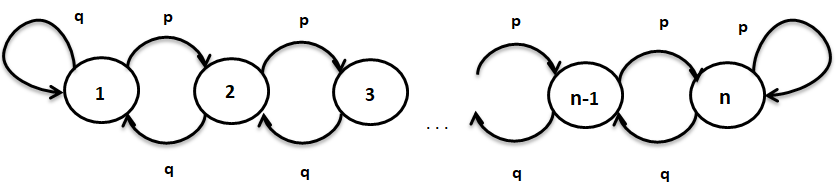
In der Markov-Kette oben, Staaten sind 1, 2, …, n und die Wahrscheinlichkeit, von einem beliebigen Zustand k nach k+1 . zu gelangen (für k =1, 2, …, n-1) ist p und der Übergang vom Zustand k nach k-1 ist q, wo"WO" ist ein Begriff im Deutschen, der übersetzt wird als "wo" in Spanisch. Wird verwendet, um Fragen über den Standort von Personen zu stellen, Objekte oder Ereignisse. In grammatikalischen Zusammenhängen, Es kann als Adverb des Ortes fungieren und ist grundlegend für die Bildung von Fragen. Die korrekte Anwendung ist in der alltäglichen Kommunikation und im Sprachunterricht unerlässlich, Erleichterung des Verständnisses und des Austauschs von Informationen über Positionen und Richtungen.... q = 1-p.
- Die Anfangszustandsverteilung ist definiert als
Pi(0) = [P(x0=1), P(x0=2), … , P(x0 = n)]
Der vorherige Ausdruck ist ein Zeilenvektor mit Element, das die Wahrscheinlichkeit angibt, dass die Markov-Kette den Zustand i . hat, wo ich = 1, 2,…, n. Alle Elemente dieses Vektors addieren sich zu 1.
- das Übergangswahrscheinlichkeitsmatrix es ist wie unten gezeigt :
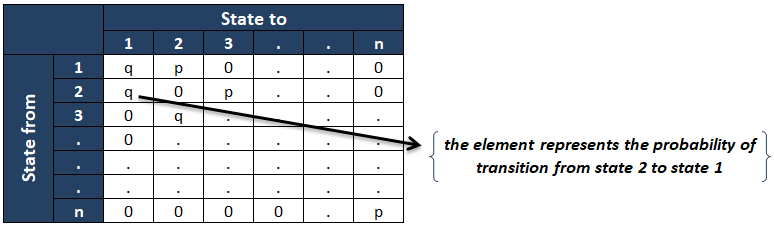
El ijNS Element der Übergangswahrscheinlichkeitsmatrix repräsentiert die die bedingte Wahrscheinlichkeit der Kette befindet sich im Zustand j, da sie sich zum vorherigen Zeitpunkt im Zustand i befand. Wenn die Übergangswahrscheinlichkeitsmatrix nicht von abhängt „n“ (Wetter), dann heißt der String das Homogene Markov-Kette.
Aspekte und Eigenschaften einer Markov-Kette
In diesem Abschnitt, Wir werden die folgenden Hauptaspekte einer Markov-Kette sehen:
- Zeitpunkt des ersten Treffers: gl(k)
- Durchschnittliche Wirkungszeit (Absorptionszeit): hEIN(k)
Der Zweck der vorherigen beiden Analysen besteht darin, dass, wenn wir eine Menge von gewünschten Zuständen haben (sagen wir A), und wir wollen berechnen, wie lange es dauert, den gewünschten Zustand zu erreichen.
Erste Stunde Schlag
Sich vorstellen, wenn wir die Wahrscheinlichkeit wissen wollen (bedingt) dass unsere Markov-Kette, die in einem Anfangszustand k . beginnt, Zustand erreichen l (einer von vielen gewünschten Zuständen in A) solange es einen beliebigen Zustand in A . erreicht. Wie machen wir es? das?
Lassen Sie uns verstehen, indem wir einige grundlegende Begriffe definieren. Lass TEIN sei die früheste Zeit, die es braucht, um einen der Zustände in Menge A zu erreichen und k sei ein Zustand im Zustandsraum, aber nicht in A.
Lass gl(k) definiert werden als die bedingte Wahrscheinlichkeit, den Zustand l zum Zeitpunkt T . zu erreichenEIN vom Zustand k.
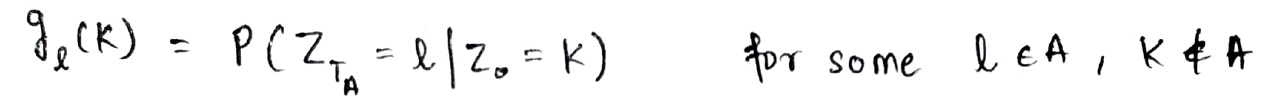
Jetzt, mit der Markov-Eigenschaft, Betrachten wir den Zustand in der Zeit = 0 zum Zustand in der Zeit = TEIN wie man den Zustand rechtzeitig passiert = 0 zum Zustand in der Zeit = 1 und dann von Staat zu Zeit gehen = 1 zum Zustand in der Zeit = TA. Das gleiche ist unten dargestellt:
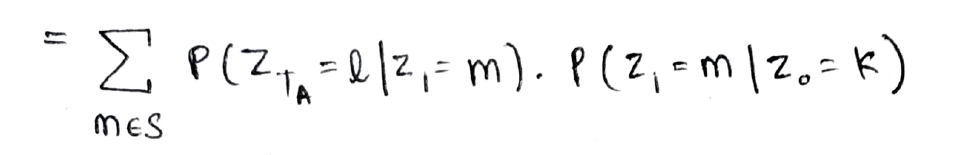
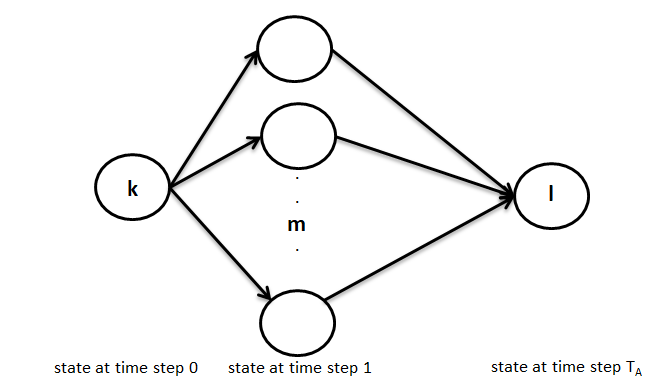
Die obige Gleichung kann grafisch wie unten gezeigt interpretiert werden, nämlich, im ersten Schritt kann man in einem Schritt vom Zustand k zu jedem der Zustände m gehen und dann in TEIN-1 Übergang vom Zustand m zum gewünschten Zustand l.
Jetzt, der erste Term kann als g . dargestellt werdenl(m) und der zweite Term repräsentiert die Wahrscheinlichkeit des Übergangs vom Zustand k in den Zustand m
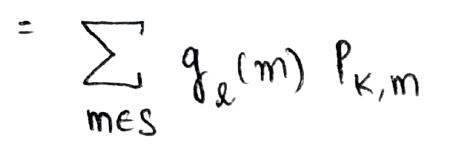
Auf diese Weise berechnen wir die gewünschte Wahrscheinlichkeit rekursiv und der oben verwendete Ansatz heißt Erster Schritt Analyse (wie wir es in Bezug auf den ersten Schritt analysieren, nimmt der Zustand in der Zeit = 0 zum Zustand in der Zeit = 1)
Durchschnittliche Trefferzeit
Verwenden eines ähnlichen Ansatzes wie oben, Wir können auch die durchschnittliche Zeit berechnen (erwartet) um eine gewünschte Menge von Zuständen zu erreichen (sagen wir A) aus einem Zustand k aus A.
Definamos hEIN(k) als die erwartete Zeit, die benötigt wird, um aus dem Zustand k . eine Menge A zu erreichen. Dies ist wie unten gezeigt definiert:
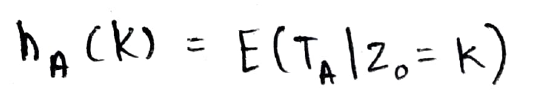
Jetzt wissen wir, was der erste Schritt der Analyse ist, Warum nicht wieder verwenden?
Dann, jetzt schreiben wir den Erwartungsterm in Bezug auf den ersten Schritt (nämlich, Zustand Z . erreichen1) Wie nachfolgend dargestellt:
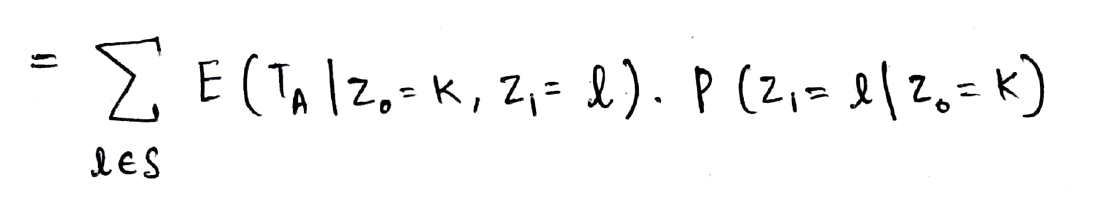
Jetzt, mit der Markov-Eigenschaft, wir können das Z eliminieren0 Begriff wie wir den Zustand in Z . kennen1. Der zweite Term im obigen Produkt ist die Übergangswahrscheinlichkeit vom Zustand k in den Zustand l (Wir haben dieses Konzept so oft gesehen, dass es sich jetzt wie eine Berechnung anfühlt 2 + 2 = 4 🙂)
Beachten Sie, dass der Erwartungsterm unten in Bezug auf Z1 (und nicht Z0) und deshalb können wir es nicht direkt als h . schreibenEIN(k). Deswegen, wir verwenden einen mathematischen trick, Wir fügen hinzu 1 in Erwartung und wir subtrahieren 1 auch damit wir den Zustand mathematisch schreiben können als Z0 = l
Und jetzt können wir es als h . schreibenEIN(k).
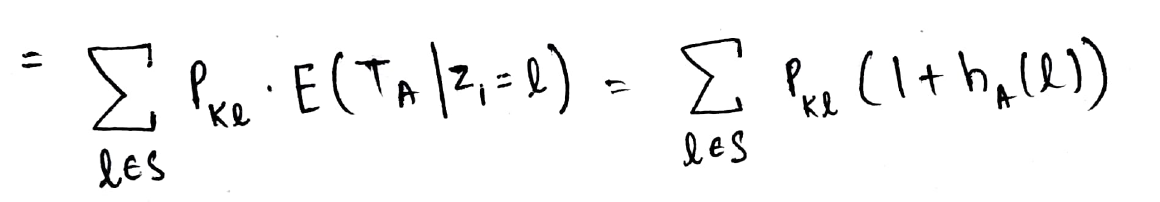
Auf diese Weise berechnen wir rekursiv die gewünschte Erwartung!!
Jetzt kennen wir den grundlegenden Ansatz zur Ableitung einer beliebigen Markov-Eigenschaft mit den beiden neuen Tools, die wir haben: Verständnis von Übergangswahrscheinlichkeitsmatrix Ja Analyseansatz im ersten Schritt.
Anwendungen und Anwendungsfälle
Da wir uns jetzt mit dem Konzept und den Aspekten einer Markov-Kette vertraut machen, Lassen Sie uns die folgenden Anwendungs- und Anwendungsfälle von Markov-Ketten untersuchen und intuitiv verstehen.
- PNL: Hidden-Markov-Modell für die Point-of-Sale-Kennzeichnung
- Random Walk wie eine Markov-Kette
PNL: Hidden-Markov-Modell für die Point-of-Sale-Kennzeichnung
Beschriftung von Wortarten (POS) ist eine wichtige Anwendung von NLP. Das Ziel bei diesen Problemen besteht darin, jedes Wort in einem bestimmten Satz mit einem geeigneten POS zu versehen (Substantiv, Verb, Adverb, etc.). Im Modell, wir haben Label-Übergangswahrscheinlichkeiten, nämlich, da das Label des vorherigen Wortes t heißti-1, Die tich wird das Label des aktuellen Wortes sein. Und das zweite Konzept des Modells ist die Wahrscheinlichkeit, dass bei gegebenem Label des aktuellen Wortes tich, das Wort wird w . seinich. Um es klarer auszudrücken: das Hidden-Markov-Modell ist eine Art von Generative Modelle (Sätze) in denen die versteckten Zustände (hier POS-Etiketten) gelten als gegeben und die beobachteten Daten als generiert.
Die tich auf der Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... Das Folgende bezieht sich auf die POS-Tags für den YW-Statusich bezieht sich auf die von den Staaten herausgegebenen Worte.
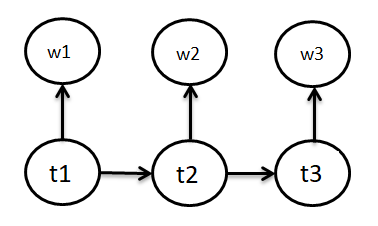
Jetzt, Schauen wir uns das Element des Modells genauer an, um den Markov-Prozess darin noch deutlicher zu sehen. Die Elemente des Hidden-Markov-Modells sind:
- Eine Reihe von Staaten: hier POS-Etiketten
- Die Ausgabe jedes Staates: hier ‚Wort‘
- Ausgangszustand: hier beginne ich den satz
- Zustandsübergangswahrscheinlichkeit: hier P (TNorden | Tn-1)
Abgesehen davon, dass es in diesem Aspekt von NLP sehr nützlich ist,, Finite-State-Wandler und viele andere Algorithmen basieren auf Markov-Ketten.
Zielloser Spaziergang
Ein weiteres interessantes Phänomen ist der Random Walk, was wiederum eine Markov-Kette ist.
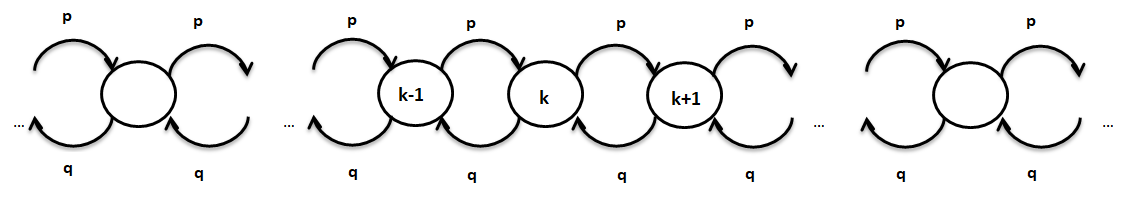
Betrachten wir den Random Walk, wie oben gezeigt, nämlich, Bewegung einen Schritt vorwärts aus jedem Zustand kann mit Wahrscheinlichkeit p erfolgen und Bewegung um einen Schritt zurück kann mit Wahrscheinlichkeit q . erfolgen. Hier die Vorwärtsbewegung vom Zustand k nach k + 1 hängt nur vom Zustand k ab und, Daher, Random Walk ist eine Markov-Kette.
Jetzt, Lassen Sie uns einen Schritt nach vorne machen und den Random Walk als eine Markov-Kette mithilfe von Simulation verstehen. Hier betrachten wir den Fall des eindimensionalen Spaziergangs, wo die Person beliebig groß vor- oder zurücktreten kann (Größe> = 1) mit gleicher Wahrscheinlichkeit.
Hier, ich habe verfolgt 30 Random Walks, um eine Intuition rund um das Phänomen zu entwickeln. Hier, der Anfangszustand der Markov-Kette ist 0 (Null kumulative Schritte anfangs). Dinge zu beachten sind:
- Zustandsraum und Sollzeit sind beide diskret (ganze Zahlen)
- Es ist visuell klar, dass zu einem bestimmten Zeitschritt, der nächste Zustand wird nur durch den aktuellen Zustand bestimmt und die Zeitschritte hinter dem aktuellen Zeitschritt helfen nicht bei der Vorhersage, wo sich der Kettenzustand im nächsten Zeitschritt befinden wird.
- Da die Wahrscheinlichkeit einer Vorwärtsbewegung gleich der einer Rückwärtsbewegung ist, der Erwartungswert der kumulierten Schrittzahl ist 0.
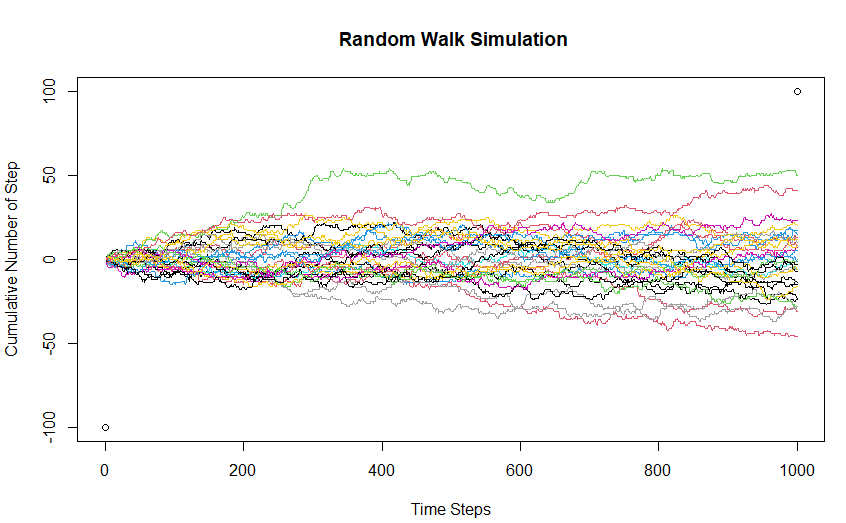
Der Code zum Simulieren eines einfachen Random Walk in R ist unten angegeben:
Handlung(C(0,1000),C(-100,100), xlab = "Zeitschritte", ylab = "Kumulative Anzahl von Schritten" , Haupt = " Random-Walk-Simulation")
zum (ich bin dabei 1:30) {
  x <- as.integer(rnorm(1000))
  Linien(cumsum(x), Typ = "l", col=sample(1:10,1))
}
Die Markov-Kette ist eine sehr leistungsfähige und effektive Technik zur Modellierung eines stochastischen Prozesses diskreter Zeit und Raum.. Das Verständnis der beiden vorherigen Anwendungen zusammen mit dem erläuterten mathematischen Konzept kann verwendet werden, um jede Art von Markov-Prozess zu verstehen.
Hinweis zum Autor: Ich bin PGDBA-Student (Diplom in Betriebswirtschaftslehre) und IIM Kalkutta, IIT Kharagpur und ISI Kolkata, und ich habe meinen B.TECH von IIT DELHI abgeschlossen und habe eine Berufserfahrung von ~ 3,5 Jahre in Advanced Analytics.
Für Diskussionen zum Thema stehe ich gerne zur Verfügung unter Parth Tyagi | LinkedIn oder schreib mir eine E-Mail an [E-Mail geschützt]
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





