
Überblick
- Relationale Datenbanken sind allgegenwärtig, aber was passiert, wenn Sie Ihre Infrastruktur skalieren müssen??
- Wir werden die Rolle von Spark SQL in dieser Situation besprechen und verstehen, warum es ein so nützliches Werkzeug zum Lernen ist.
- Dieses Tutorial zeigt auch die Funktionsweise von Spark SQL anhand einer Python-Fallstudie
Einführung
Fast alle Organisationen verwenden relationale Datenbanken für verschiedene Aufgaben, von der Verwaltung und Verfolgung einer großen Menge an Informationen bis hin zur Organisation und Verarbeitung von Transaktionen. Es ist eines der ersten Konzepte, die uns in der Programmierschule beigebracht wurden.
Und seien wir dankbar dafür, denn dies ist ein entscheidender Gang in den Fähigkeiten eines Datenwissenschaftlers!! Man kommt einfach nicht zurecht, ohne zu wissen, wie Datenbanken funktionieren. Es ist ein Schlüsselaspekt jedes maschinelles Lernen Luftzug.
Strukturierte Abfragesprache (SQL) ist mit Abstand die beliebteste Sprache, wenn es um Datenbanken geht. Im Gegensatz zu anderen Programmiersprachen, ist leicht zu erlernen und hilft uns beim Einstieg in unseren Datenextraktionsprozess. Für die meisten Data-Science-Jobs, SQL-Kenntnisse sind höher als die der meisten anderen Programmiersprachen.

Aber es gibt eine große Herausforderung mit SQL: wird es schwer haben, es beim Umgang mit riesigen Datensätzen zum Laufen zu bringen. Hier nimmt Spark SQL einen vorderen Platz ein und schließt die Lücke.. Darüber werde ich im nächsten Abschnitt mehr sprechen..
Dieses praktische Tutorial führt Sie in die Welt von Spark SQL ein, wie funktioniert es, Welche verschiedenen Funktionen bietet es und wie können Sie es mit Python implementieren?. Wir werden auch über ein wichtiges Konzept sprechen, das Ihnen in Interviews häufig begegnet.: der Katalysatoroptimierer.
Lasst uns beginnen!
Notiz: Wenn Sie völlig neu in der SQL-Welt sind, Ich kann folgenden Kurs wärmstens empfehlen:
Inhaltsverzeichnis
- Herausforderungen bei der relationalen Datenbankskalierung
- Spark SQL-Übersicht
- Spark SQL-Funktionen
- Wie führt Spark SQL eine Abfrage aus??
- Was ist ein Catalyst Optimizer??
- Ausführen von SQL-Befehlen mit Spark
- Gebrauch von Apache SparkApache Spark ist eine Open-Source-Datenverarbeitungs-Engine, die die schnelle und effiziente Analyse großer Informationsmengen ermöglicht. Sein Design basiert auf dem Speicher, Dies optimiert die Leistung im Vergleich zu anderen Batch-Verarbeitungstools. Spark wird häufig in Big-Data-Anwendungen verwendet, Maschinelles Lernen und Echtzeitanalysen, Dank seiner Benutzerfreundlichkeit und... Skala
Herausforderungen bei der relationalen Datenbankskalierung
Die Frage ist, warum sollte ich Spark SQL lernen?? Ich habe das schon kurz erwähnt, aber schauen wir uns das jetzt etwas genauer an.
Relationale Datenbanken für ein großes Projekt (maschinelles Lernen) enthalten Hunderte oder vielleicht Tausende von Tabellen und die meisten Merkmale in einer Tabelle werden anderen Merkmalen in anderen Tabellen zugeordnet. Diese Datenbanken sind so konzipiert, dass sie nur auf einer einzigen Maschine laufen, um die Regeln der Tabellenzuordnungen beizubehalten und die Probleme der verteilten Datenverarbeitung zu vermeiden..
Dies wird für Organisationen oft zu einem Problem, wenn sie mit diesem Design skalieren möchten.. Es würde komplexere und teurere Hardware mit deutlich mehr Verarbeitungs- und Speicherkapazität erfordern. Wie du dir vorstellen kannst, Das Upgrade von einfacherer Hardware auf komplexere Hardware kann eine große Herausforderung sein.
Eine Organisation muss möglicherweise ihre Website für einige Zeit offline nehmen, um die erforderlichen Änderungen vorzunehmen. Während dieser Zeit, würde das Geschäft mit Neukunden verlieren, die sie möglicherweise hätten gewinnen können.
Was ist mehr, mit steigendem Datenvolumen, Unternehmen haben Schwierigkeiten, diese riesige Datenmenge mit traditionellen relationalen Datenbanken zu handhaben. Hier kommt Spark SQL ins Spiel..
Spark SQL-Übersicht
„„
~
Hadoop und die Frameworks Karte verkleinernMapReduce ist ein Programmiermodell, das entwickelt wurde, um große Datensätze effizient zu verarbeiten und zu generieren. Unterstützt von Google, Bei diesem Ansatz wird die Arbeit in kleinere Aufgaben aufgeteilt, die auf mehrere Knoten in einem Cluster verteilt sind. Jeder Knoten verarbeitet seinen Teil und dann werden die Ergebnisse kombiniert. Mit dieser Methode können Sie Anwendungen skalieren und große Informationsmengen verarbeiten, in der Welt von Big Data von grundlegender Bedeutung zu sein.... existieren schon lange im Bereich der Big-Data-Analyse. Diese Frames erfordern jedoch viele Lese- und Schreibvorgänge auf einer Festplatte, was sie in Bezug auf Zeit und Geschwindigkeit sehr teuer macht.
Apache Spark ist heute das effizienteste Datenverarbeitungs-Framework in Unternehmen. Es stimmt, dass die Kosten für Spark hoch sind, da es viel RAM für die In-Memory-Berechnung benötigt, aber es ist immer noch ein Favorit unter Data Scientists und Big Data Engineers.
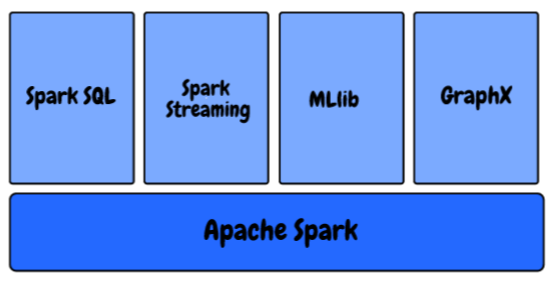
Im Spark-Ökosystem, wir haben die folgenden komponenten:
- MLlib: Dies ist die skalierbare Bibliothek für maschinelles Lernen von Spark, die hochwertige Algorithmen für die Regression bietet, Clusterbildung, Einstufung, etc. In diesem Artikel können Sie mit dem Erstellen von Pipelines für maschinelles Lernen mit der MLlib von Spark beginnen: So erstellen Sie Pipelines für maschinelles Lernen mit PySpark?
- Spark-Streaming: Wir generieren derzeit Daten in einer noch nie dagewesenen Geschwindigkeit und Größenordnung. Wie stellen wir sicher, dass unsere Machine-Learning-Pipeline weiterhin Ergebnisse liefert, sobald die Daten generiert und gesammelt werden?? Erfahren Sie, wie Sie mit PySpark mit einem Modell für maschinelles Lernen Vorhersagen zur Datenübertragung treffen?
- GraphX: Es ist eine Spark-API für Grafiken, eine Netzwerkgrafik-Engine, die parallele Grafikberechnungen unterstützt.
- Spark-SQL: Dies ist ein verteiltes Framework für die strukturierte Datenverarbeitung von Spark
Wir wissen, dass relationale Datenbanken auch die Beziehungen zwischen den verschiedenen Variablen sowie den verschiedenen Tabellen speichern und so konzipiert sind, dass sie komplexe Abfragen bewältigen können..
Spark SQL ist eine erstaunliche Kombination aus relationaler Verarbeitung und funktionaler Spark-Programmierung.. Bietet Unterstützung für mehrere Datenquellen und ermöglicht SQL-Abfragen, Daraus ergibt sich ein sehr leistungsfähiges Werkzeug für die Analyse strukturierter Daten in großem Maßstab.
Spark SQL-Funktionen
Spark SQL hat eine Menge toller Funktionen, Aber ich wollte einige Tasten hervorheben, die Sie in Ihrer Funktion häufig verwenden werden:
- Strukturdaten in Spark-Programmen abfragen: Die meisten von Ihnen kennen vielleicht schon SQL. Deswegen, Sie müssen nicht lernen, wie man eine komplexe Funktion in Python oder Scala definiert, um Spark zu verwenden. Sie können genau dieselbe Abfrage verwenden, um die Ergebnisse Ihrer größten Datensätze zu erhalten!!
- Kompatibel mit BienenstockHive ist eine dezentrale Social-Media-Plattform, die es ihren Nutzern ermöglicht, Inhalte zu teilen und sich mit anderen zu verbinden, ohne dass eine zentrale Behörde eingreifen muss. Verwendet die Blockchain-Technologie, um die Datensicherheit und das Eigentum zu gewährleisten. Im Gegensatz zu anderen sozialen Netzwerken, Hive ermöglicht es Nutzern, ihre Inhalte durch Krypto-Belohnungen zu monetarisieren, die die Schaffung und den aktiven Austausch von Informationen fördert....: Kein Solo-SQL, Sie können jedoch auch die gleichen Hive-Abfragen mit Spark SQL Engine ausführen. Ermöglicht volle Kompatibilität mit aktuellen Hive-Abfragen.
- Eine Möglichkeit, auf die Daten zuzugreifen: In typischen Projekten auf Unternehmensebene, hat keine gemeinsame Datenquelle. Stattdessen, muss mit verschiedenen Arten von Dateien und Datenbanken umgehen. Spark SQL unterstützt fast alle Dateitypen und bietet Ihnen eine gemeinsame Möglichkeit, auf eine Vielzahl von Datenquellen zuzugreifen, als Hive, Euro, Parkett, JSONJSON, o JavaScript-Objekt-Notation, Es handelt sich um ein leichtgewichtiges Datenaustauschformat, das für Menschen leicht zu lesen und zu schreiben ist, und für Maschinen einfach zu analysieren und zu generieren. Es wird häufig in Webanwendungen verwendet, um Informationen zwischen einem Server und einem Client zu senden und zu empfangen. Seine Struktur basiert auf Schlüssel-Wert-Paaren, Dadurch ist es vielseitig einsetzbar und in der Softwareentwicklung weit verbreitet.. und JDBC
- Leistung und Skalierbarkeit: Bei der Arbeit mit großen Datensätzen, Es besteht die Möglichkeit, dass zwischen der Ausführung der Abfrage Fehler auftreten. Spark SQL unterstützt volle Fehlertoleranz bei der Abfrage, damit wir sogar mit tausend Knoten gleichzeitig arbeiten können
- Benutzerdefinierte Funktionen: UDF ist eine Spark SQL-Funktion, die neue spaltenbasierte Funktionen definiert, die das Spark SQL-Vokabular für die Transformation von Datensätzen erweitern
Wie führt Spark SQL eine Abfrage aus??
Wie funktioniert Spark SQL?, im Wesentlichen? Lassen Sie uns den Prozess in diesem Abschnitt verstehen.
- Analyse: Zuerst, wenn du etwas konsultierst, Spark SQL findet die zu berechnende Beziehung. Es wird mit einem abstrakten Syntaxbaum berechnet (AST) wo Sie die korrekte Verwendung der Elemente überprüfen, die zum Definieren der Abfrage verwendet werden, und dann einen logischen Plan zur Ausführung der Abfrage erstellen.

- Logische Optimierung: In diesem nächsten Schritt, regelbasierte Optimierung wird auf den logischen Plan angewendet. Verwenden Sie Techniken wie:
- Daten im Voraus filtern, wenn die Abfrage a . enthält wo Klausel
- Verwenden Sie die IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... verfügbar in den Tabellen, da es die Leistung verbessern kann, Ja
- Sogar dafür sorgen, dass die verschiedenen Datenquellen in der effizientesten Reihenfolge zusammengeführt werden.
- Raumplanung: In diesem Schritt, ein oder mehrere physische Pläne werden unter Verwendung des logischen Plans gebildet. Spark SQL wählt dann den Plan aus, der die Abfrage am effizientesten ausführen kann, nämlich, weniger Rechenressourcen verbrauchen.
- GENERATION-Code: Im letzten Schritt, Spark SQL generiert Code. Es beinhaltet das Generieren eines Java-Bytecodes, der auf jedem Computer ausgeführt werden soll. Catalyst verwendet eine spezielle Funktion der Scala-Sprache namens „Quasizitate“ um die Codegenerierung zu erleichtern.

Was ist ein Catalyst Optimizer??
Optimierung bedeutet, das bestehende System oder den Workflow so zu aktualisieren, dass es effizienter arbeitet, bei geringerem Ressourcenverbrauch. Ein Optimierer bekannt als Katalysator-Optimierer ist in Spark SQL implementiert und unterstützt regelbasierte und kostenbasierte Optimierungstechniken.
Bei der regelbasierten Optimierung, Wir haben ein Regelwerk definiert, das bestimmt, wie die Abfrage ausgeführt wird. Es wird die vorhandene Abfrage besser umschreiben, um die Leistung zu verbessern.
Zum Beispiel, Nehmen wir an, es ist ein Index auf dem Tisch verfügbar. Später, der Index wird für die Abfrageausführung gemäß den Regeln und Filtern verwendet WO wird nach Möglichkeit zuerst auf die Ausgangsdaten angewendet (anstatt sie zuletzt anzuwenden).
Was ist mehr, Es gibt einige Fälle, in denen die Verwendung eines Index eine Abfrage verlangsamt. Wir wissen, dass es nicht immer möglich ist, mit einem definierten Regelwerk immer gute Entscheidungen zu treffen, Wahrheit?
Hier ist das Problem: regelbasierte Optimierung berücksichtigt keine Datenverteilung. Hier setzen wir auf einen kostenbasierten Optimizer. Verwenden Sie Statistiken über die Tabelle, Ihre Indizes und Datenverteilung, um bessere Entscheidungen zu treffen.
Ausführen von SQL-Befehlen mit Spark
Zeit zu codieren!
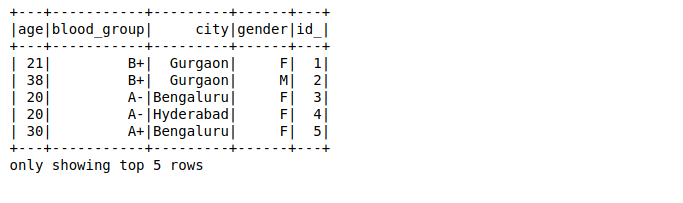
Ich habe einen zufälligen Datensatz erstellt von 25 Millionen Zeilen. Sie können herunterladen den vollständigen Datensatz hier. Wir haben eine Textdatei mit durch Kommas getrennten Werten. Dann, erste, wir importieren die benötigten Bibliotheken, Wir werden den Datensatz lesen und sehen, wie Spark die Daten in Partitionen aufteilt:

Hier,
- Der erste Wert in jeder Zeile ist das Alter der Person (das muss eine ganze Zahl sein)
- Der zweite Wert ist die Blutgruppe der Person (das muss eine Zeichenfolge sein)
- Der dritte und vierte Wert sind Stadt und Geschlecht (beides sind ketten), Ja
- Der Endwert ist eine ID (die vom ganzzahligen Typ ist)
Wir werden die Daten in jeder Zeile mithilfe von Spark-Zeilen einem bestimmten Datentyp und Namen zuordnen:


Dann, Wir erstellen einen Datenrahmen mit den geparsten Zeilen. Unser Ziel ist es, die Werte der zählen für das VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Geschlecht durch die Verwendung eines einfachen gruppiere nach Funktion im Datenrahmen:
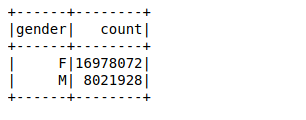

Es hat ungefähr gedauert 26 ms, um die Anzahl der Werte von zu berechnen 25 Millionen Zeilen mit einer groupby-Funktion im Datenrahmen. Sie können die Zeit berechnen mit %%Wetter in der Privatzelle seines Jupyter-Notizbuchs.
Jetzt, Wir werden dieselbe Abfrage mit Spark SQL durchführen und sehen, ob sie die Leistung verbessert oder nicht.
Zuerst, Sie müssen den Datenrahmen mit der Funktion als temporäre Tabelle registrieren registerTempTable. Das erstellt eine Tabelle im Speicher, die nur den Umfang hat ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... in dem sie erstellt wurde. Die Lebensdauer dieser temporären Tabelle ist nur auf eine SitzungDas "Sitzung" Es ist ein Schlüsselbegriff im Bereich der Psychologie und Therapie. Bezieht sich auf ein geplantes Treffen zwischen einem Therapeuten und einem Klienten, wo Gedanken erforscht werden, Emotionen und Verhaltensweisen. Diese Sitzungen können in Länge und Häufigkeit variieren, und ihr Hauptzweck ist es, persönliches Wachstum und Problemlösung zu erleichtern. Die Wirksamkeit der Sitzungen hängt von der Beziehung zwischen dem Therapeuten und dem Therapeuten ab... Es wird gespeichert mit Hive In-Memory-Spaltenformat die hochgradig für relationale Daten optimiert ist.
Was ist mehr, Sie müssen nicht einmal komplexe Funktionen schreiben, um Ergebnisse zu erhalten, wenn Sie mit SQL vertraut sind!! Hier, Sie müssen nur dieselbe SQL-Abfrage übergeben, um die gewünschten Ergebnisse bei größeren Daten zu erhalten:

Es hat nur ungefähr gedauert 18 ms berechnet die Anzahl der Werte. Das ist viel schneller als selbst ein Spark-Datenrahmen.
Dann, Wir werden eine weitere SQL-Abfrage durchführen, um das Durchschnittsalter in einer Stadt zu berechnen:
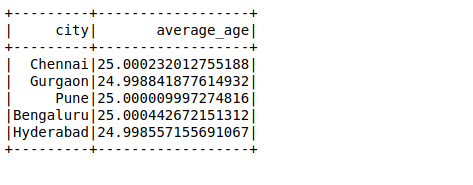
Apache Spark-Anwendungsfall in großem Maßstab
Wir wissen, dass Facebook mehr hat als 2000 Millionen monatlich aktive Nutzer und mit mehr Daten, vor ebenso komplexen Herausforderungen stehen. Für eine einzelne Abfrage, müssen Dutzende Terabyte an Daten in einer einzigen Abfrage analysieren. Facebook glaubt, dass Spark so weit ausgereift ist, dass wir es für eine Reihe von Anwendungsfällen zur Stapelverarbeitung mit Hive vergleichen können..
Lassen Sie mich dies anhand einer Fallstudie von Facebook selbst illustrieren.. Eine seiner Aufgaben war es, die Merkmale für das Ranking der Entitäten vorzubereiten, die Facebook in seinen verschiedenen Online-Diensten verwendet. Vorher, nutzte die Hive-basierte Infrastruktur, das erforderte viele Ressourcen und war schwer zu warten, da die Pipeline in Hunderte von Hive-Jobs aufgeteilt wurde. Dann haben sie mit Spark eine schnellere und besser zu handhabende Pipeline aufgebaut. Sie können seine vollständige Tour lesen hier.
Sie haben die Ergebnisse von Spark vs Hive verglichen RohrleitungPipeline ist ein Begriff, der in einer Vielzahl von Zusammenhängen verwendet wird, hauptsächlich im Technologie- und Projektmanagement. Es bezieht sich auf eine Reihe von Prozessen oder Phasen, die den kontinuierlichen Arbeitsfluss von der Konzeption einer Idee bis zu ihrer endgültigen Umsetzung ermöglichen. Im Bereich der Softwareentwicklung, zum Beispiel, Eine Pipeline kann die Planung umfassen, Testen und Bereitstellen, Dies garantiert mehr Effizienz und Qualität in der.... Hier ist eine Vergleichstabelle in Bezug auf die Latenz (verstrichene Zeit von einem Ende des Jobs zum anderen) was deutlich zeigt, dass Spark viel schneller ist als Hive.

Abschließende Anmerkungen
Wir haben in diesem Artikel die Kernidee von Spark SQL behandelt und auch gelernt, wie wir sie zu unserem Vorteil nutzen können.. Wir haben auch einen großen Datensatz genommen und unser Lernen in Python angewendet.
Spark SQL ist vielen aufstrebenden Data Sciences relativ unbekannt, aber es wird in Ihrer Rolle in der Branche oder sogar in Vorstellungsgesprächen nützlich sein. Dies ist in den Augen des Einstellungsleiters eine ziemlich wichtige Ergänzung..
Teilen Sie Ihre Gedanken und Vorschläge im Kommentarbereich unten mit..





