
Einführung
In diesem Artikel, Wir werden den beliebten Titanic-Datensatz durchgehen und versuchen vorherzusagen, ob eine Person das Wrack überlebt hat. Sie erhalten diesen Datensatz von Kaggle, verlinkt hier. Dieser Artikel wird sich darauf konzentrieren, wie man über diese Projekte nachdenkt, mehr als in der Umsetzung. Viele Anfänger sind verwirrt, wie sie anfangen sollen, wann fertig und alles andere, Ich hoffe, dieser Artikel dient Ihnen als Einsteigerhandbuch.. Ich schlage vor, Sie üben das Projekt in Kaggle.
Das Ziel: vorhersagen, ob ein Passagier überlebt hat oder nicht. 0 um nicht zu überleben, 1 Zum Überleben.
Beschreibung der Daten
In diesem Artikel, Wir werden eine grundlegende Datenanalyse durchführen, dann ein wenig Feature Engineering und, schließlich, Wir werden einige der beliebtesten Modelle für die Vorhersage verwenden. Lasst uns beginnen.
Datenanalyse
Paso 1: Importieren von Basisbibliotheken
numpy als np importieren
Pandas als pd importieren
import seaborn als sns
import matplotlib.pyplot als plt
%matplotlib inline
Paso 2: Daten lesen
training = pd.read_csv('/kaggle/input/titanic/train.csv')
test = pd.read_csv('/kaggle/input/titanic/test.csv')
Ausbildung['train_test'] = 1
Prüfung['train_test'] = 0
Prüfung['Survived'] = np.NaN
all_data = pd.concat([Ausbildung,Prüfung])
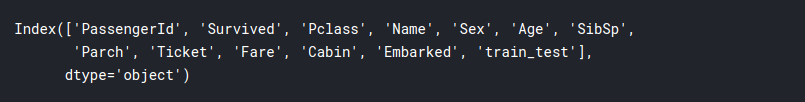
all_data.columns
Paso 3: Datenexploration
In diesem Abschnitt, Wir werden versuchen, Wissen aus den Daten zu extrahieren und uns damit vertraut zu machen, um effizientere Modelle zu erstellen.
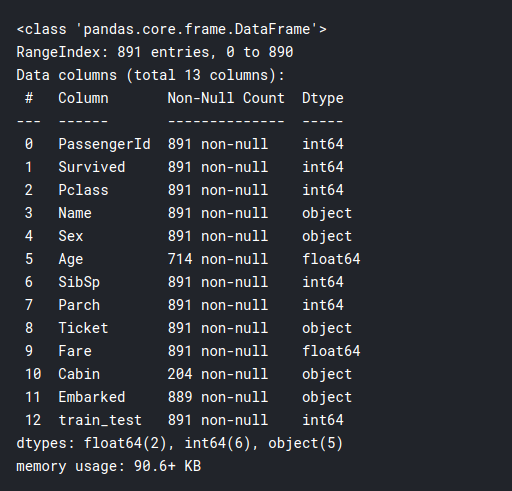
training.info()
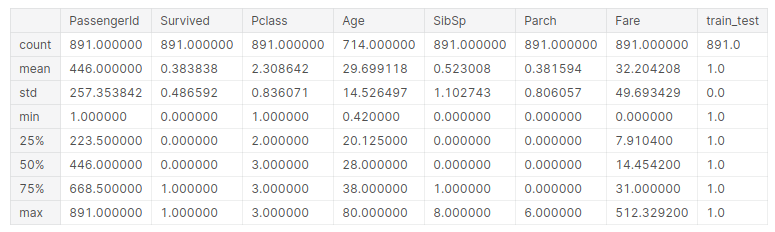
Ausbildung.beschreiben()
# Trennen Sie die Daten in numerische und kategoriale
df_num = Ausbildung[['Alter','SibSp','Parch','Fare']]
df_cat = Ausbildung[['Survived','Pclass','Sex','Ticket','Cabin','Embarked']]
Lassen Sie uns nun die numerischen Daten grafisch darstellen:
für i in df_num.columns:
    plt.hist(df_num[ich])
    plt.titel(ich)
    plt.zeigen()
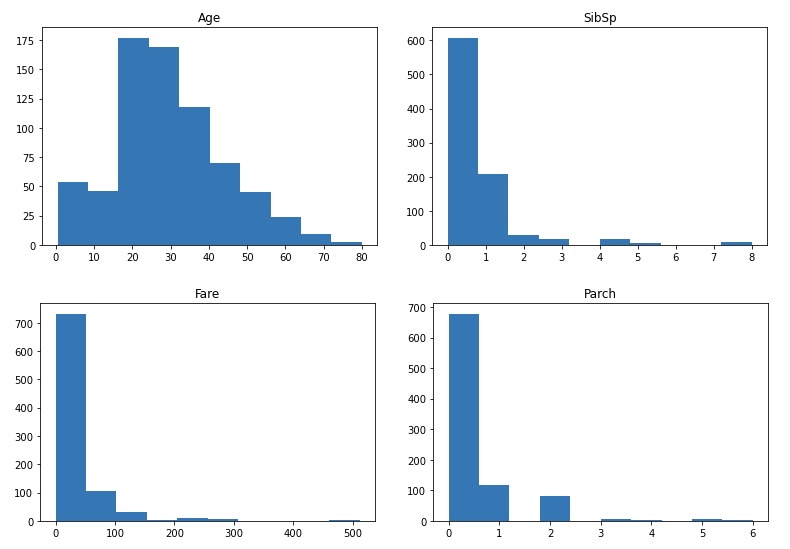
Dann, Wie du siehst, die meisten Verteilungen sind verstreut, außer Alter, ist ziemlich normal. Wir könnten später in Erwägung ziehen, sie zu normalisieren. Dann, Wir zeichnen eine Heatmapein "Heatmap" ist eine grafische Darstellung, die Farben verwendet, um die Dichte von Daten in einem bestimmten Bereich anzuzeigen. Häufig in der Datenanalyse verwendet, Marketing und Verhaltensstudien, Diese Art der Visualisierung ermöglicht es Ihnen, Muster und Trends schnell zu erkennen. Durch chromatische Variationen, Heatmaps erleichtern die Interpretation großer Informationsmengen, dabei helfen, fundierte Entscheidungen zu treffen.... Korrelation zwischen numerischen Spalten:
sns.heatmap(df_num.corr())
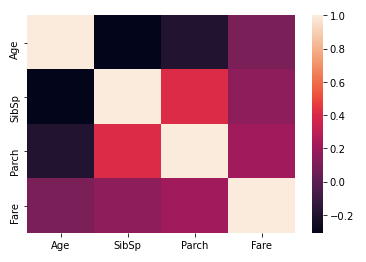
Hier sehen wir, dass Parch und SibSp eine höhere Korrelation aufweisen, was im Allgemeinen sinnvoll ist, da Eltern eher mit ihren mehreren Kindern reisen und Ehepartner dazu neigen, zusammen zu reisen. Dann, Vergleichen wir die Überlebensraten zwischen numerischen Variablen. Dies könnte einige interessante Ideen enthüllen:
pd.pivot_table(Ausbildung, index = 'Survived', Werte = ['Alter','SibSp','Parch','Fare'])
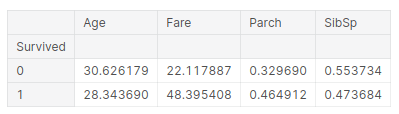
Die Schlussfolgerung, die wir aus dieser Tabelle ziehen können, ist:
- Das Durchschnittsalter der Überlebenden beträgt 28 Jahre, junge Leute überleben also länger.
- Menschen, die höhere Raten zahlten, überlebten eher, mehr als doppelt. Das könnten die Leute sein, die First Class reisen. So haben die Reichen überlebt, das ist eine traurige geschichte auf dieser bühne.
- In der dritten Spalte, wenn du eltern hast, hat eine höhere Überlebenschance. Dann, Eltern hätten die Kinder vor sich selbst retten können, so erklären die preise
- Und wenn du ein Kind bist und Geschwister hast, du hast weniger Chancen zu überleben.
Jetzt machen wir etwas Ähnliches mit unseren kategorialen Variablen:
für i in df_cat.columns:
    sns.barplot(df_cat[ich].value_counts().Index,df_cat[ich].value_counts()).set_title(ich)
    plt.zeigen()
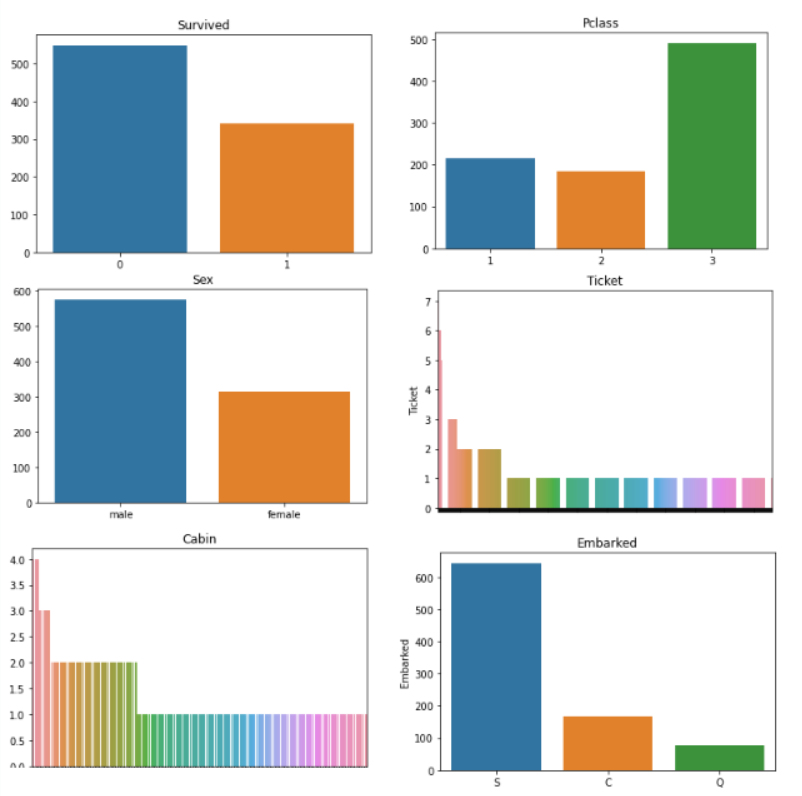
Ticket- und Kabinengrafiken sehen sehr unordentlich aus, Wir müssen sie vielleicht entwerfen! Abgesehen davon, der Rest der Grafiken verrät es uns:
- Überlebt: die meisten Menschen starben bei dem Schiffbruch, nur ein paar 300 Menschen haben überlebt.
- PKlasse: Die meisten Reisenden hatten Fahrkarten für die 3. Klasse.
- Sex: es waren mehr Männer als Frauen an Bord des Schiffes, etwa die doppelte Menge.
- Eingeschifft: Die meisten Passagiere bestiegen das Schiff aus Southampton.
Jetzt machen wir etwas Ähnliches wie das dynamische TabellePivotTable ist ein leistungsstarkes Tool in Tabellenkalkulationsprogrammen, wie Microsoft Excel und Google Sheets. Ermöglicht es Ihnen, zusammenzufassen, Große Datenmengen effizient analysieren und visualisieren. Durch seine intuitive Benutzeroberfläche, Benutzer können Informationen neu anordnen, Anwenden von Filtern und Erstellen von benutzerdefinierten Berichten, Erleichterung einer fundierten Entscheidungsfindung in verschiedenen Kontexten, Von der Wirtschaft bis zur akademischen Forschung.... anterior, aber mit unseren kategorialen Variablen, und vergleichen Sie diese mit unseren VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... abhängig, Was wäre, wenn die Leute überlebten?:
drucken(pd.pivot_table(Ausbildung, index = 'Survived', Spalten="PKlasse",
                     Werte="Fahrkarte" ,aggfunc="zählen"))
drucken()
drucken(pd.pivot_table(Ausbildung, index = 'Survived', Spalten="Sex",
                     Werte="Fahrkarte" ,aggfunc="zählen"))
drucken()
drucken(pd.pivot_table(Ausbildung, index = 'Survived', Spalten="Eingeschifft",
                     Werte="Fahrkarte" ,aggfunc="zählen"))
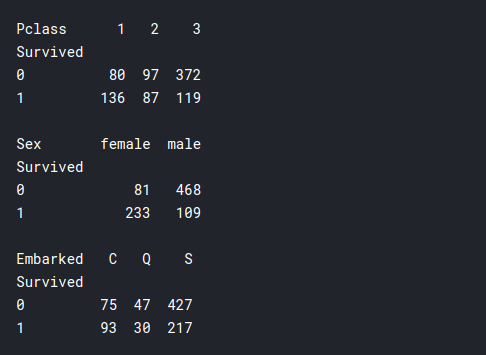
- PKlasse: Hier sehen wir, dass viel mehr Menschen aus der ersten Klasse überlebten als aus der zweiten oder dritten Klasse., obwohl die Gesamtzahl der Passagiere in der ersten Klasse viel niedriger war als in der dritten Klasse. Deswegen, hier bestätigt sich unsere frühere Annahme, dass die Reichen überlebt haben, was für den Modellbau relevant sein könnte.
- Sex: die meisten Frauen überlebten und die meisten Männer starben bei dem Schiffbruch. Deswegen, es scheint, dass das Sprichwort „Frau und Kinder zuerst“ trifft in diesem Szenario tatsächlich zu.
- Eingeschifft: Dies scheint nicht sehr relevant zu sein., vielleicht wäre jemand von „Cherburgo"Ich hatte eine größere Chance zu überleben.
Paso 4: Funktionsengineering
Wir haben gesehen, dass unser Fahrkarte Ja Kabine die daten machen für uns nicht wirklich sinn, und dies könnte die Leistung unseres Modells beeinträchtigen, Daher müssen wir einige dieser Daten mit Function Engineering vereinfachen.
Wenn wir uns die echten Daten der Kabine ansehen, Wir sehen, dass es im Grunde einen Buchstaben und dann eine Zahl gibt. Buchstaben können bedeuten, um was für eine Kabine es sich handelt, wo du auf dem schiff bist, auf welcher Etage, für welche klasse ist es, etc. Und die Zahlen können die Kabinennummer bedeuten. Teilen wir sie zuerst in einzelne Kabinen auf und sehen, ob jemand mehr als eine Kabine hatte.
df_cat.Kabine
Ausbildung['cabin_multiple'] = training.Kabine.apply(Lambda x: 0 wenn pd.isna(x)
                                                    sonst len(x.split('Review')))
Ausbildung['cabin_multiple'].value_counts()
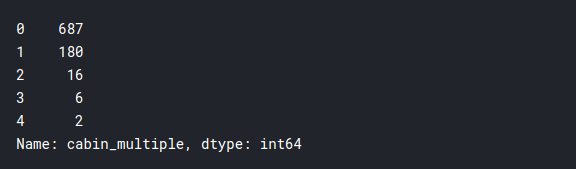
Es scheint, dass die überwiegende Mehrheit keine individuellen Kabinen hatte, und nur wenige Leute hatten mehr als eine Kabine. Mal sehen, ob die Überlebensraten davon abhängen:
pd.pivot_table(Ausbildung, index = 'Survived', Spalten="kabine_multiple",
               Werte="Fahrkarte" ,aggfunc="zählen")
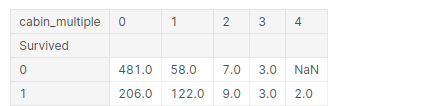
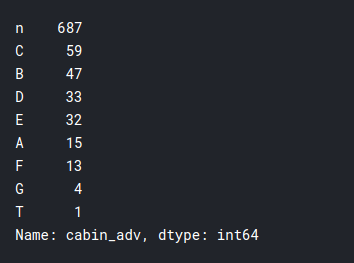
Dann, Sehen wir uns den tatsächlichen Brief der Kabine an, in der sie sich befanden. Deswegen, Sie könnten erwarten, dass sich Kabinen mit demselben Buchstaben an ungefähr denselben Standorten oder auf denselben Etagen befinden und, logisch, wenn eine Kabine in der Nähe der Rettungsboote wäre, sie hatten eine bessere Chance zu überleben. Schauen wir uns das an:
# n steht für null
# in this case we will treat null values like it's own category
training['cabin_adv'] = training.Kabine.apply(Lambda x: str(x)[0])
#Vergleich der Überlebensraten nach Kabine
drucken(training.cabin_adv.value_counts())
pd.pivot_table(Ausbildung,index='Survived',Spalten="kabine_adv",
                        Werte="Name", aggfunc="zählen")
Ich habe etwas Zukunftstechnik in der Fahrkarte Kolumne und brachte nicht viele wichtige Erkenntnisse, das wissen wir noch nicht, Also überspringe ich diesen Teil, um den Artikel prägnant zu halten. Wir werden die Tickets einfach in numerische und nicht-numerische unterteilen, um eine effiziente Verwendung zu gewährleisten:
Ausbildung['numeric_ticket'] = training.Ticket.beantragen(Lambda x: 1 wenn x.isnumeric() anders 0)
Ausbildung['ticket_letters'] = training.Ticket.beantragen(Lambda x: ''.join(x.split('Review')[:-1])
                                            .ersetzen('.','').ersetzen('/','')
                                            .untere() wenn len(x.split('Review')[:-1]) >0 anders 0)
Eine weitere interessante Sache, die wir beobachten können, sind die Titel der einzelnen Passagiere. Und wenn er eine Rolle gespielt hat, um ihnen einen Platz in den Rettungsbooten zu verschaffen?.
Ausbildung.Name.Kopf(50)
Ausbildung['name_title'] = training.Name.apply(Lambda x: x.split(',')[1]
                                                        .Teilt('.')[0].Streifen())
Ausbildung['name_title'].value_counts()
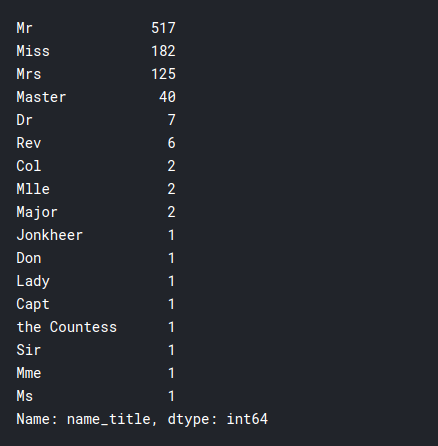
Wie du siehst, das Schiff wurde von Menschen vieler verschiedener Klassen bestiegen, Das könnte in unserem Modell nützlich sein.
Paso 5: Datenvorverarbeitung für das Modell
In diesem Segment, wir bereiten unsere Daten für Modelle auf. Die Ziele, die wir erreichen müssen, sind unten aufgeführt:
- Entfernen Sie die Nullwerte aus der Spalte Versand
- Nur relevante Daten einbeziehen
- Alle Daten kategorisch transformieren, mit einem sogenannten Transformator.
- Imputation von Daten mit zentralen Trends nach Alter und Rate.
- Normalisieren Sie die Bewertung Spalte, um eine normalere Verteilung zu haben.
- unter Verwendung von Standardskaladaten 0-1
Paso 6: Modellimplementierung
Hier werden wir die verschiedenen Modelle einfach mit ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Standardeinstellungen und sehen Sie, welche das beste Ergebnis liefert. Modelle können für eine bessere Leistung weiter angepasst werden, aber sie sind nicht Gegenstand dieses Artikels. Die Modelle, die wir betreiben werden, sind:
- Logistische Regression
- K Nächster Nachbar
- Unterstützungsvektorklassifikator
Zuerst, wir importieren die benötigten Modelle
aus sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
von sklearn.neighbors importieren KNeighborsClassifier
aus sklearn.svm SVC importieren
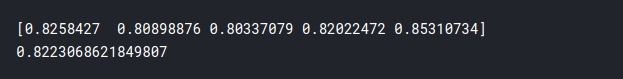
1) Logistische Regression
lr = LogistikRegression(max_iter = 2000)
cv = cross_val_score(lr,X_train_scaled,y_train,cv=5)
drucken(Lebenslauf)
drucken(cv.mean())
2) K Nächster Nachbar
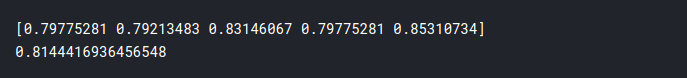
knn = KNeighborsClassifier()
cv = cross_val_score(knn,X_train_scaled,y_train,cv=5)
drucken(Lebenslauf)
drucken(cv.mean())
3) Unterstützungsvektorklassifikator
svc = SVC(Wahrscheinlichkeit = Wahr)
cv = cross_val_score(svc,X_train_scaled,y_train,cv=5)
drucken(Lebenslauf)
drucken(cv.mean())
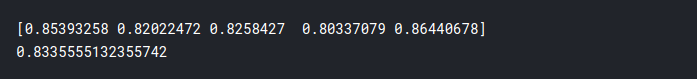
Deswegen, die Genauigkeit der Modelle ist:
- Logistische Regression: 82,2%
- K Nächster Nachbar: 81,4%
- SVC: 83,3%
Wie du siehst, Wir erreichen eine anständige Genauigkeit mit allen unseren Modellen, aber das beste ist SVC. Und fertig, So haben Sie Ihr erstes Data Science Projekt abgeschlossen! Obwohl viel mehr getan werden kann, um bessere Ergebnisse zu erzielen, Dies ist mehr als genug, um Ihnen den Einstieg zu erleichtern und zu sehen, wie Sie wie ein Datenwissenschaftler denken. Ich hoffe dieses Tutorial hat dir geholfen, Ich hatte eine tolle Zeit das Projekt selbst zu machen und ich hoffe es gefällt euch auch. Gesundheit!!





