
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Clustering ist eine unbeaufsichtigte maschinelle Lerntechnik. Es ist der Prozess der Aufteilung des Datensatzes in Gruppen, in denen Mitglieder derselben Gruppe ähnliche Merkmale aufweisen. Die am häufigsten verwendeten Clustering-Algorithmen sind K-Means-Clustering, hierarchische Gruppierung, dichtebasierte Gruppierung, modellbasierte Gruppierung, etc. In diesem Artikel, vamos a discutir el GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. de K-Means en detalle.
Gruppierung von K-Strümpfen
Es el algoritmo de Unüberwachtes LernenUnüberwachtes Lernen ist eine Technik des maschinellen Lernens, die es Modellen ermöglicht, Muster und Strukturen in Daten ohne vordefinierte Beschriftungen zu identifizieren. Durch Algorithmen wie k-means und Hauptkomponentenanalyse, Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, wie z. B. Kundensegmentierung, Anomalieerkennung und Datenkomprimierung. Seine Fähigkeit, verborgene Informationen preiszugeben, macht es zu einem wertvollen Werkzeug in der... de tipo iterativo más simple y de uso común. In diesem, wir initialisieren zufällig die K Anzahl der Schwerpunkte in den Daten (die Zahl von k wird mit der gefunden Ellbogen Methode, die später in diesem Artikel besprochen wird) und iteriere diese Schwerpunkte, bis sich die Position des Schwerpunkts nicht ändert. Lassen Sie uns die Schritte durchgehen, die in K bedeutet, gruppieren für ein besseres Verständnis.
1) Wählen Sie die Anzahl der Cluster für den Datensatz aus (K)
2) Wählen Sie die K-Anzahl des Schwerpunkts
3) Bei der Berechnung der euklidischen Distanz oder Manhattan-Distanz, Punkte zuweisen nächster Schwerpunkt, wodurch K-Gruppen erstellt werden
4) Finden Sie nun den ursprünglichen Schwerpunkt in jeder Gruppe
5) Weisen Sie den gesamten Datenpunkt basierend auf diesem neuen Schwerpunkt neu zu, dann wiederhole den schritt 4 bis sich die Schwerpunktlage nicht ändert.
Das Finden der optimalen Anzahl von Clustern ist ein wichtiger Teil dieses Algorithmus. Eine häufig verwendete Methode, um den optimalen Wert von K zu finden, ist Ellbogenmethode.
Ellbogenmethode
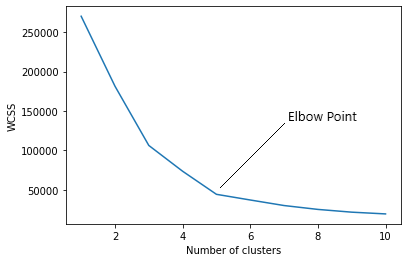
Bei der Ellenbogenmethode, wir variieren tatsächlich die Anzahl der Cluster (K) von 1 ein 10. Für jeden Wert von K, wir berechnen WCSS (Summe der Quadrate innerhalb des Clusters). WCSS ist die Summe des quadrierten Abstands zwischen jedem Punkt und dem Schwerpunkt in einer Gruppe. Wenn wir das WCSS mit dem K-Wert grafisch darstellen, die Grafik sieht aus wie eine Elle. Wenn die Anzahl der Cluster zunimmt, der WCSS-Wert beginnt zu sinken. Der WCSS-Wert ist größer, wenn K = 1. Wenn wir den Graphen analysieren, Wir können sehen, dass sich der Graph an einem Punkt schnell ändert und, Daher, erzeugt eine Ellbogenform. Von diesem Punkt, der Graph beginnt sich fast parallel zur X-Achse zu bewegen. Der diesem Punkt entsprechende K-Wert ist der optimale K-Wert oder eine optimale Anzahl von Clustern.
Lassen Sie uns nun K-Means-Clustering mit Python implementieren.
Implementierung
Zuerst, wir müssen wichtige Bibliotheken importieren.
numpy als np importieren
import matplotlib.pyplot als plt
Pandas als pd importieren
sklearn importieren
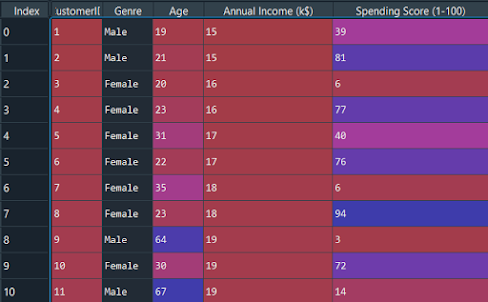
Jetzt importieren wir den Datensatz und trennen die wichtigen Funktionen.
Datensatz = pd.read_csv('Mall_Customers.csv')
X = dataset.iloc[:, [3, 4]].Werte
Wir müssen den optimalen Wert von K finden, um die Daten zu gruppieren. Jetzt verwenden wir die Ellbogenmethode, um den optimalen Wert von K . zu finden.
aus sklearn.cluster importieren KMeans
wcss = [] für mich in Reichweite(1, 11):
    kmeans = KMeans(n_cluster = i, init="k-bedeutet++", random_state = 42)
    kmeans.fit(x)
    wcss.append(kmeans.inertia_)
Das Argument „drin“ ist die Methode zum Initialisieren des Schwerpunkts. Wir berechnen den WCSS-Wert für jeden K-Wert. Jetzt müssen wir das WCSS mit dem Wert K . zeichnen
plt.plot(Bereich(1, 11), WC)
plt.xlabel('Anzahl der Cluster')
plt.ylabel('WCSS')
plt.zeigen(
Die Grafik wird-
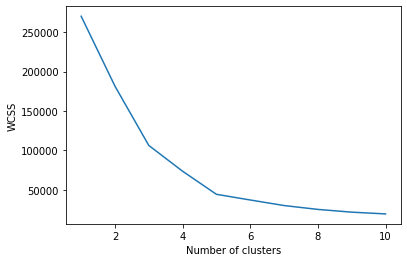
Der Punkt, an dem die Ellbogenform erstellt wird, ist 5, nämlich, unser K-Wert oder eine optimale Clusteranzahl ist 5. Nun trainieren wir das Modell auf dem Datensatz mit einer Reihe von Clustern 5.
kmeans = KMeans(n_cluster = 5, init = "k-bedeutet++", random_state = 42)
y_kmeans = kmeans.fit_predict(x)
y_kmeans wird sein:
Array([3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0,
       3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 0, 3, 1,
       3, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
       1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
       1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1,
       1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 4, 2, 1, 2, 4, 2, 4, 2,
       1, 2, 4, 2, 4, 2, 4, 2, 4, 2, 1, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2,
       4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2,
       4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2, 4, 2,
       4, 2])
plt.streuung(x[y_kmeans == 0, 0], x[y_kmeans == 0, 1], s = 60, c="rot", Etikett="Cluster1")
plt.streuung(x[y_kmeans == 1, 0], x[y_kmeans == 1, 1], s = 60, c="Blau", Etikett="Cluster2")
plt.streuung(x[y_kmeans == 2, 0], x[y_kmeans == 2, 1], s = 60, c="Grün", Etikett="Cluster3)
plt.streuung(x[y_kmeans == 3, 0], x[y_kmeans == 3, 1], s = 60, c = "violet', Etikett="Cluster4")
plt.streuung(x[y_kmeans == 4, 0], x[y_kmeans == 4, 1], s = 60, c="Gelb", Etikett="Cluster5")
plt.streuung(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:, 1], s = 100, c="Schwarz", Etikett="Schwerpunkte")
plt.xlabel('Jahreseinkommen (k$)') plt.ylabel('Ausgabenpunkt (1-100)') plt.legende()

plt.zeigen()
Grafik:
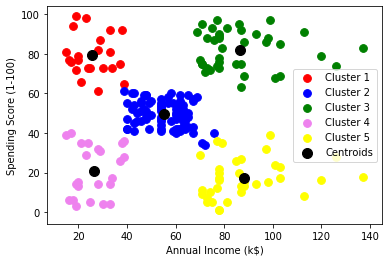
Wie man dort sieht 5 Gruppen insgesamt, die in verschiedenen Farben dargestellt werden und der Schwerpunkt jeder Gruppe wird schwarz dargestellt.
Vollständiger Code
# Importieren der Bibliotheken
numpy als np importieren
import matplotlib.pyplot als plt
Pandas als pd importieren # Importieren des Datensatzes

X = dataset.iloc[:, [3, 4]].Werte
Datensatz = pd.read_csv('Mall_Customers.csv')

aus sklearn.cluster importieren KMeans

# Verwenden der Ellbogen-Methode, um die optimale Anzahl von Clustern zu finden wcss = [] für mich in Reichweite(1, 11):
 wcss.append(kmeans.inertia_)
 kmeans = KMeans(n_cluster = i, init="k-bedeutet++", random_state = 42) kmeans.fit(x) plt.plot(Bereich(1, 11), WC) plt.xlabel('Anzahl der Cluster')

y_kmeans = kmeans.fit_predict(x)

plt.ylabel('WCSS') plt.zeigen() # Training des K-Means-Modells auf dem Datensatz kmeans = KMeans(n_cluster = 5, init="k-bedeutet++", random_state = 42) y_kmeans = kmeans.fit_predict(x)

# Visualisierung der Cluster
plt.streuung( x[y_kmeans == 1, 0], x[y_kmeans == 1, 1], s = 60, c="Blau", Etikett="Cluster2")
plt.streuung( x[y_kmeans == 0, 0], x[y_kmeans == 0, 1], s = 60, c="rot", Etikett="Cluster1") plt.streuung( x[y_kmeans == 2, 0], x[y_kmeans == 2, 1], s = 60, c="Grün", Etikett="Cluster3")
plt.streuung( kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:, 1], s = 100, c="Schwarz", Etikett="Schwerpunkte")
plt.streuung( x[y_kmeans == 3, 0], x[y_kmeans == 3, 1], s = 60, c="violett", Etikett="Cluster4") plt.streuung( x[y_kmeans == 4, 0], x[y_kmeans == 4, 1], s = 60, c="Gelb", Etikett="Cluster5") plt.xlabel('Jahreseinkommen (k$)') plt.ylabel('Ausgabenpunkt (1-100)') plt.legende()

plt.zeigen()
Fazit
Dies ist das Grundkonzept des K-Means-Clustering-Algorithmus im maschinellen Lernen. In den nächsten Artikeln, wir können weitere Informationen über verschiedene Algorithmen für maschinelles Lernen erhalten.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





