
Dieser Beitrag wurde im Rahmen der . veröffentlicht Data Science Blogathon
Einführung
Bayessche Entscheidungstheorie bezieht sich auf den statistischen Ansatz, der auf der Quantifizierung von Trade-offs zwischen verschiedenen Klassifizierungsentscheidungen basierend auf dem Wahrscheinlichkeitskonzept basiert (Teorema de Bayes) und die mit der Entscheidung verbundenen Kosten.
Es ist einfach eine Klassifikationstechnik, die den Satz von Bayes beinhaltet, der verwendet wird, um die bedingten Wahrscheinlichkeiten zu finden.
In Akkreditierung statistischer Muster, Wir werden uns auf die statistischen Eigenschaften der Muster konzentrieren, die im Allgemeinen in Wahrscheinlichkeitsdichten ausgedrückt werden (pdf und pmf), und dies wird in diesem Beitrag die meiste Aufmerksamkeit auf sich ziehen und versuchen, die Argumente der Bayesschen Entscheidungstheorie zu entwickeln.
Voraussetzungen
VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... zufällig
Eine Zufallsvariable ist eine Funktion, die einigen Werten eine zulässige Menge von Ergebnissen zuweist, wie eine Münze zu werfen und die H-Seite zu bekommen wie 1 und der T-Schwanz wie 0, wo 0 Ja 1 es sind Zufallsvariablen.
Teorema de Bayes
Die bedingte Wahrscheinlichkeit von A gegeben B, vertreten durch P (EIN | B) ist die Wahrscheinlichkeit, dass A auftritt, wenn B eingetreten ist.
P (EIN | B) = P (EIN, B) / P (B) Ö
Bei Verwendung der Kettenregel, das kann man auch schreiben als:
P (EIN, B) = P (EIN | B) P (B) = P (B | EIN) P (EIN)
P (EIN | B) = P (B | EIN) P (EIN) / P (B) ——- (1)
Woher, P (B) = P (B, EIN) + P (B, EIN ‚) = P (B | EIN) P (EIN) + P (B | EIN‘) P (EIN ‚)
Hier, Die gleichung (1) ist bekannt als Bayes Wahrscheinlichkeitssatz
Unser Ziel ist es, jede der in diesem Theorem enthaltenen Komponenten zu untersuchen. Lassen Sie uns Schritt für Schritt erkunden:
(ein) Zurück oder Zustand der Natur:
- Die A-priori-Wahrscheinlichkeiten stellen die Wahrscheinlichkeit des Auftretens jeder Klasse dar.
- Das oben Genannte ist vor dem Training bekannt.
- Der Naturzustand ist eine Zufallsvariable P (wich).
- Wenn es nur zwei Klassen gibt, dann ist die Summe der obigen P (w1) + P (w2) = 1, wenn der Unterricht erschöpfend ist.
(B) Klassenbedingte Wahrscheinlichkeiten:
- Stellt die Wahrscheinlichkeit dar, dass ein Merkmal x auftritt, wenn es zu der bestimmten Klasse gehört. Es wird bezeichnet mit, P (x | EIN) wobei x eine besondere Eigenschaft ist
- Es ist die Wahrscheinlichkeit, mit der das Merkmal x auftritt, vorausgesetzt, es gehört zur Klasse wich.
- Manchmal, es ist auch bekannt als Wahrscheinlichkeit.
- Es ist die Menge, die wir beim Trainieren der Daten untersuchen müssen. Im Verlauf des Verfahrens AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen...., wir haben den eingang (Merkmale) X wird der entsprechenden Klasse w zugeordnet und wir berechnen die Wahrscheinlichkeit des Auftretens dieser Menge von Merkmalen mit der Bezeichnung der Klasse.
(C) Beweis:
- Es ist die Wahrscheinlichkeit, dass ein bestimmtes Merkmal auftritt, Mit anderen Worten P (x).
- Es kann mit der Kettenregel wie berechnet werden, P (x) =In P (x | wich) P (wich)
- Wie brauchen wir die klassenbedingte Wahrscheinlichkeitswahrscheinlichkeit, zusätzlich werden die Evidenzwerte während des gesamten Trainings berechnet.
(D) Posterior-Wahrscheinlichkeiten:
- Es ist die Wahrscheinlichkeit, dass Klasse A auftritt, wenn bestimmte Merkmale auftreten.
- Es ist das, was wir in der Testphase berechnen wollen, in der wir Testeingaben oder -merkmale haben (die gegebene Entität) und wir müssen herausfinden, wie wahrscheinlich es ist, dass das trainierte Modell Merkmale vorhersagen kann, die zu der bestimmten Klasse w . gehörenich.
Zum besseren Verständnis der obigen Theorie, wir betrachten ein beispiel
Beschreibung des Problems
Angenommen, wir haben eine Aussage über ein Klassifikationshindernis, bei dem wir kategorisieren müssen zwischen dem Objekt 1 und das Objekt 2 mit den gegebenen Merkmalen. X = [x1, x2, …, xn]T.
Ziel
Das Hauptziel beim Entwerfen eines solchen Klassifikators besteht darin, Aktionen vorzuschlagen, wenn er mit unsichtbaren Merkmalen präsentiert wird., Mit anderen Worten, ein noch nicht gesehenes Objekt, Mit anderen Worten, nicht in Trainingsdaten.
In diesem Beispiel, w bezeichnet den Naturzustand mit w = w1 für Objekt-1 Ja w = w2 für Objekt-2. Hier, das müssen wir eigentlich wissen, der Naturzustand ist so unvorhersehbar, dass wir im Allgemeinen davon ausgehen, dass der beschriebene wahrscheinlich variabel war.
Vorrang
- Allgemein, wir nehmen an, dass es einen vorherigen Wert P . gibt (w1) dass das nächste Objekt Objekt-1 ist und P (w2) dass das nächste Objekt Objekt-2 ist. Wenn wir kein anderes Objekt wie in diesem Problem haben, dann ist die Summe seiner vorherigen 1, Mit anderen Worten, die oben genannten sind erschöpfend.
- Die A-priori-Wahrscheinlichkeiten spiegeln das Vorwissen der Wahrscheinlichkeit wider, dass wir das Objekt erhalten 1 und das Objekt 2. Es kommt auf die Domäne an, da sich der vorherige je nach Jahreszeit ändern kann, in der er erkannt wird.
Klingt etwas seltsam und bei der Beurteilung mehrerer Objekte (wie in einem realistischeren Szenario) macht diese Entscheidungsregel dumm, da wir immer dieselbe Entscheidung auf der Grundlage des vorherigen Majors treffen, obwohl wir wissen, dass jede andere Art von Ziel auch von den Exzess-A-priori-Wahrscheinlichkeiten bestimmt werden könnte (da das oben Genannte erschöpfend ist).
Betrachten Sie die folgenden verschiedenen Szenarien:
- Und P (ω1) >>> P (ω2), unsere Entscheidung für ω1 wird die meiste Zeit richtig sein, die wir vorhersagen.
- Aber ja P (ω1) = P (ω2), wahrscheinliche Mittel dafür, dass unsere Vorhersage richtig ist. Allgemein, die Fehlerwahrscheinlichkeit ist das Minimum von P (ω1) y P (ω2), und später in diesem Beitrag, Wir werden sehen, dass unter diesen Bedingungen keine andere Entscheidungsregel eine größere Wahrscheinlichkeit für die Richtigkeit erzeugen kann.
Verfahren zur Merkmalsextraktion (Funktion aus Bildern extrahieren)
Eine Reihe von empfohlenen Funktionen Lang, Breite, Alternativen für ein Objektetc.
In unserem Beispiel, wir nehmen das Breite x, Was ist mehr diskriminierend um die Entscheidungsregel unseres Klassifikators zu steuern. Die verschiedenen Objekte werden unterschiedliche Werte mit variabler Breite erzeugen und im Allgemeinen sehen wir diese Variabilität in Wahrscheinlichkeitsbegriffen und wir betrachten auch, dass x eine kontinuierliche Zufallsvariable ist, deren Verteilung von der Art des Objekts abhängt wJ, und wird ausgedrückt als p (x | ωJ) (Wahrscheinlichkeitsverteilungsfunktion pdf als stetige Variable) und bekannt als klassenbedingte Wahrscheinlichkeitsdichtefunktion. Deswegen,
Das pdf p (x | ω1) ist die Wahrscheinlichkeitsdichtefunktion für das Merkmal x, wenn der Naturzustand ω . ist1 und die gleiche Interpretation für p (x | w2).
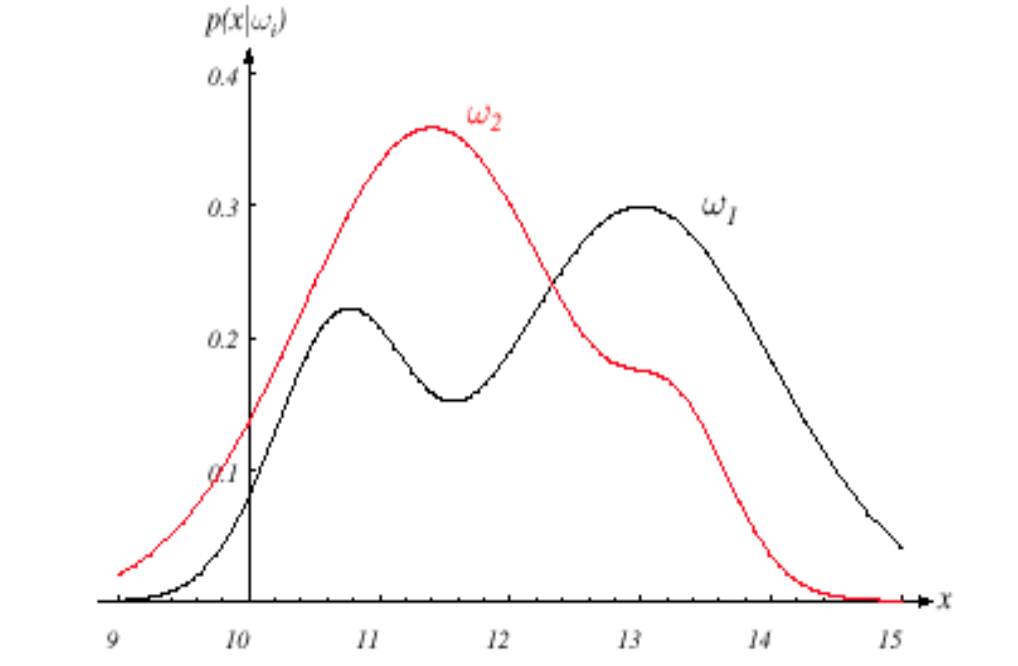
Feige. Bild zeigt pdf für beide Klassen
Bildquelle: Google Bilder
Angenommen, wir kennen die A-priori-Wahrscheinlichkeiten P (ωJ) und die bedingten Dichten p (x | ωJ). Jetzt, können wir mit der Bayes-Formel die Posterior-Wahrscheinlichkeiten ermitteln:
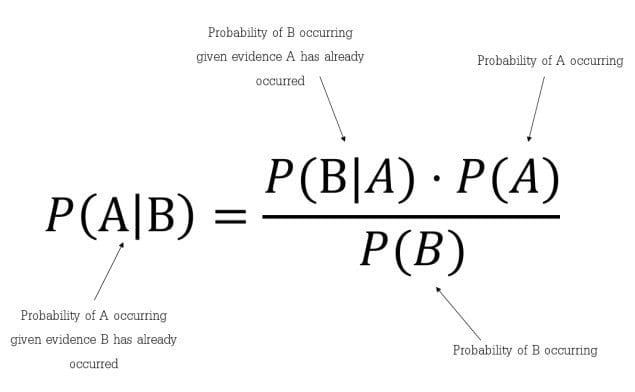
Feige. Bayes-Theorem-Formel
Bildquelle: Google Bilder
Die Formel von Bayes gibt uns die Intuition, dass wir durch die Beobachtung des Maßes von x das P (ωJ) zu später, bezeichnet mit P (ωJ| x) was ist die Wahrscheinlichkeit von ωJ da der Kennwert x gemessen wurde.
P (x | ωJ) ist bekannt als die Wahrscheinlichkeit von ωJ in Bezug auf ax.
Der Beweisfaktor, P (x), funktioniert einfach als Skalierungsfaktor, der sicherstellt, dass die Posterior-Wahrscheinlichkeiten für alle Klassen eins ergeben.
Bayes Entscheidungsregel
Die Entscheidungsregel bei gegebenen Posterior-Wahrscheinlichkeiten ist die nächste
Und P (w1| x)> P (w2| x) wir würden entscheiden, dass das Objekt zur Klasse w . gehört1, oder sonst Klasse w2.
Fehlerwahrscheinlichkeit
Um unsere Entscheidung zu begründen, Wir betrachten die Fehlerwahrscheinlichkeit, solange wir x . beobachten, haben,
P (Error | x) = P (w1| x) wenn wir uns entscheiden w2, Ja P (w2| x) wenn wir uns entscheiden w1
Wie erschöpfend sind und ob wir die richtige Natur eines Objekts nach Wahrscheinlichkeit P . wählen, dann die verbleibende Wahrscheinlichkeit (1-P) wird zeigen, wie wahrscheinlich die Entscheidung ist, dass es sich nicht um das entschiedene Objekt handelt.
Wir können die Fehlerwahrscheinlichkeit minimieren, indem wir entscheiden, welche einen höheren Posterior und den Rest hat, da die Fehlerwahrscheinlichkeit die minimal mögliche ist. Deshalb bekommen wir zum Abschluss
P (Error | x) = min [P(ω1|x),P(ω2|x)]
Und unsere Bayes-Entscheidungsregel als,
Elegir1 und P (ω1| x)> P (ω2| x); sonst entscheide2
Diese Art von Entscheidungsregel unterstreicht die Rolle der Posterior-Wahrscheinlichkeiten. Mit Hilfe des Satzes von Bayes, wir können die Regel durch a priori und bedingte Wahrscheinlichkeiten ausdrücken.
Die Beweise sind für die Entscheidung irrelevant. Wie wir bereits kommentiert haben, es funktioniert einfach als Skalierungsfaktor, der angibt, wie oft wir das Merkmal mit dem x-Wert messen; versichert P (ω1| x) + P (ω2| x) = 1.
Dann, indem wir den in unserer Entscheidungsregel nicht benötigten Skalierungsfaktor streichen, wir haben die ähnliche Entscheidungsregel des Satzes von Bayes wie,
Elegir1 und P (x | ω1) P (ω1)> p (x | ω2) P (ω2); sonst entscheide2
Jetzt, betrachten wir 2 Fälle:
- Fall 1: Wenn Klassenbedingungen gleich sind, Mit anderen Worten, P (x | ω1) = p (x | ω2), Wir kommen dann zu unserer Regel der vorzeitigen Entscheidung, die nur von a priori geregelt wird.
- Fall 2: Außerdem, wenn die oben gleich sind, Mit anderen Worten, P (ω1) = P (ω2) dann basiert die Entscheidung ausschließlich auf Bedingungen der Klasse p (x | ωJ).
Damit ist unsere Beispielformulierung abgeschlossen!!
Verallgemeinerung der obigen Ideen für mehrere Klassen und Merkmale
Bayes-Klassifizierung: hintere, Wahrhaftigkeit, Vorher und Beweis
P (wich | x) = P (x | wich) P (wich) / P (x)
Posterior = Wahrscheinlichkeit * Vorherige / Beweis
Jetzt diskutieren wir die Fälle, die mehrere Merkmale aufweisen, sowie mehrere Klassen,
Lassen Sie mehrere Funktionen sein x1, x2, … XNorden und mehrere Klassen sind w1, w2,… WNorden, nach:
P (wich | x1,…. xNorden) = P (x1,…. , xNorden| wich) * P (wich) / P (x1,… XNorden)
Woher,
Hintere = P (wich | x1,…. xNorden)
Wahrscheinlichkeit = P (x1,…. , xNorden| wich)
Vorherige = P (wich)
Beweis = P (x1,… ,xNorden)
Bei gleichen eingehenden Mustern, Wir müssen möglicherweise eine drastisch andere Kostenfunktion verwenden, was zu ganz anderen Aktionen führt. Allgemein, unterschiedliche Entscheidungsaufgaben können ganz andere Eigenschaften und Leistungsgrenzen erfordern als die, die für unser ursprüngliches Kategorisierungsproblem nützlich sind.
Dann, in nachfolgenden Beiträgen, wir werden das besprechen Kostenfunktion, Risikoanalyse, Ja entschlossenes Handeln Dies wird helfen, die Bayes-Entscheidungstheorie besser zu verstehen.
Abschließende Anmerkungen
Danke fürs Lesen!
Wenn dir das gefallen hat und du mehr wissen möchtest, Besuchen Sie meine anderen Beiträge zu Data Science und Machine Learning, indem Sie auf das klicken Verknüpfung
Kontaktieren Sie mich gerne unter Linkedin, Email.
Alles was nicht erwähnt wurde oder du deine Gedanken teilen möchtest? Fühlen Sie sich frei, unten einen Kommentar zu hinterlassen und ich melde mich bei Ihnen.
Über den Autor
Chirag Goyal
Heute, Ich studiere meinen Bachelor of Technology (B.Tech) in Informatik und Ingenieurwissenschaften von Indisches Technologieinstitut Jodhpur (IITJ). Ich freue mich sehr über maschinelles Lernen, das tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... und Künstliche Intelligenz.
Die in diesem Beitrag gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





