
Dieser Beitrag wurde im Rahmen der . veröffentlicht Data Science Blogathon
Was ist Fuzzy-String-Matching??
Fuzzy-String-Matching ist die Technik, um Strings zu finden, die teilweise und nicht genau mit einem bestimmten String übereinstimmen. Wenn ein Benutzer ein Wort falsch schreibt oder ein Wort teilweise eingibt, Fuzzy String Matching hilft das richtige Wort zu finden, wie wir in Suchmaschinen sehen.
Der Algorithmus hinter dem Fuzzy-String-Matching ist nicht darauf beschränkt, die Äquivalenz zweier Strings zu beobachten, es quantifiziert vielmehr, wie nahe zwei Strings beieinander liegen. Esto de forma general se hace usando una métrica de distancia conocida como ‚distancia de edición‘. Dies bestimmt die Nähe zweier Zeichenfolgen, indem die minimalen Änderungen identifiziert werden, die erforderlich sind, um eine Zeichenfolge in eine andere umzuwandeln.. Es gibt verschiedene Arten von Bearbeitungsentfernungen, die verwendet werden können, z. B. die Levenshtein-Distanz, Hamming-Abstand, Jaros Abstand, etc.
Lassen Sie uns veranschaulichen, wie die Levenshtein-Distanz berechnet wird.
Beispiel 1:
Kette 1 = ‚Poner‘
Kette 2 = ‚Pat‘
Die Levenshtein-Distanz wäre 1, da wir den String umwandeln können 1 In der Kette 2 reemplazando ‚du‘ mit ‚ein‘.
Beispiel 2:
Kette 1 = ‚Sol‘
Kette 2 = ‚Saturno‘
Die Levenshtein-Distanz wäre 3, da wir den String umwandeln können 1 In der Kette 2 durch 3 Einsätze: ‚ein‘, ‚T‘ Ja ‚R‘.
Fuzzy-String-Matching in Python:
Vergleichen von Strings in Python
So vergleichen Sie zwei Strings in Python, wir können den folgenden Code ausführen:
Str1 = "Zurück"
Str2 = "Buch"
Ergebnis = Str1 == Str2
drucken(Ergebnis)
El código anterior dará un resultado como ‚Gefälscht‘ da die beiden Saiten nicht gleich sind.
Levenshtein-Distanz in Python
Distancia de Levenshtein en Python usando el paquete de Python ‚Levenshtein‘.
Levenshtein als Lev importieren
Str1 = "Zurück"
Str2 = "Buch"
lev.abstand(Str1.lower(),Str2.lower())
Der obige Code gibt eine Ausgabe von 2, wir können die Zeichenfolge umwandeln 1 In der Kette 2 von 2 Ersatz.
FuzzyWuzzy und Python
FuzzyWuzzy ist ein Python-Paket, das für den String-Matching verwendet werden kann. Wir können den folgenden Befehl ausführen, um das Paket zu installieren:
pip installieren fuzzywuzzy
Wie das Levenshtein-Paket, FuzzyWuzzy verfügt über eine Verknüpfungsfunktion, die die standardmäßige Levenshtein-Distanz-Ähnlichkeitsverknüpfung zwischen zwei Sequenzen berechnet.
von fuzzywuzzy importieren fuzz
Str1 = "Zurück"
Str2 = "Buch"
Verhältnis = Fuzz.Verhältnis(Str1.lower(),Str2.lower())
drucken(Verhältnis)
Die Ausgabe des folgenden Codes ergibt 50, da die Levehshtein-Bindung berechnet wird, indem der Levenshtein-Abstand durch das Maximum der Kettenlänge geteilt wird 1 und die kette 2.
Berechnen wir das Motiv für einen anderen Saitensatz.
von fuzzywuzzy importieren fuzz
Str1 = "Mein Name ist Ali"
Str2 = "Ali ist mein Name"
Verhältnis = Fuzz.Verhältnis(Str1.lower(),Str2.lower())
drucken(Verhältnis)
Die Ausgabe des Codes ergibt 50, was darauf hinweist, dass obwohl die Wörter gleich sind, Bei der Berechnung des Anteils ist die Wortstellung wichtig.
Teilverlinkung mit FuzzyWuzzy
Teilweises Verlinken hilft uns, Teilzeichenfolgen abzugleichen. Dies nimmt den kürzesten String und vergleicht ihn mit allen Teilstrings der gleichen Länge.
Str1 = "Mein Name ist Ali"
Str2 = "Mein Name ist Ali Abdaal"
drucken(fuzz.partial_ratio(Str1.lower(),Str2.lower()))
Die Ausgabe des Codes ergibt 100 als partielles_verhältnis () Überprüfen Sie einfach, ob einer der Strings ein Teilstring des anderen ist.
Diese Verknüpfung könnte sehr nützlich sein, wenn, als Beispiel, Wir versuchen, den Namen einer Person zwischen zwei Datensätzen abzugleichen. Im ersten Datensatz, die Zeichenfolge enthält den Vor- und Nachnamen der Person, und im zweiten Datensatz, die kette hat den namen, der Vor- und Nachname der Person. Der Anteil wäre 100 weil der erste String ein Teilstring des zweiten Strings ist.
Token-Klassifizierungsverhältnis mit FuzzyWuzzy
Im Token-Ranking-Verhältnis, Zeichenfolgen werden tokenisiert und vorverarbeitet, indem sie in Kleinbuchstaben umgewandelt und Satzzeichen entfernt werden. Anschließend, Strings sind alphabetisch angeordnet und verbunden. Poste das, die Levenshtein-Distanz-Ähnlichkeitsbindung wird zwischen den Strings berechnet.
Str1 = "Mein Name ist Ali"
Str2 = "Ali ist mein Name"
drucken(fuzz.token_sort_ratio(Str1,Str2))
Die Ausgabe des Codes ergibt 100, da das Token-Sortierverhältnis gefunden wird, nachdem die Strings alphabetisch sortiert wurden und, deshalb, die ursprüngliche Reihenfolge der Wörter ist egal.
Token-Set-Verhältnis mit FuzzyWuzzy
Der Token-Pool-Anteil führt eine Pool-Operation aus, die die gemeinsamen Token extrahiert, anstatt nur die Zeichenfolgen zu tokenisieren, sortieren und dann die Token wieder einfügen. Die gleichen zusätzlichen oder wiederholten Wörter spielen keine Rolle.
Str1 = "Mein Name ist Ali"
Str2 = "Ali ist mein Name"
drucken(fuzz.token_sort_ratio(Str1,Str2))
drucken(fuzz.token_set_ratio(Str1,Str2))
Die Ausgabe der Token-Klassifizierungsbindung wird zu 85, während die der Token-Set-Bindung erreicht 100, da Token-Set-Bindung wiederholte Wörter nicht berücksichtigt.
Lassen Sie uns ein weiteres Beispiel für die Tokensatz-Bindung veranschaulichen, um eine eingehendere Erklärung zu erhalten.
Str_A = 'Read the sentence - My name is Ali'
Str_B = 'My name is Ali'
ratio = fuzz.token_set_ratio(Str_A, Str_B)
drucken(Verhältnis)
Die Ausgabe des obigen Codes gibt uns 100. Das ist weil, unter der Haube, Token-Set-Bindung hat einen flexibleren Ansatz. Nach dem Löschen der gemeinsamen Zeichenfolgen (‚Mi nombre es Ali‘), Entdecken Sie die Fuzz-Bindung für die folgenden Paare und geben Sie dann den maximalen Wert unter den drei zurück:
- gemeinsamer String und gemeinsamer String mit Rest von String eins
- gemeinsamer String und gemeinsamer String mit Rest von String zwei
- gemeinsamer String mit Rest eins und gemeinsamer String mit Rest zwei
Prozedurmodul mit FuzzyWuzzy
Wenn wir eine Liste von Strings haben und wir den am nächsten passenden String aus der Liste mit einem bestimmten String finden möchten, podemos aprovechar el módulo ‚Prozess‘.
from fuzzywuzzy import process
query = 'My name is Ali'
choices = ['My name Ali', 'My name is Ali', 'My Ali']
# Erhalten Sie eine Liste der Spiele, die nach Punktzahl geordnet sind, Standardlimit auf 5
prozess.auszug(Anfrage, Entscheidungen)
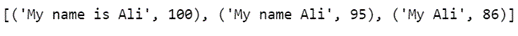
Wenn wir das Top-Match extrahieren wollen, wir können den folgenden Code ausführen:
process.extractOne(Anfrage, Entscheidungen)
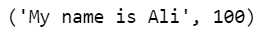
Über den Autor
Nibedita hat ihren MSc in Chemical Engineering vom IIT Kharagpur in 2014 und heute arbeitet sie als Senior Consultant bei AbsolutData Analytics. In Ihrer aktuellen Position, arbeitet an der Erstellung von Lösungen auf Basis von KI / ML für Kunden aus verschiedenen Branchen.
Die in diesem Beitrag gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





