
Während der Arbeit an einem Spark-App-Tuning-Problem, Ich habe viel Zeit damit verbracht, die Spark-Web-UI-Visualisierungen zu verstehen. Spark Web UI ist ein sehr nützliches Werkzeug für diese Aufgabe. Für Anfänger, Es wird sehr schwierig, allein aus diesen Visualisierungen Erkenntnisse über ein Problem zu gewinnen. Obwohl es sehr gute Ressourcen zur Spark-Leistung gibt, die Informationen waren verstreut. Deswegen, Ich hatte das Bedürfnis, meine Erkenntnisse zu dokumentieren und zu teilen.
Zielgruppe und Schlussfolgerungen
In diesem Beitrag wird davon ausgegangen, dass die Leser ein grundlegendes Verständnis der Spark-Konzepte haben.. Dieser Beitrag hilft Anfängern, potenzielle Leistungsprobleme in ihren Anwendungen zu erkennen, die über eine Spark-Webbenutzeroberfläche ausgeführt werden.. Der Fokus liegt nur auf den Informationen, die aus der Benutzeroberfläche nicht offensichtlich sind, und den Rückschlüssen, die aus diesen nicht offensichtlichen Informationen gezogen werden können. Beachten Sie, dass es keine vollständige Liste von Informationen enthält, die von der Spark-Webbenutzeroberfläche interpretiert werden können, aber nur die, die ich für mein Projekt relevant fand und, aber trotzdem, allgemein genug, damit das Publikum es weiß.
Spark-Webbenutzeroberfläche
Die Web-Benutzeroberfläche von Spark ist nur verfügbar, wenn die Anwendung ausgeführt wird. Um vergangene Ausführungen zu analysieren, das Verlaufsserver muss aktiviert sein, um Ereignisprotokolle zu speichern, die dann zum Ausfüllen der Web-Benutzeroberfläche verwendet werden können.
Die Spark Web-Benutzeroberfläche zeigt nützliche Informationen zu Ihrer Anwendung in Registerkarten an, nämlich
- Vollstrecker
- Umfeld
- Funktioniert
- Etapas
- Lagerung
Der verbleibende Beitrag beschreibt die Intuitionen der einzelnen Registerkarten, in der genannten Reihenfolge.
Registerkarte Executoren
Gibt Informationen über die von jedem Executor ausgeführten Aufgaben.
Feige 1: Zusammenfassung der Executor-Registerkarte
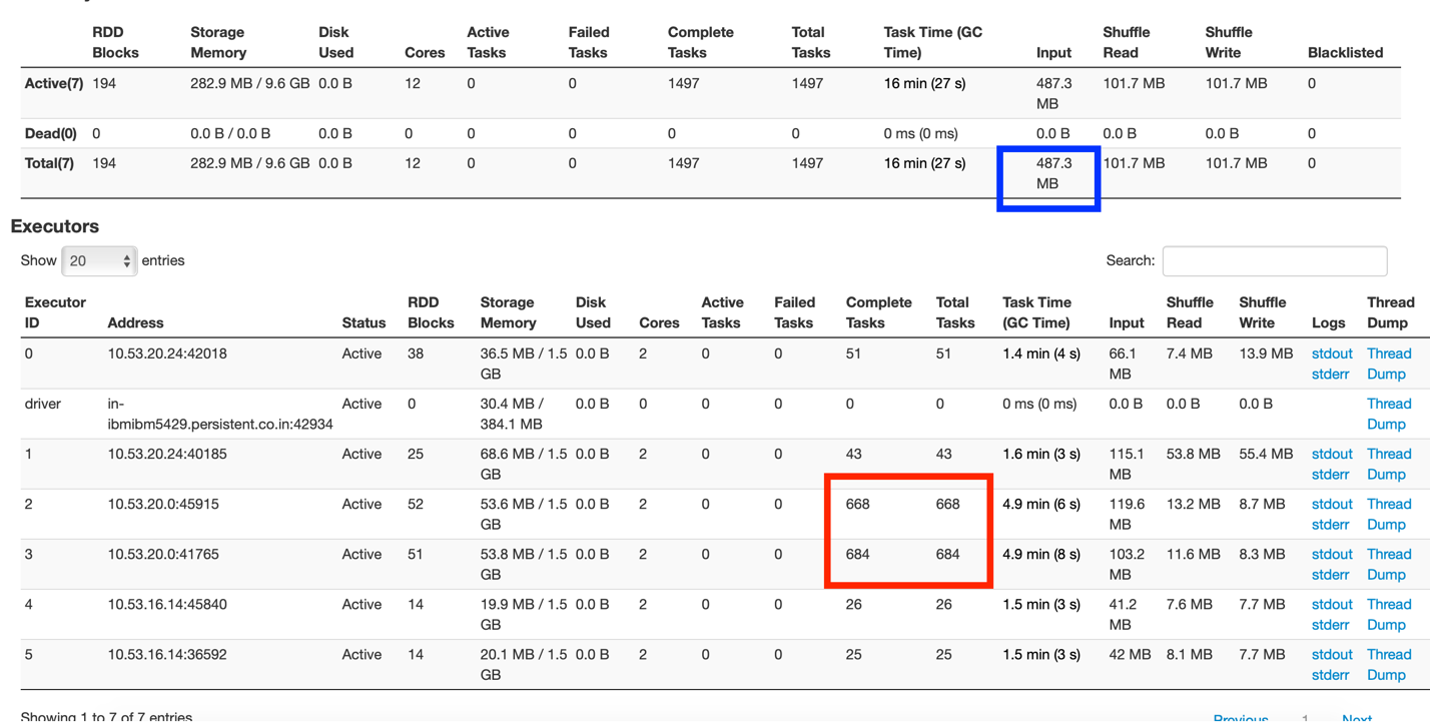
A partir de la Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... 1, Es kann verstanden werden, dass es einen Controller gibt und 5 Vollstrecker, jedes davon läuft mit 2 Kerne und 3 GB Speicher.
Die Box markiert in rot muestra la distribución desigual de las tareas en las que un KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... des ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... está exagerando las tareas, während andere relativ inaktiv sind.
Die Box markiert in Blau zeigt, dass die Größe der Eingabedaten 487,3 MB. Jetzt, Diese App wurde mit einer Datensatzgröße von ausgeführt 83 MB. Die Größe der Eingabedaten umfasst das Lesen des Originaldatensatzes und die zufälligen Datenübertragungen zwischen den Knoten. Dies zeigt, dass viele Daten gemischt wurden (Über 400+ MB) in der App.
Registerkarte Umgebung
Es gibt viele Funkeneigenschaften um die Anwendung zu steuern und anzupassen. Diese Eigenschaften können beim Senden des Jobs oder beim Erstellen des Kontextobjekts festgelegt werden. Es sei denn, die Eigenschaft wird explizit hinzugefügt, gilt nicht. Wir sind falsch anzunehmen, dass die Eigenschaften mit ihren Standardwerten angewendet werden, wenn nicht explizit angegeben. Alle angewendeten Eigenschaften können auf der Registerkarte Umgebung angezeigt werden. Wenn die Immobilie dort nicht zu sehen ist, bedeutet, dass die Eigenschaft überhaupt nicht angewendet wurde.
Registerkarte Jobs
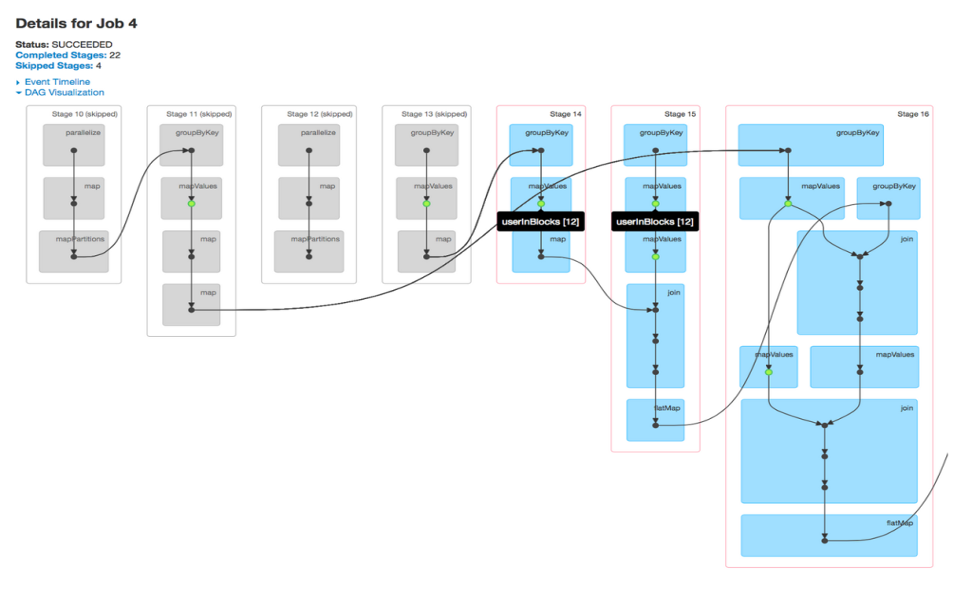
Un trabajo está asociado con una cadena de dependencias Resilient Distributed Datensatzein "Datensatz" oder Datensatz ist eine strukturierte Sammlung von Informationen, die für statistische Analysen verwendet werden können, Maschinelles Lernen oder Forschung. Datensätze können numerische Variablen enthalten, kategorisch oder textuell, und ihre Qualität ist entscheidend für zuverlässige Ergebnisse. Sein Einsatz erstreckt sich auf verschiedene Disziplinen, wie z.B. Medizin, Wirtschafts- und Sozialwissenschaften, Erleichterung einer fundierten Entscheidungsfindung und der Entwicklung von Vorhersagemodellen.... organizadas en un direktes azyklisches Diagramm (TAG) das sieht aus wie Abb. 2. Aus den DAG-Visualisierungen, Sie können die ausgeführten Etappen und die Anzahl der übersprungenen Etappen finden. Standardmäßig, Spark verwendet seine berechneten Schritte nicht stufenweise wieder, es sei denn, sie wird beibehalten oder explizit zwischengespeichert. Übersprungene Etappen sind zwischengespeicherte Etappen, die grau markiert sind, donde los valores de cálculo se almacenan en la memoria y no se vuelven a calcular después de acceder a HDFSHDFS, o Verteiltes Hadoop-Dateisystem, Es ist eine Schlüsselinfrastruktur für die Speicherung großer Datenmengen. Entwickelt für die Ausführung auf gängiger Hardware, HDFS ermöglicht die Datenverteilung über mehrere Knoten, Sicherstellung einer hohen Verfügbarkeit und Fehlertoleranz. Seine Architektur basiert auf einem Master-Slave-Modell, wobei ein Master-Knoten das System verwaltet und Slave-Knoten die Daten speichern, Erleichterung der effizienten Verarbeitung von Informationen... Ein Blick auf die DAG-Visualisierung genügt, um zu wissen, ob RDD-Berechnungen wiederholt durchgeführt oder zwischengespeicherte Stufen verwendet werden.
Feige 2: DAG-Anzeige eines Jobs
Registerkarte „Stufen“
Bietet einen tieferen Einblick in die auf Aufgabenebene ausgeführte Anwendung. Eine Stufe stellt einen Arbeitsabschnitt dar, der von einzelnen Aufgaben parallel ausgeführt wird. Es gibt eine Zuordnung 1-1 zwischen Aufgaben und Datenpartitionen, nämlich, 1 Aufgabe pro Datenpartition. Man kann sich in einen Job vertiefen, in bestimmten Phasen und bis zu jeder Aufgabe in einer Phase über die Spark-Webbenutzeroberfläche.
Die Bühne bietet einen guten Überblick über die Hinrichtungen: DAG-Anzeigen, Veranstaltungszeitpläne, zusammenfassende Messwerte / Aggregation Ihrer Aufgaben.
Ich schaue mir lieber die Zeitleisten der Ereignisse an, um die Aufgaben zu analysieren. Sie geben eine bildliche Darstellung der Details der Zeit, die in die Ausführung der Bühne investiert wurde. Mit einem Blick, Wir konnten schnell Rückschlüsse darauf ziehen, wie gut die Bühne funktionierte und wie wir die Ausführungszeit weiter verbessern könnten.
Feige 3 – Beispiel für eine Ereigniszeitachse
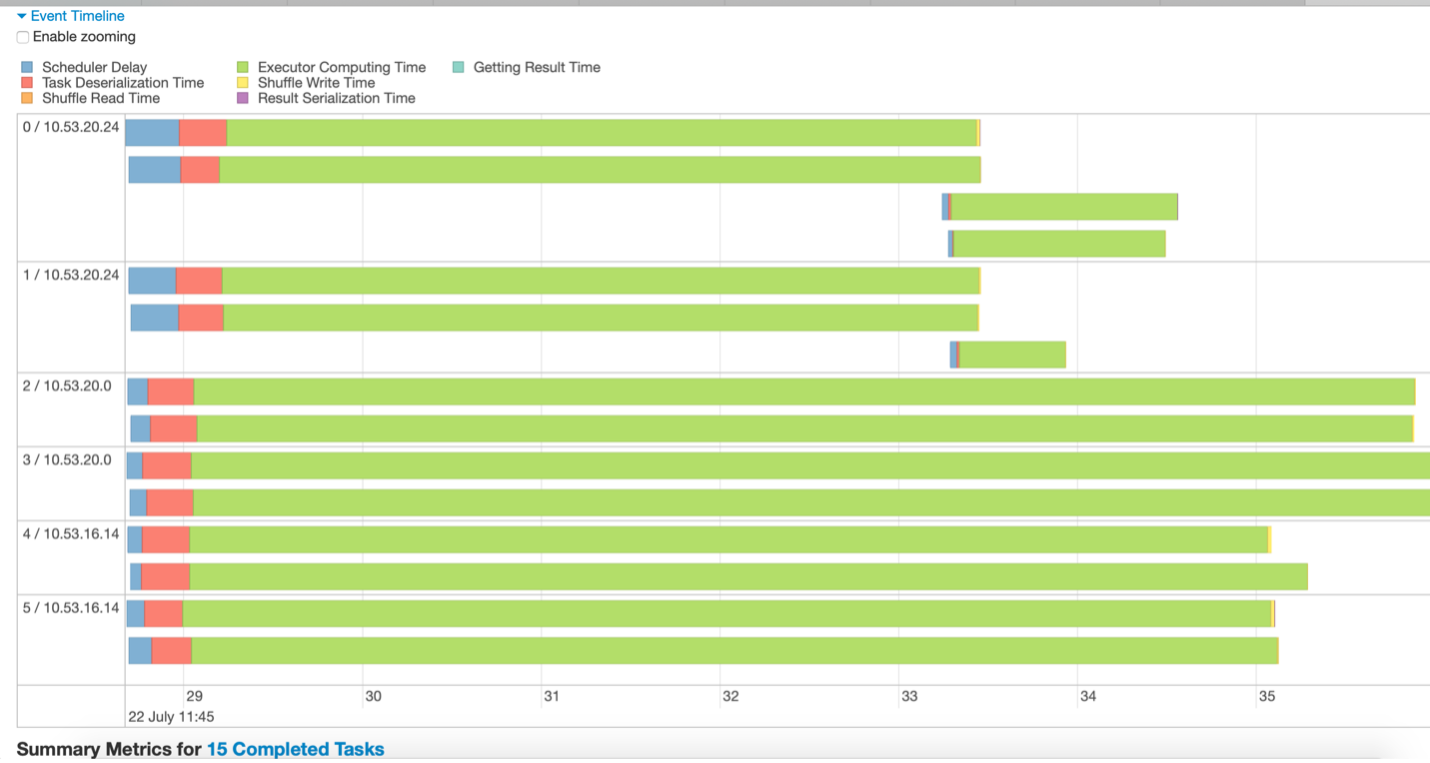
Zum Beispiel, die Schlussfolgerungen aus der Abbildung 3 Sie könnten sein:
- Die Daten sind unterteilt in 15 Partitionen. Deswegen, Sie rennen 15 Hausaufgaben (vertreten mit 15 grüne Linien).
- Aufgaben laufen in 3 Knoten, jeder mit 2 Vollstrecker
- Die Phase wird erst abgeschlossen, wenn die am längsten laufende Aufgabe endet. Andere Executoren bleiben inaktiv, bis die längste Aufgabe beendet ist.
- Einige langwierige Aufgaben, während wenige Aufgaben für eine sehr kurze Zeit ausgeführt werden, zeigt an, dass die Daten nicht gut partitioniert sind.
- Es wurde nicht viel Zeit damit verbracht, den Scheduler oder die Serialisierung zu diesem Zeitpunkt zu verzögern, was gut ist.
Feige. 4 – Einstufige Ereigniszeitleiste mit vielen Datenpartitionen.
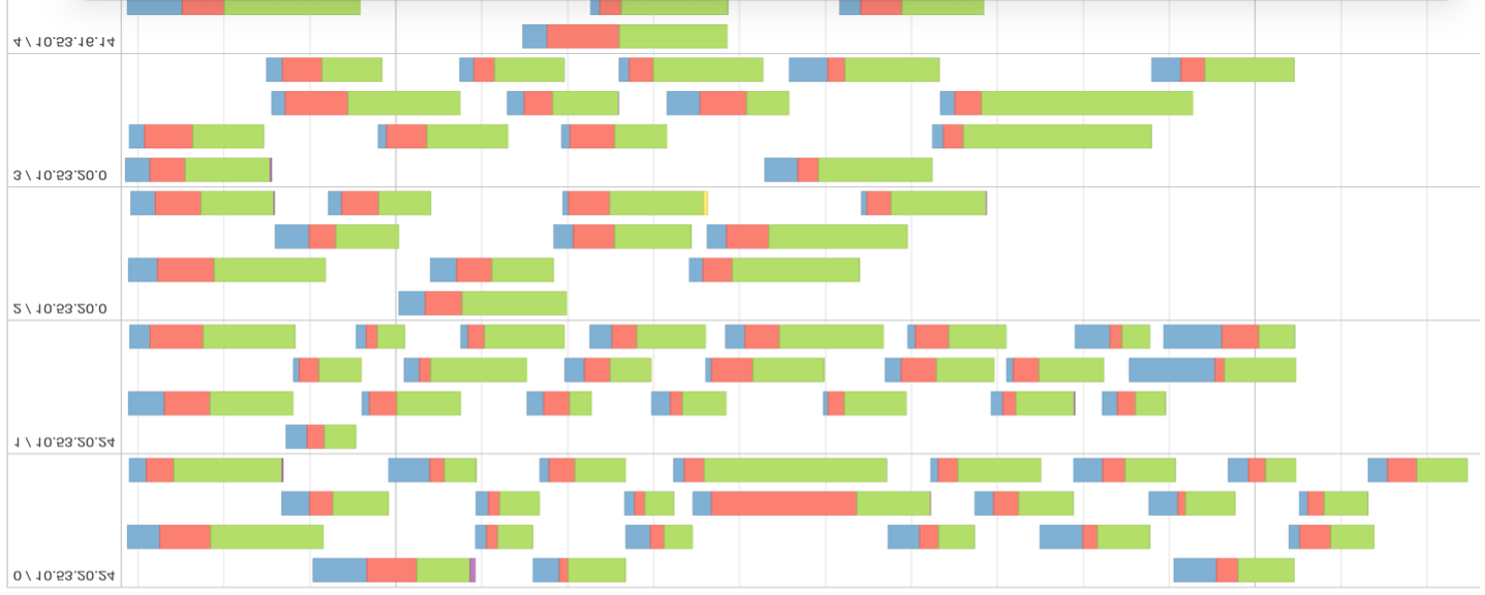
Die Figur beobachten 4, Wir können daraus schließen, dass die Daten nicht gut verteilt und unnötig partitioniert sind. Aus der Bewertungsmetrik, es kann bestätigt werden, dass die Aufgabenplanung länger gedauert hat als die tatsächliche Ausführungszeit. Je höher der Grünanteil in der Timeline, desto effizienter wird die Berechnung der Etappe.
Es ist wünschenswert, weniger Arbeitsschritte zu haben. Immer wenn Daten gemischt werden, eine neue Bühne entsteht. Mischen ist teuer und, Daher, Versuchen Sie, die Anzahl der Stufen zu reduzieren, die Ihr Programm benötigt.
Eingabedatengröße
Eine weitere wichtige Information ist, die Eingabegröße der gemischten Daten zu beachten. Eines der Ziele ist auch, die Größe dieser Zufallsdaten zu reduzieren.
Feige. 5 – Übersicht über die Registerkarte „Stufen“.
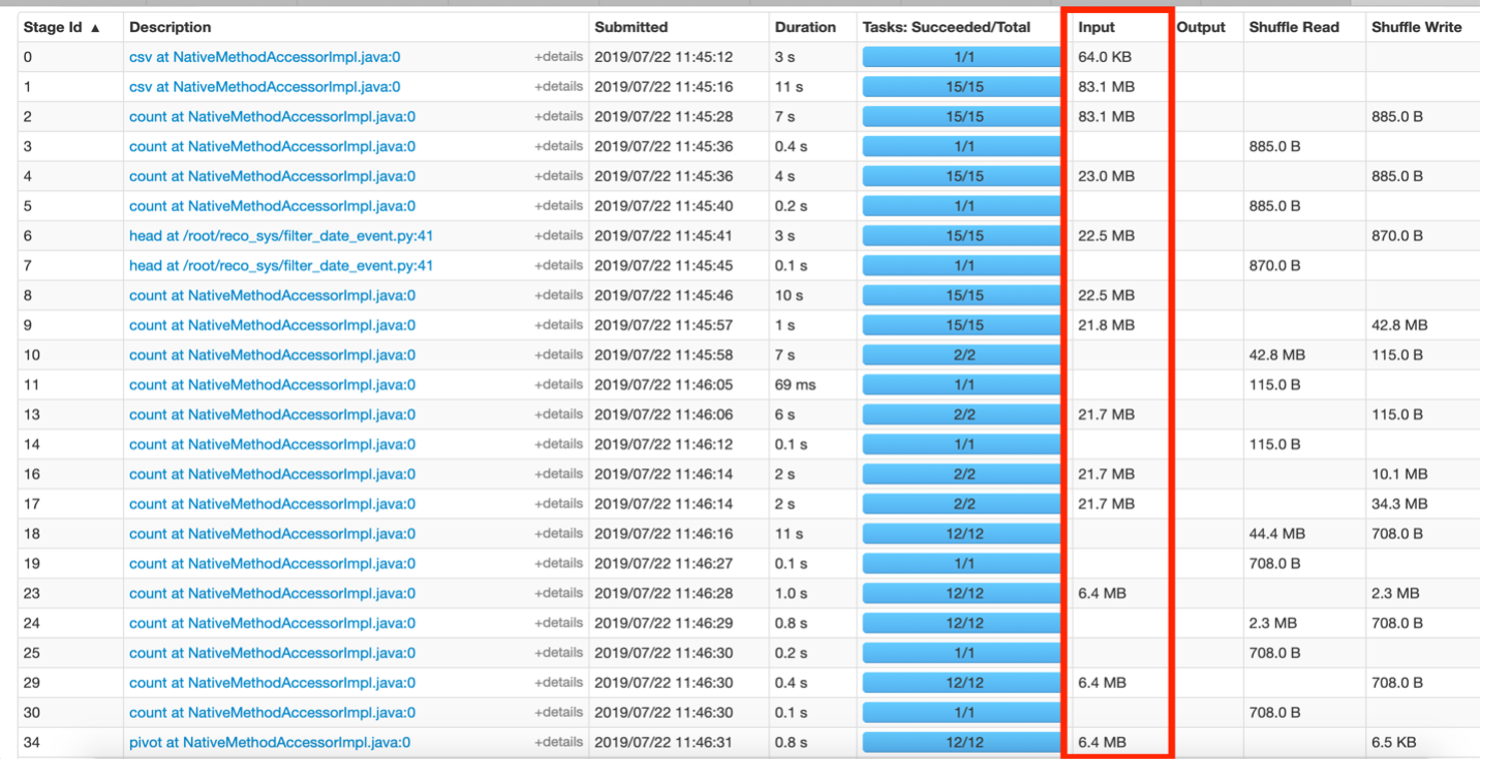
Die Figur 5 oben zeigt die Phasen, in denen sich die Daten in MB . bewegen. Dies deutet darauf hin, dass der Code verbessert werden kann, um die Größe der Daten zu reduzieren, die zwischen den Phasen ausgetauscht wurden. Zum Beispiel, digamos que si se aplicó un filtro en algunos datos para un evento ‚x‘ Würfel, dann im resultierenden RDD, la columna “evento” se vuelve redundante ya que técnicamente todas las filas son del evento ‚x‘. Diese Spalte könnte aus zukünftigen RDDs entfernt werden, die aus diesen gefilterten Daten erstellt wurden, um zusätzliche Informationen zu speichern, die während der Shuffle-Operationen übertragen werden..
ZeichenDas "Zeichen" Es ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, In der Regel bezieht man sich auf ein Dokument oder eine Karte, die bestimmte Informationen zu einem Thema enthält, Person oder Produkt. Im akademischen Umfeld, Es wird verwendet, um relevante Daten zu Forschungs- oder bibliografischen Quellen zu erfassen. Im Geschäftsumfeld, Karten können nützliche Werkzeuge sein, um Kunden- oder Produktdaten zu organisieren, Erleichterung der Verwaltung und des Zugangs zu Informationen.... de almacenamiento
Zeigt nur RDDs an, die erhalten wurden, nämlich, die verwenden persist () o verstecken (). Um es besser lesbar zu machen, Sie können das RDD benennen, während Sie es mit setName . speichern (). Nur die RDDs, die Sie behalten möchten, sollten auf der Registerkarte Speicher angezeigt werden und können mit den bereitgestellten benutzerdefinierten Namen leicht erkennbar sein..
Zusammenfassung
Dieser Artikel enthält Informationen zum Identifizieren von Problemen mit der Spark-Webbenutzeroberfläche, wie die Größe der Daten, die gemischt wurden, die Ausführungszeit der Etappen, RDD-Neuberechnung wegen fehlendem Caching. Wenn man seine Daten und seine Anwendung versteht, dann könnte die ideale Datenverteilung und die gewünschte Anzahl von Partitionen gemessen werden, indem aus der laufenden Benutzeroberfläche geschlossen wird. Der Overhead eines Knotens im Vergleich zu anderen im Cluster ist ein weiterer verbesserungswürdiger Bereich, der in dieser Benutzeroberfläche zu sehen ist. Das AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist.... de algunos de estos problemas se discute más en el Apache Spark Performance-Tuning-Artikel.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





