
Überblick
- Enfoque paso a paso para realizar EDA
- Recursos como blogs, MOOCS para familiarizarse con EDA
- Familiarizarse con diversas técnicas de visualización de datos, gráficos y diagramas.
- Demostración de algunos pasos con el fragmento de código de Python
¿Qué es lo que diferencia a un profesional de la ciencia de datos del otro?
No es aprendizaje automático, Es ist nicht tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit..., no es SQL, es análisis de datos exploratorio (EDA). Qué tan bueno es uno con la identificación de patrones / tendencias ocultos de los datos y qué tan valiosos son los conocimientos extraídos, es lo que diferencia a los profesionales de datos.
1. Was ist explorative Datenanalyse?
El análisis exploratorio de datos es un enfoque para analizar conjuntos de datos para resumir sus características principales, a menudo utilizando gráficos estadísticos y otros métodos de visualización de datos.
EDA ayuda a los profesionales de la ciencia de datos de varias maneras: –
1 Obtener una mejor comprensión de los datos
2 Identificar varios patrones de datos
3 Comprender mejor el planteamiento del problema
[ Notiz: das Datensatzein "Datensatz" oder Datensatz ist eine strukturierte Sammlung von Informationen, die für statistische Analysen verwendet werden können, Maschinelles Lernen oder Forschung. Datensätze können numerische Variablen enthalten, kategorisch oder textuell, und ihre Qualität ist entscheidend für zuverlässige Ergebnisse. Sein Einsatz erstreckt sich auf verschiedene Disziplinen, wie z.B. Medizin, Wirtschafts- und Sozialwissenschaften, Erleichterung einer fundierten Entscheidungsfindung und der Entwicklung von Vorhersagemodellen.... in this blog is being opted as iris dataset]
2. Comprobación de los detalles introductorios sobre los datos
El primer y más importante paso de cualquier análisis de datos, después de cargar el archivo de datos, debe consistir en verificar algunos detalles introductorios. Was, Nein. De columnas, Nein. de filas, tipos de características (categóricas o numéricas), tipos de datos de entradas de columna.
Fragmento de código de Python
daten.info ()
RangeIndex: 150 Karten, 0 ein 149
Columnas de datos (5 Spalten insgesamt):
# Columna Tipo de recuento no nulo
– —— ————– —–
0 sepal_length 150 no nulo float64
1 sepal_width 150 float64 no nulo
2 Blütenblattlänge 150 no nulo float64
3 petal_width 150 no nulo float64
4 especies 150 objeto no nulo
dtypes: float64 (4), Objekt (1)
Speichernutzung: 6.0+ KB
daten.kopf () Para mostrar las primeras cinco filas
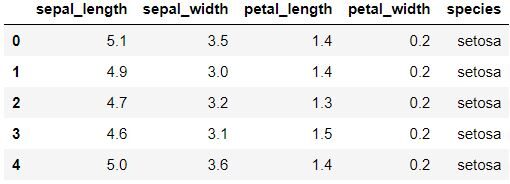
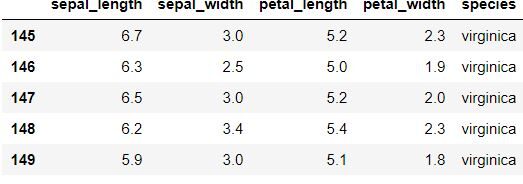
data.tail () para mostrar las últimas cinco filas
3. Perspectiva estadística
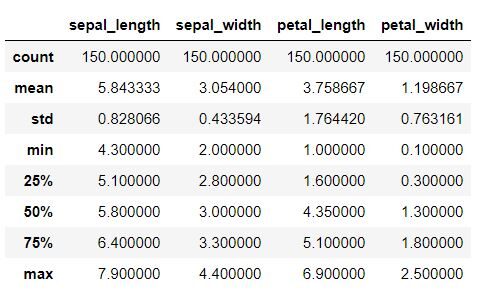
Este paso debe realizarse para obtener detalles sobre varios datos estadísticos como media, Standardabweichung, MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird...., valor máximo, valor mínimo.
Fragmento de código de Python
Daten.beschreiben ()
4. Datenbereinigung
Este es el paso más importante en EDA que implica eliminar filas / columnas duplicadas, llenar las entradas vacías con valores como la media / mediana de los datos, eliminar varios valores, eliminar entradas nulas
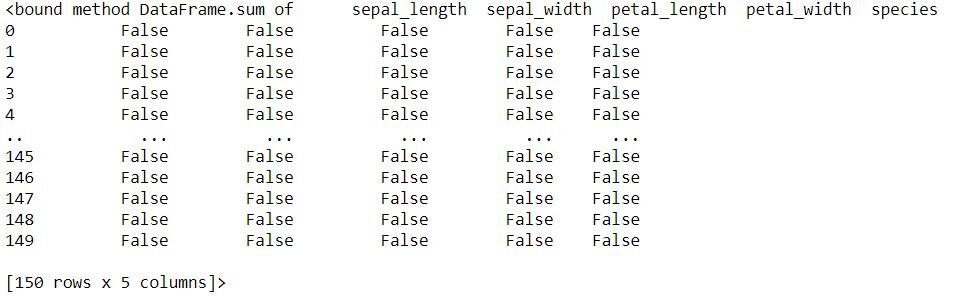
Comprobación de entradas nulas
Fragmento de código de Python
data.IsNull (). sum da el número de valores perdidos para cada VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern....
Eliminar entradas nulas
Fragmento de código de Python
data.dropna (Achse = 0, inplace = wahr) Si hay entradas nulas
Rellenar valores en lugar de entradas nulas (si es una función numérica)
Los valores pueden ser la media, la mediana o cualquier número entero
Fragmento de código de Python
Daten[“sepal_length”].Fillna (valor = datos[“sepal_length”].bedeuten (), inplace = wahr) si hay una entrada nula
Comprobación de duplicados
Fragmento de código de Python
data.duplicated (). Summe () devuelve el número total de entradas duplicadas
Duplikate entfernen
Fragmento de código de Python
data.drop_duplicates (inplace = wahr)
5. Datenvisualisierung
La visualización de datos es el método de convertir datos sin procesar en una forma visual, como un mapa o gráfico, para que los datos sean más fáciles de entender y extraer información útil..
El objetivo principal de la visualización de datos es poner grandes conjuntos de datos en una representación visual. Es uno de los pasos importantes y sencillos cuando se trata de ciencia de datos.
Puede consultar el blog a continuación para obtener más detalles sobre la visualización de datos.
Varios tipos de análisis de visualización son:
ein. Univariate Analyse:
Esto muestra cada observación / distribución de datos en una sola variable de datos.. Se puede mostrar con la ayuda de varios diagramas como AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen...., diagrama de líneas, diagrama de histograma (abstrakt), BoxplotsBox-Diagramme, Auch bekannt als Box- und Whisker-Diagramme, sind statistische Werkzeuge, die die Verteilung eines Datensatzes darstellen. Diese Diagramme zeigen den Median, Quartile und Ausreißer, Ermöglicht die Visualisierung von Datenvariabilität und -symmetrie. Sie sind nützlich für den Vergleich zwischen verschiedenen Gruppen und in der explorativen Analyse, So lassen sich Trends und Muster in den Daten leichter erkennen...., Violin-DiagrammDas Geigendiagramm ist eine grafische Darstellung, die Merkmale eines Boxplots und eines Dichtediagramms kombiniert. Wird verwendet, um die Verteilung eines Datasets zu visualisieren, zeigt sowohl den Median als auch die Variabilität durch ihre Form, die einer Geige ähnelt. Diese Art von Diagramm ist sehr nützlich für die statistische Analyse, Da es ermöglicht, mehrere Verteilungen auf klare und effektive Weise zu vergleichen...., etc.
B. Análisis bi-variable:
Se realizan pantallas de análisis bivariante para revelar la relación entre dos variables de datos. También se puede mostrar con la ayuda de diagramas de dispersión, HistogrammeHistogramme sind grafische Darstellungen, die die Verteilung eines Datensatzes darstellen. Sie werden konstruiert, indem der Wertebereich in Intervalle unterteilt wird, Ö "Behälter", und zählen, wie viele Daten in jedem Intervall fallen. Diese Visualisierung ermöglicht es Ihnen, Muster zu erkennen, Trends und Variabilität von Daten effektiv, Erleichterung statistischer Analysen und fundierter Entscheidungsfindung in verschiedenen Disziplinen...., Heatmaps, Boxplots, Geigendiagramme, etc.
C. Analyse multivariabel:
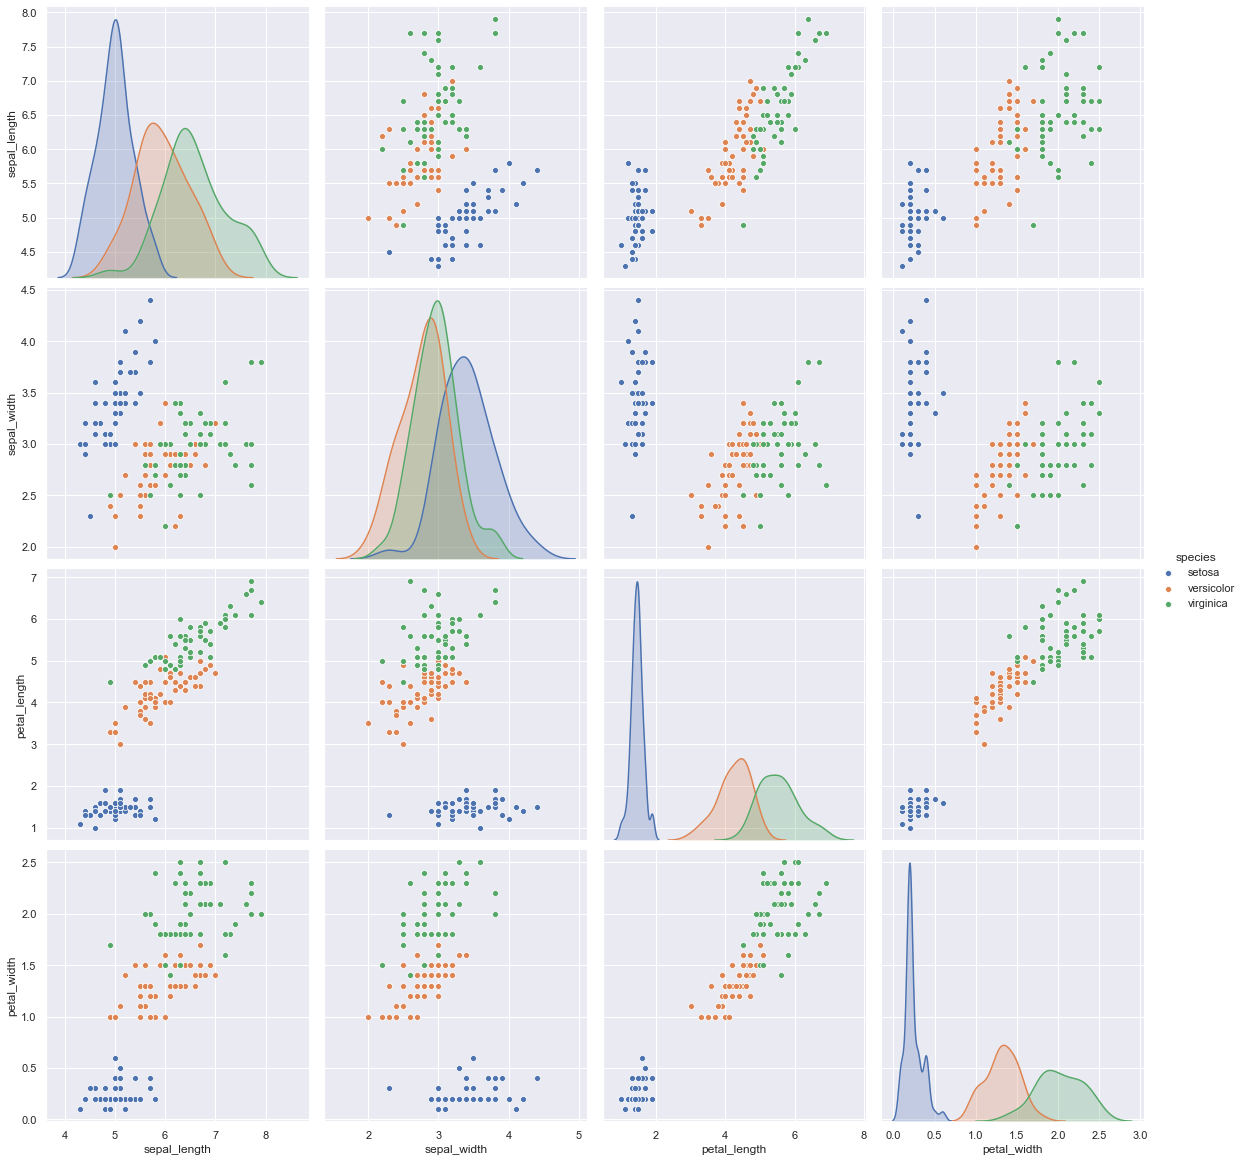
El análisis multivariado, wie der Name schon sagt, se muestran para revelar la relación entre más de dos variables de datos.
Streudiagramme, Histogramme, Boxplots, diagramas de violín se pueden utilizar para análisis multivariante
Varias parcelas
Nachfolgend werden einige der Grafiken angezeigt, die für die univariate Analyse implementiert werden können, bivariat und multivariat
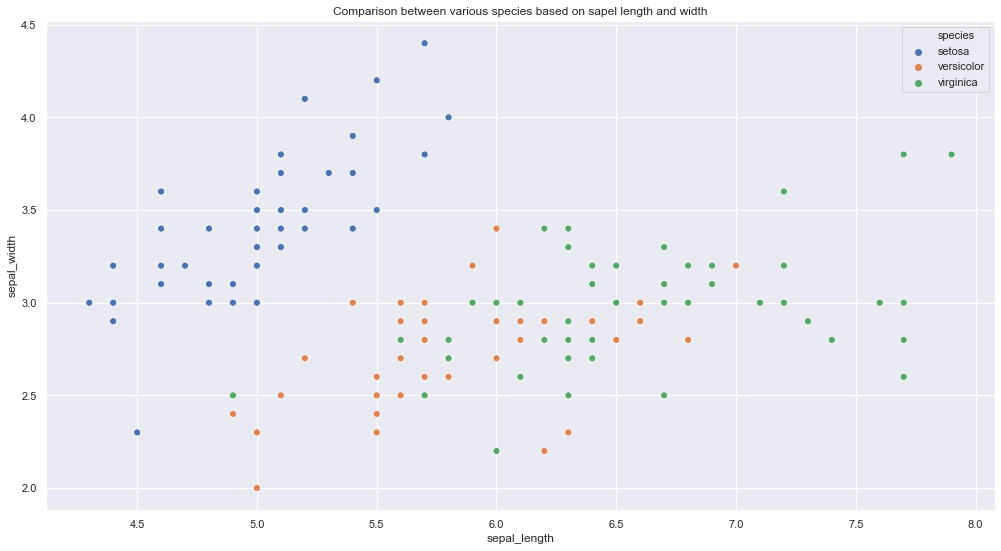
ein. StreudiagrammEin Streudiagramm ist eine visuelle Darstellung, die die Beziehung zwischen zwei numerischen Variablen mithilfe von Punkten auf einer kartesischen Ebene zeigt. Jede Achse stellt eine Variable dar, und die Position jedes Punktes gibt seinen Wert in Bezug auf beide an.. Diese Art von Diagramm ist nützlich, um Muster zu erkennen, Korrelationen und Trends in den Daten, Erleichterung der Analyse und Interpretation quantitativer Zusammenhänge....
Fragmento de código de Python
plt.figur (Feigengröße = (17,9))
plt.titel (‚Vergleich verschiedener Arten anhand der Länge und Breite des Sepals‘)
sns.streudiagramm (Daten['sepal_length'],Daten['sepal_width'], Farbe = Daten['species'], s = 50)
Für die multivariate Analyse
Fragmento de código de Python
sns.pairplot (Daten, Farbton = 'Art', Höhe = 4)
B. Box-Plot
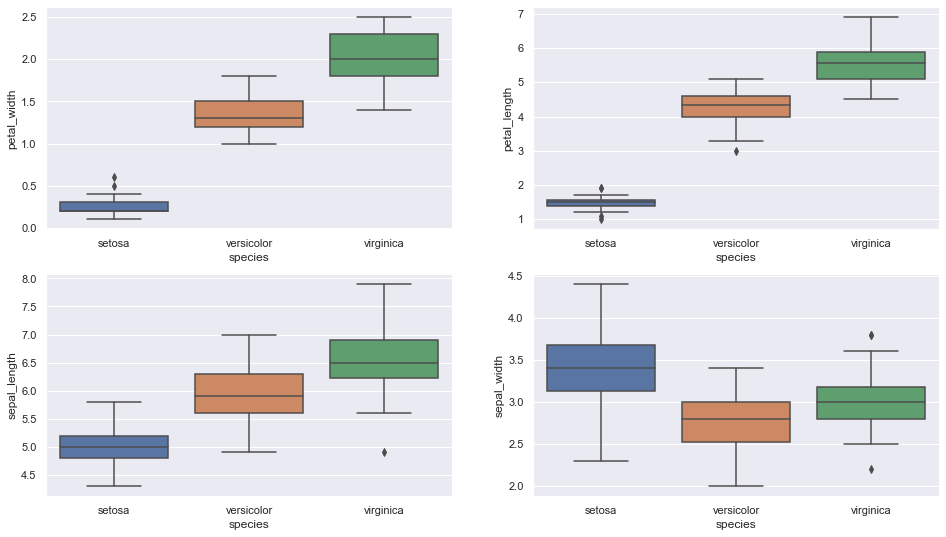
Boxplot, um zu sehen, wie sich die kategoriale Eigenschaft verteilt „Art“ mit den anderen vier Eingangsvariablen
Fragmento de código de Python
Feige, Achsen = plt.subplots (2, 2, Feigengröße = (16,9))
sns.boxplot (y = „petal_width“, x = „Art“, Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[0, 0])
sns.boxplot (y = „Blütenblattlänge“, x = „Art“, Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[0, 1])
sns.boxplot (y = 'sepal_length', x = 'Art', Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[1, 0])
sns.boxplot (y = „sepal_width“, x = „Art“, Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[1, 1])
plt.zeigen ()
C. Violinrahmen
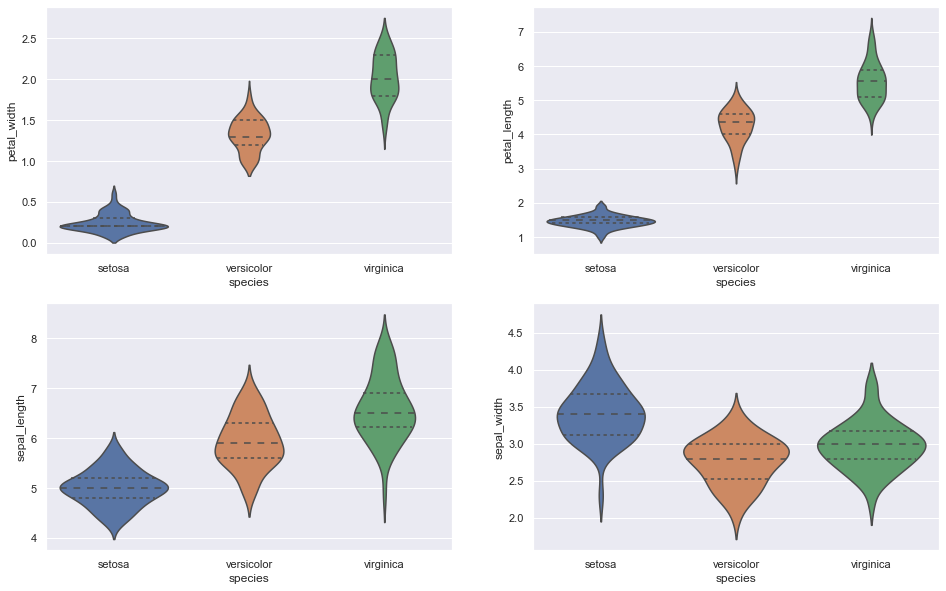
Informationsreicher als ein Boxplot und zeigt die vollständige Verteilung der Daten.
Fragmento de código de Python
Feige, Achsen = plt.subplots (2, 2, Feigengröße = (16,10))
sns.violinplot (y = 'petal_width', x = 'Art', Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[0, 0], Inneres = ‚Quartil‘)
sns.violinplot (y = „Blütenblattlänge“, x = „Art“, Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[0, 1], Inneres = ‚Quartil‘)
sns.violinplot (y = 'sepal_length', x = 'Art', Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[1, 0], Inneres = ‚Quartil‘)
sns.violinplot (y = 'sepal_width', x = 'Art', Daten = iris_data, Orientierung = ‚v‘, Achse = Achsen[1, 1], Inneres = ‚Quartil‘)
plt.zeigen ()
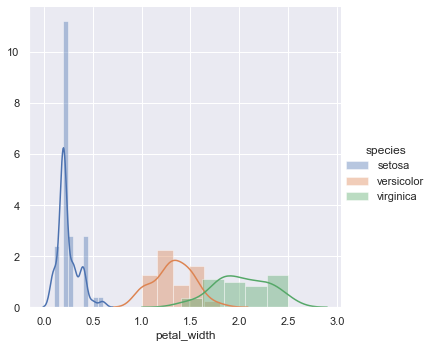
D. Histogramme
Es kann verwendet werden, um die Wahrscheinlichkeitsdichtefunktion zu visualisieren (PDF)
Fragmento de código de Python
sns.FacetGrid (iris_data, Farbton = 'Art', Höhe = 5)
.Karte (sns.distplot, „petal_width“)
.add_legend ();
Damit beende ich diesen Blog.
Hallo allerseits, Namasté
Ich heiße Pranshu Sharma Und ich bin ein Data Science-Enthusiast
Vielen Dank, dass Sie sich Ihre wertvolle Zeit genommen haben, um diesen Blog zu lesen.. Auf Fehler gerne hinweisen (schließlich, ich bin lehrling) und hinterlasse die entsprechenden Kommentare oder hinterlasse einen Kommentar.
Dhanyvaad !!
Rückmeldung:
Email: [E-Mail geschützt]
Sie können den unten genannten Blog konsultieren, um sich mit der explorativen Datenanalyse vertraut zu machen.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





