
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Luftzug. EDA ist der Prozess der Untersuchung des Datensatzes, um Muster und Anomalien zu entdecken (Atypische Werte) und formulieren Hypothesen basierend auf unserem Verständnis des Datensatzes.
EDA umfasst das Generieren von zusammenfassenden Statistiken für numerische Daten im Datensatz und das Erstellen verschiedener grafischer Darstellungen, um die Daten besser zu verstehen.. In diesem Artikel, wir werden EDA anhand eines Beispieldatensatzes verstehen. wir werden verwenden Felshaken Idiom (Pandas Bücherei) für diesen Zweck.
Bibliotheken importieren
Wir beginnen mit dem Importieren der Bibliotheken, die wir für die Durchführung von EDA benötigen. Dazu gehören NumPy, Pandas, Matplotlib und Seaborn.
numpy als np importieren
Pandas als pd importieren
import matplotlib.pyplot als plt
%matplotlib inline
import seaborn als sns
Daten lesen
Jetzt werden wir die Daten aus einer CSV-Datei in einen Pandas DataFrame einlesen. Du kannst Laden Sie den Datensatz herunter für ihre referenz.
df = pd.read_csv(r'C:users_vipin_data_analytics_students_performance.csv)
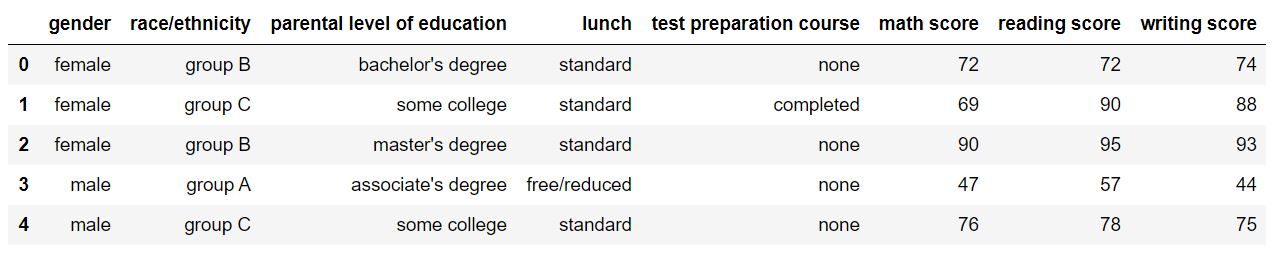
Schauen wir uns an, wie unser Datensatz mit df.head aussieht (). Die Ausgabe sollte so aussehen:
Beschreibende Statistik
Perfekt! Daten sehen genau so aus, wie wir es wollten. Sie können dies leicht erkennen, indem Sie sich den Datensatz ansehen, der Daten über verschiedene Schüler einer Schule enthält / Universität und ihre Ergebnisse in 3 Themen. Beginnen wir mit einem Blick auf die ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Deskriptive Statistiken für das Dataset. Wir werden beschreiben () dafür.
df.describe(einschließen="alle")
Durch Zuweisen des Einschlussattributs zum Wert ‚alle‘, wir achten darauf, dass auch kategoriale Merkmale in das Ergebnis einfließen. Der Ausgabe-DataFrame sollte so aussehen:
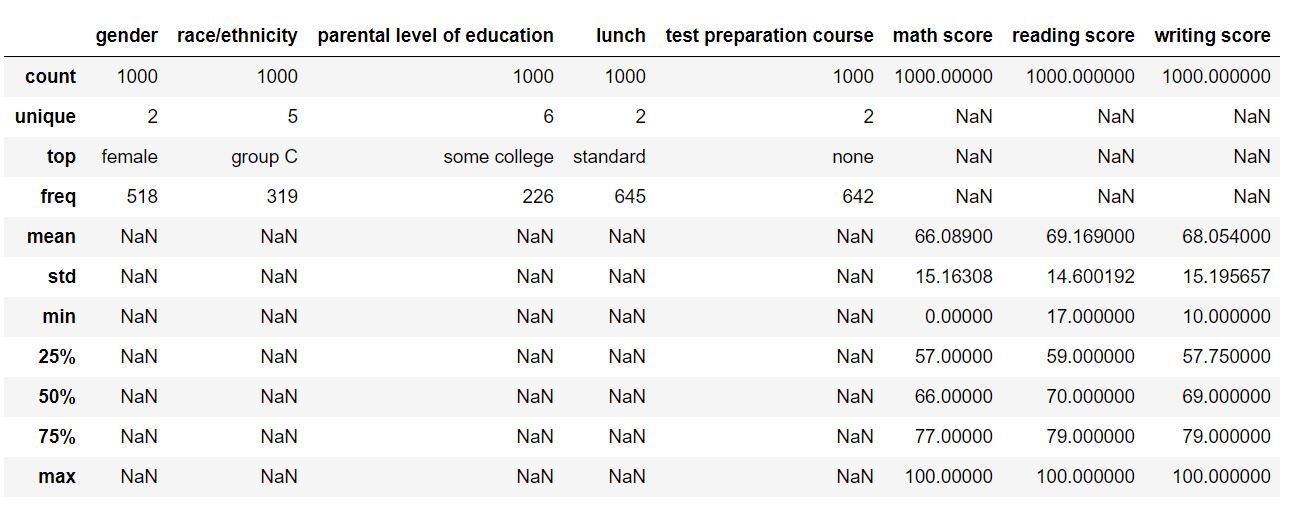
Für numerische Parameter, Felder wurden als Mittelwert ausgefüllt, die Standardabweichung, die Perzentile und das Maximum. Für kategoriale Merkmale, Die Zählung ist abgeschlossen, das einzige, Der Vorgesetzte (häufigster Wert) und die entsprechende Frequenz. Dies gibt uns einen breiten Überblick über unseren Datensatz.
Fehlende Wertanrechnung
Jetzt werden wir nach fehlenden Werten suchen. in unserem Datensatz. Bei fehlenden Tickets, wir werden ihnen die entsprechenden Werte unterstellen (Modus im Falle von kategorialen Merkmalen und MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... oder Durchschnitt bei numerischen Merkmalen). Wir verwenden die isnull-Funktion () für diesen Zweck.
df.isnull().Summe()
Dies wird uns sagen, wie viele fehlende Werte wir in jeder Spalte unseres Datensatzes haben. Der Ausgang (Pandas-Serie) es sollte so aussehen:
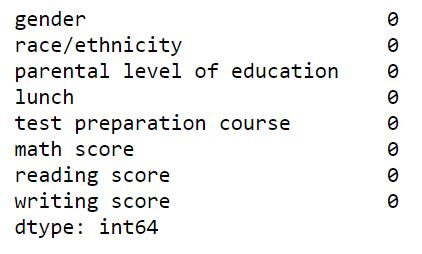
Zum Glück für uns, keine fehlenden Werte in diesem Datensatz. Jetzt werden wir diesen Datensatz analysieren, Muster beobachten und Ausreißer mit Hilfe von Grafiken und Zahlen erkennen.
Grafische Darstellung
Wir beginnen mit Univariate Analyse. Wir werden a . verwenden BalkengrafikDas Balkendiagramm ist eine visuelle Darstellung von Daten, die rechteckige Balken verwendet, um Vergleiche zwischen verschiedenen Kategorien anzuzeigen. Jeder Balken stellt einen Wert dar, und seine Länge ist proportional zu ihm. Diese Art von Diagramm ist nützlich, um Trends zu visualisieren und zu analysieren, Erleichterung der Interpretation quantitativer Informationen. Es ist in verschiedenen Disziplinen weit verbreitet, wie z.B. Statistiken, Marketing und Forschung, Aufgrund seiner Einfachheit und Effektivität.... für diesen Zweck. Wir werden die Verteilung der Studierenden nach Geschlecht beobachten, Rennen / ethnische Zugehörigkeit, ihren Mittagsstatus und ob sie einen Prüfungsvorbereitungskurs haben oder nicht.
plt.subplot(221)

df[geschlecht].value_counts().Handlung(kind='bar', Titel="Geschlecht der Studierenden", Feigengröße=(16,9))

plt.xticks(Drehung=0)

plt.subplot(222)

df[rase/ethnizität].value_counts().Handlung(kind='bar', Titel="Rasse/Ethnie der Schüler")

plt.xticks(Drehung=0)

plt.subplot(223)

df[mittagessen].value_counts().Handlung(kind='bar', Titel="Mittagsstatus der Studenten")

plt.xticks(Drehung=0)

plt.subplot(224)

df[testvorbereitungskurs].value_counts().Handlung(kind='bar', Titel="Prüfungsvorbereitungskurs")

plt.xticks(Drehung=0)

plt.zeigen()
Die Ausgabe sollte so aussehen:
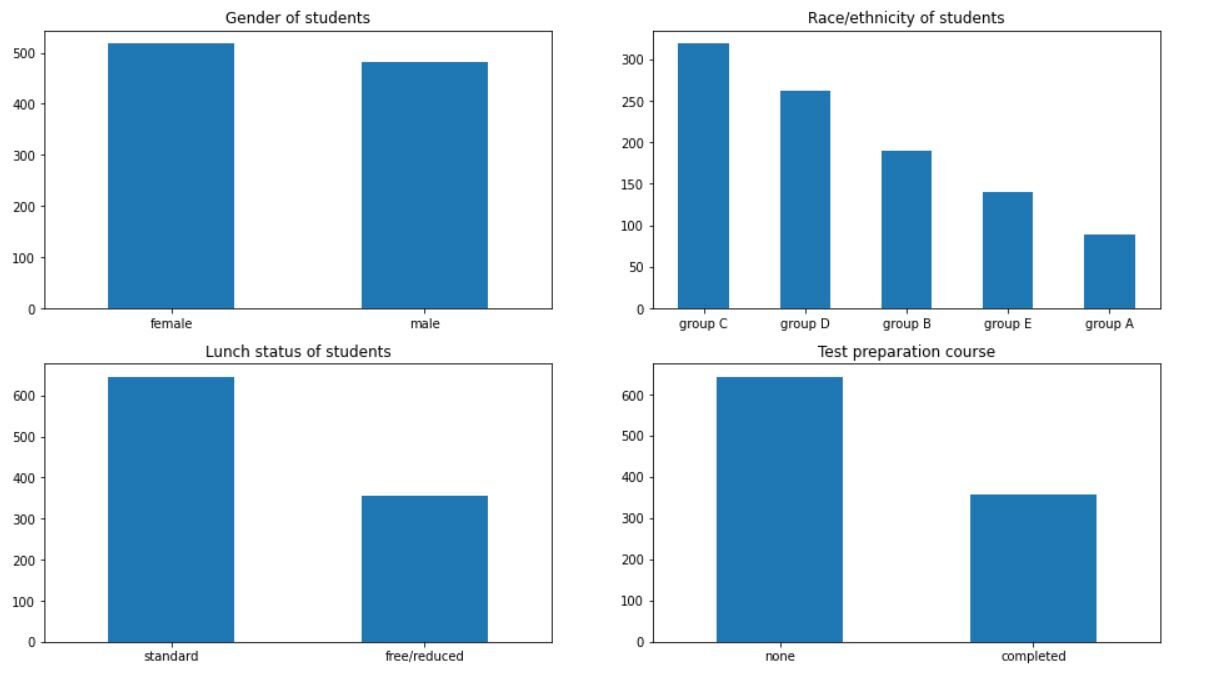
Wir können viele Dinge aus der Grafik ableiten. Es gibt mehr Mädchen in der Schule als Jungen. Die meisten Schüler gehören zu den Gruppen C und D. Mehr als 60% der Schüler haben ein normales Mittagessen in der Schule. Was ist mehr, mehr als 60% der Studierenden haben keine Prüfungsvorbereitungskurse besucht.
Weiter mit der univariaten Analyse, dann, wir werden a machen Box-Plot der numerischen Spalten (Mathe-Ergebnis, Partitur lesen und Partitur schreiben) im Datensatz. Ein Boxplot hilft uns, die Daten in Quartilen zu visualisieren. Identifiziert auch Ausreißer im Datensatz, Wenn da wären. Wir verwenden die Boxplot-Funktion () dafür.
df.boxplot()
Die Ausgabe sollte so aussehen:
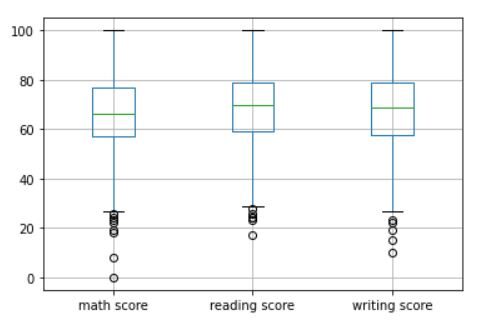
Der mittlere Teil repräsentiert den Interquartilsabstand (IQR). Die horizontale grüne Linie in der Mitte stellt den Median der Daten dar. Hohle Kreise in der Nähe der Enden stellen Ausreißer im Datensatz dar. Aber trotzdem, da es durchaus möglich ist, dass ein Schüler bei einem Test extrem schlecht abschneidet, wir werden diese atypischen Werte nicht eliminieren.
Jetzt machen wir a Verteilungsdiagramm der Mathematikergebnisse der Schüler. Ein Verteilungsdiagramm sagt uns, wie die Daten verteilt sind. Wir verwenden die distplot-Funktion.
sns.distplot(df[mathepunktzahl])
Der Plot in der Ausgabe sollte so aussehen:
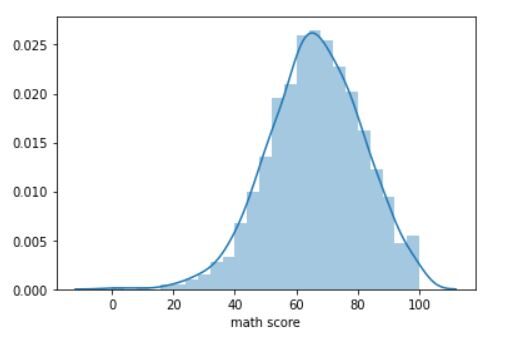
Der Graph stellt eine perfekte Glockenkurve aus der Nähe dar. Der Gipfel ist in der Nähe 65 Punkte, der Mittelwert der Mathematikergebnisse der Schüler im Datensatz. Ein ähnliches Verteilungsdiagramm kann auch für Lese- und Schreibergebnisse erstellt werden..
Jetzt sehen wir den Zusammenhang zwischen 3 punktet mit Hilfe von a Heatmapein "Heatmap" ist eine grafische Darstellung, die Farben verwendet, um die Dichte von Daten in einem bestimmten Bereich anzuzeigen. Häufig in der Datenanalyse verwendet, Marketing und Verhaltensstudien, Diese Art der Visualisierung ermöglicht es Ihnen, Muster und Trends schnell zu erkennen. Durch chromatische Variationen, Heatmaps erleichtern die Interpretation großer Informationsmengen, dabei helfen, fundierte Entscheidungen zu treffen..... Dafür, Wir werden die corr-Funktion verwenden () y Heatmap () für diese Übung.
korr = df.korr()
sns.heatmap(korr, annot=Wahr, quadrat=wahr)
plt.yticks(Drehung=0)
plt.zeigen()
Der Plot in der Ausgabe sollte so aussehen:
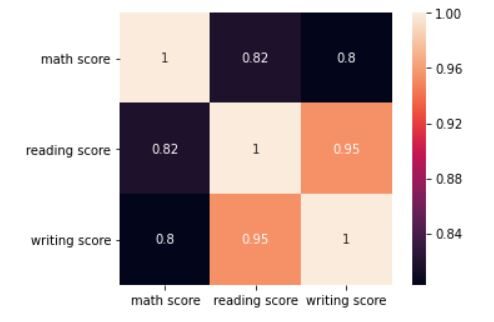
Die Heatmap zeigt das 3 Scores sind stark korreliert. Der Lesescore hat einen Korrelationskoeffizienten von 0,95 mit Schreibpartitur. Der mathematische Score hat einen Korrelationskoeffizienten von 0,82 mit der Lesepartitur und 0,80 mit Schreibpartitur.
Jetzt gehen wir weiter zu Bivariate Analyse. Wir werden uns einen anschauen relationaler Plot de Seaborn. Es hilft uns, die Beziehung zwischen 2 Variablen in verschiedenen Teilmengen des Datensatzes. Wir werden versuchen, die Beziehung zwischen der Mathematiknote und der Schreibnote von Schülern unterschiedlichen Geschlechts zu verstehen.
sns.relplot(x='mathepunktzahl', y='schreibungspunktzahl', Farbton="Geschlecht", Daten=df)
Der relationale Plot sollte so aussehen:
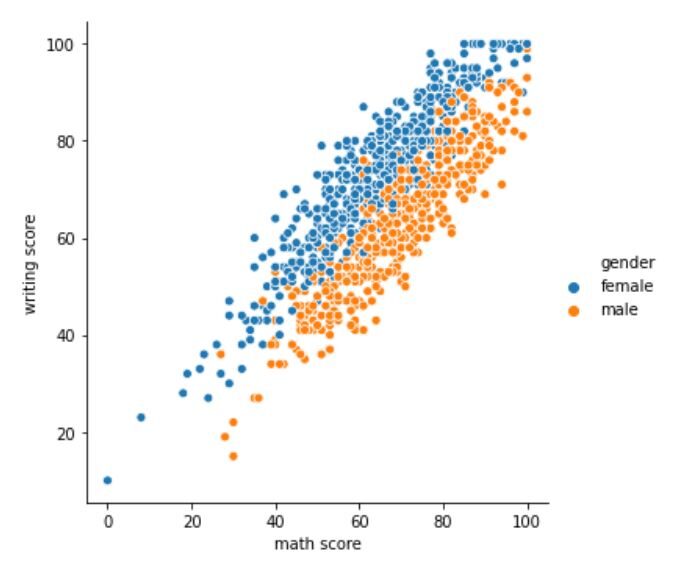
Die Grafik zeigt einen deutlichen Unterschied in den Ergebnissen zwischen männlichen und weiblichen Studierenden. Für die gleiche Punktzahl in Mathe, Studentinnen haben häufiger bessere Noten als männliche Studenten. Aber trotzdem, für die gleiche Schreibpartitur, Von männlichen Schülern wird erwartet, dass sie in Mathematik bessere Ergebnisse erzielen als weibliche Schüler.
Relationale Graphen helfen uns bei der bivariaten Analyse. Sie können sich auf die Dokumentation der relplot-Funktion beziehen () de Seaborn hier.
Schließlich, Wir analysieren die Leistungen der Schüler in Mathematik, Lesen und Schreiben entsprechend dem Bildungsstand deiner Eltern und dem Verlauf der Prüfungsvorbereitung. Zuerst, Werfen wir einen Blick auf den Einfluss des Bildungsniveaus der Eltern auf die schulischen Leistungen ihrer Kinder mit Hilfe von a Liniendiagramm.
df.groupby(bildungsniveau der eltern)[[mathepunktzahl, lesepunktzahl, schreibungspunktzahl]].bedeuten().T.plot(Feigengröße=(12,8))
Die Ausgabe sieht so aus:
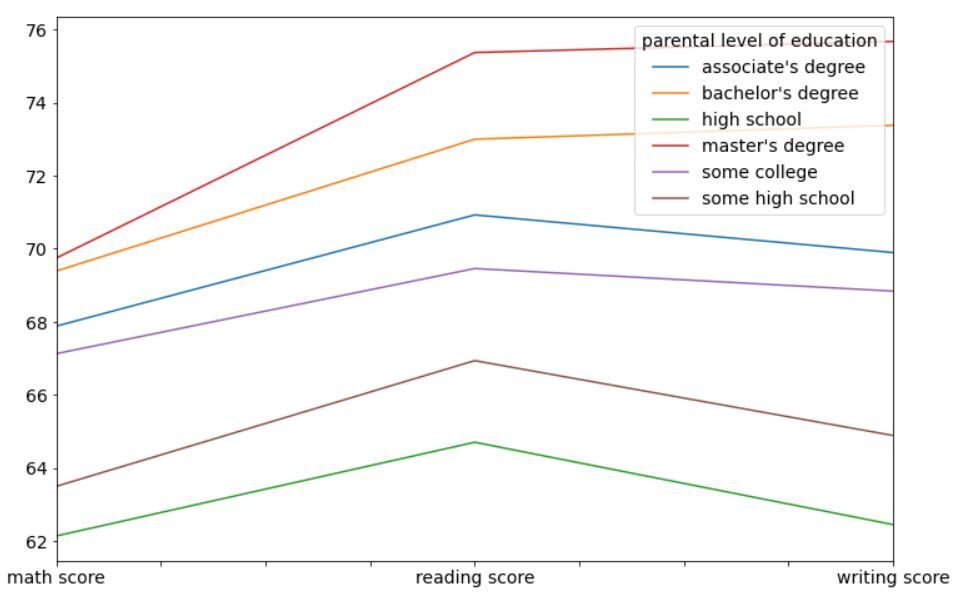
Aus dieser Grafik geht sehr deutlich hervor, dass Schüler, deren Eltern gebildeter sind als andere (Master-Studium, Bachelor und Associate Degree) schneiden im Durchschnitt besser ab als Schüler, deren Eltern eine geringere Bildung haben (weiterführende Schule). Dies kann ein genetischer Unterschied oder einfach ein Unterschied in der häuslichen Umgebung der Schüler sein. Besser gebildete Eltern drängen ihre Schüler eher zum Studium.
Zweitens, Schauen wir uns die Auswirkungen des Prüfungsvorbereitungskurses auf die Leistung der Schüler mit a . an horizontales Balkendiagramm.
df.groupby(testvorbereitungskurs)[[mathepunktzahl, lesepunktzahl, schreibungspunktzahl]].bedeuten().T.plot(art='balkendiagramm', Feigengröße=(10,10))
Die Ausgabe sollte so aussehen:
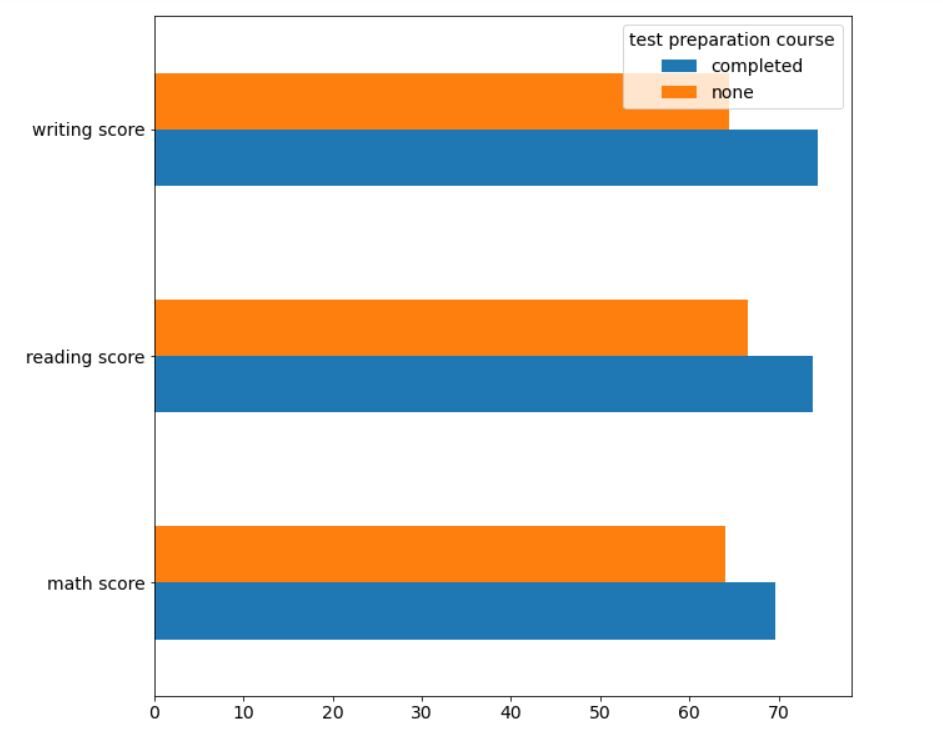
Ein Mal noch, Es ist ganz klar, dass die Schüler, die den Prüfungsvorbereitungskurs abgeschlossen haben, besser abgeschnitten haben, im Durchschnitt, im Vergleich zu Studierenden, die sich nicht für den Kurs entschieden haben.
Abschließende Anmerkungen
In diesem Artikel, Wir haben die Bedeutung der Explorativen Datenanalyse verstanden (EDA) mit Hilfe eines Beispieldatensatzes. Wir schauen uns an, wie wir den Datensatz analysieren können, Schlüsse daraus ziehen und darauf aufbauend eine Hypothese aufstellen.
Der Autor dieses Artikels ist Vishesh Arora. Du kannst dich mit mir verbinden unter LinkedIn.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





