
Überblick
- Hadoop gehört zu den beliebtesten Tools im Bereich Data Engineering und Big Data
- Hier ist eine Einführung in alles, was Sie über das Hadoop-Ökosystem wissen müssen.
Einführung
Heutzutage, wir haben mehr als 4 eine Milliarde Internetnutzer. In Bezug auf Rohdaten, so sieht das bild aus:
9.176 Tweets pro Sekunde
1.023 Pro Sekunde hochgeladene Instagram-Bilder
5.036 Skype-Anrufe pro Sekunde
86,497 Google-Suchen pro Sekunde
86,302 YouTube-Videos, die pro Sekunde angesehen werden
2.957.983 Versendete E-Mails pro Sekunde
und vieles mehr…
Das ist die Datenmenge, mit der wir es derzeit zu tun haben: tolle! Es wird geschätzt, dass am Ende des 2020 wird produziert haben 44 Zettabyte an Daten. Das ist 44 * 10 ^ 21!
Diese riesige Datenmenge, die mit hoher Geschwindigkeit und in allen möglichen Formaten generiert wird, nennt man heute Big Data. Es ist jedoch nicht möglich, diese Daten in den traditionellen Systemen zu speichern, die wir seit mehr als 40 Jahre. Um mit diesen Big Data umzugehen, wir brauchen ein viel komplexeres Framework, das nicht nur aus einem besteht, aber in mehreren Komponenten, die unterschiedliche Operationen ausführen.
Wir bezeichnen dieses Framework als Hadoop und zusammen mit all seinen Komponenten, Anruf Ecosistema HadoopDas Hadoop-Ökosystem ist ein Open-Source-Framework, das für die Verarbeitung und Speicherung großer Datenmengen entwickelt wurde. Es besteht aus mehreren Schlüsselkomponenten, als Hadoop Distributed File System (HDFS) für die Speicherung und MapReduce für die Verarbeitung. Was ist mehr, enthält ergänzende Tools wie Hive, Schwein und HBase, die das Management erleichtern, Datenanalyse und Abfrage. Dieses Ökosystem ist grundlegend im Bereich Big Data und der.... Aber weil es so viele Komponenten in diesem Hadoop-Ökosystem gibt, Manchmal kann es wirklich schwierig sein, wirklich zu verstehen und sich daran zu erinnern, was jede Komponente tut und wo sie in dieser großen Welt passt.
Dann, In diesem Artikel, Wir werden versuchen, dieses Ökosystem zu verstehen und seine Komponenten aufzuschlüsseln.
Inhaltsverzeichnis
- Problem mit traditionellen Systemen
- Was ist Hadoop??
- Komponenten des Hadoop-Ökosystems
- HDFSHDFS, o Verteiltes Hadoop-Dateisystem, Es ist eine Schlüsselinfrastruktur für die Speicherung großer Datenmengen. Entwickelt für die Ausführung auf gängiger Hardware, HDFS ermöglicht die Datenverteilung über mehrere Knoten, Sicherstellung einer hohen Verfügbarkeit und Fehlertoleranz. Seine Architektur basiert auf einem Master-Slave-Modell, wobei ein Master-Knoten das System verwaltet und Slave-Knoten die Daten speichern, Erleichterung der effizienten Verarbeitung von Informationen.. (Verteiltes DateisystemEin verteiltes Dateisystem (DFS) Ermöglicht die Speicherung und den Zugriff auf Daten auf mehreren Servern, Erleichterung der Verwaltung großer Informationsmengen. Diese Art von System verbessert die Verfügbarkeit und Redundanz, da Dateien an verschiedene Speicherorte repliziert werden, Reduzierung des Risikos von Datenverlusten. Was ist mehr, Ermöglicht Benutzern den Zugriff auf Dateien von verschiedenen Plattformen und Geräten aus, die Zusammenarbeit zu fördern und... Hadoop)
- Kleine Karte
- HILO
- HBaseHBase ist eine NoSQL-Datenbank, die für die Verarbeitung großer Datenmengen entwickelt wurde, die in Clustern verteilt sind. Basierend auf dem Spaltenmodell, Ermöglicht einen schnellen, skalierbaren Zugriff auf Informationen. HBase lässt sich problemlos in Hadoop integrieren, Dies macht es zu einer beliebten Wahl für Anwendungen, die eine massive Datenspeicherung und -verarbeitung erfordern. Seine Flexibilität und Wachstumsfähigkeit machen es ideal für Big-Data-Projekte....
- Schweinefleisch
- Bienenstock
- SqoopSqoop ist ein Open-Source-Tool, das entwickelt wurde, um den Datentransfer zwischen relationalen Datenbanken und dem Hadoop-Ökosystem zu erleichtern. Ermöglicht den Datenimport aus Systemen wie MySQL, PostgreSQL und Oracle zu HDFS, sowie den Export von Daten aus Hadoop in diese Datenbanken. Sqoop optimiert den Prozess durch Parallelisierung von Abläufen, Damit ist es eine effiziente Lösung für die...
- Künstlicher Kanal
- Kafka
- Tierpfleger
- Funke – Funke
- Phasen der Big-Data-Verarbeitung
Problem mit traditionellen Systemen
Durch traditionelle Systeme, Ich meine Systeme wie relationale Datenbanken und Data Warehouses. Organisationen haben sie in der Vergangenheit verwendet 40 Jahre, um Ihre Daten zu speichern und zu analysieren. Die heute anfallenden Daten können jedoch aus folgenden Gründen von diesen Datenbanken nicht verarbeitet werden::
- Die meisten der heute generierten Daten sind halbstrukturiert oder unstrukturiert. Herkömmliche Systeme sind jedoch darauf ausgelegt, nur strukturierte Daten mit gut gestalteten Zeilen und Spalten zu verarbeiten.
- Beziehungsdatenbanken sind vertikal skalierbar, was bedeutet, dass Sie mehr Verarbeitung hinzufügen müssen, Speicher und Speicherung auf demselben System. Das kann sehr teuer werden
- Die heute gespeicherten Daten befinden sich in verschiedenen Silos. Sie zu sammeln und auf Muster zu analysieren kann eine sehr schwierige Aufgabe sein.
Dann, Wie gehen wir mit Big Data um? Hier kommt Hadoop ins Spiel!!
Was ist Hadoop??
Auch die Leute bei Google standen vor den oben genannten Herausforderungen, wenn sie Seiten im Internet ranken wollten.. Sie fanden, dass relationale Datenbanken sehr teuer und unflexibel sind. Dann, hat eine eigene neuartige Lösung gefunden. Sie schufen die Google-Dateisystem (GFS).
GFS ist ein verteiltes Dateisystem, das die Nachteile herkömmlicher Systeme überwindet. Läuft auf kostengünstiger Hardware und bietet Parallelisierung, Skalierbarkeit und Zuverlässigkeit. Dies war das Sprungbrett für die Entwicklung von Apache Hadoop.
Apache Hadoop ist ein Open-Source-Framework, das auf dem Dateisystem von Google basiert und mit Big Data in einer verteilten Umgebung umgehen kann.. Diese verteilte Umgebung besteht aus einer Gruppe von Maschinen, die eng zusammenarbeiten, um den Eindruck einer einzelnen Maschine im Betrieb zu erwecken..
Hier sind einige der wichtigen Hadoop-Eigenschaften, die Sie kennen sollten:
- Hadoop ist hoch skalierbar weil es die Daten verteilt verarbeitet
- Im Vergleich zur vertikalen Skalierung in RDBMS, Hadoop-Angebote horizontale Skala
- Erstellen und speichern Sie dabei Datenreplikate Fehlertoleranz
- Ist wirtschaftlich Da alle Knoten des ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... Es handelt sich um grundlegende Hardware, die nichts anderes als billige Maschinen ist
- Hadoop verwendet die Datenlokalitätskonzept die Daten auf den Knoten zu verarbeiten, auf denen sie gespeichert sind, anstatt die Daten über das Netzwerk zu verschieben, dadurch weniger Verkehr
- Kann Umgang mit jeder Art von Daten: strukturiert, halbstrukturiert und unstrukturiert. Dies ist heute extrem wichtig, da die meisten unserer Daten (E-Mails, Instagram, Twitter, IoT-Geräte, etc.) kein definiertes Format haben.
Jetzt, Schauen wir uns die Komponenten des Hadoop-Ökosystems an.
Komponenten des Hadoop-Ökosystems
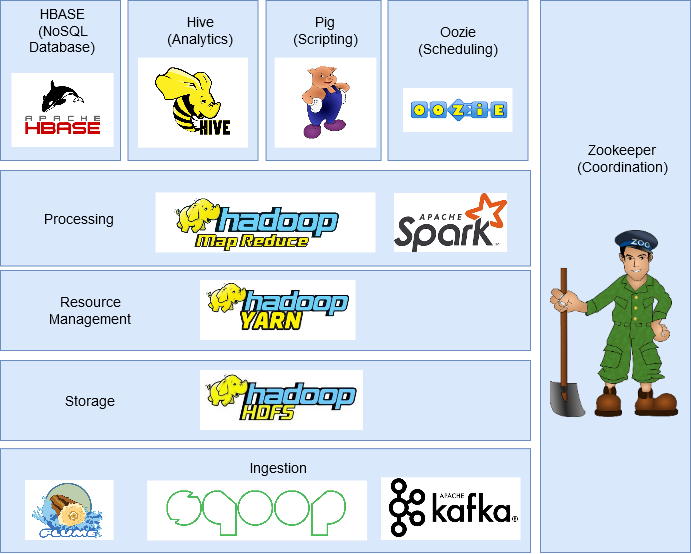
In diesem Abschnitt, Wir werden die verschiedenen Komponenten des Hadoop-Ökosystems diskutieren.
HDFS (Hadoop verteiltes Dateisystem)
Es ist die Speicherkomponente von Hadoop, die Daten in Form von Dateien speichert.
Jede Datei ist in Blöcke von unterteilt 128 MB (konfigurierbar) und speichert sie auf verschiedenen Maschinen im Cluster.
Es hat eine Master-Slave-Architektur mit zwei Hauptkomponenten: KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... Name und Datenknoten.
- Knoten benennen ist der primäre Knoten und es gibt nur einen pro Cluster. Ihre Aufgabe ist es, zu wissen, wo sich jeder Block, der zu einer Datei gehört, im Cluster befindet.
- Datenknoten ist er Slave-KnotenDas "Slave-Knoten" ist ein Konzept, das in Netzwerken und verteilten Systemen verwendet wird und sich auf ein Gerät oder eine Komponente bezieht, die unter der Leitung eines Hauptknotens oder "Master-Knoten". Diese Art von Architektur ermöglicht eine zentralisierte Verwaltung, wobei der Slave-Knoten bestimmte Aufgaben ausführt, Sammeln von Daten oder Ausführen von Prozessen, Während der Master-Knoten systemweite Vorgänge koordiniert, um Leistung und Effizienz zu optimieren.... , in dem die Datenblöcke gespeichert werden, und es gibt mehr als einen pro Cluster. Ihre Aufgabe ist es, die Daten bei Bedarf abzurufen. Bleibt durch Herzschläge in ständigem Kontakt mit dem Namensknoten.
Kleine Karte
Umgang mit Big Data, Hadoop basiert auf Algoritmo MapReduce von Google eingeführt und erleichtert die Verteilung eines Jobs und dessen parallele Ausführung in einem Cluster. Grundsätzlich, teilt eine einzelne Aufgabe in mehrere Aufgaben auf und verarbeitet diese auf verschiedenen Maschinen.
In einfachen Worten, arbeitet nach dem Prinzip des Teilens und Herrschens und führt Prozesse auf Maschinen aus, um den Netzwerkverkehr zu reduzieren.
Es hat zwei wichtige Phasen: Karte und Verkleinern.
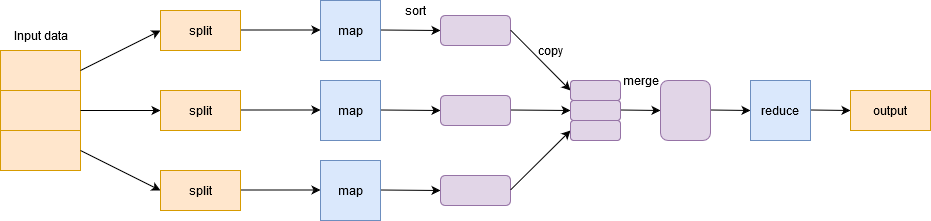
Kartographische Phase Filter, gruppieren und ordnen Sie die Daten. Die Eingabedaten werden in mehrere aufgeteilt Divisionen. Jede Kartenaufgabe arbeitet an einem parallelen Datenausschnitt auf verschiedenen Computern und generiert ein Schlüssel-Wert-Paar. Der Ausgang dieser Phase wird durch den Hausaufgaben reduzieren und ist bekannt als die Phase reduzieren. Daten hinzufügen, fasst das Ergebnis zusammen und speichert es in HDFS.
HILO
GARNYARN ist ein Paketmanager für JavaScript, der die effiziente Installation und Verwaltung von Abhängigkeiten in Entwicklungsprojekten ermöglicht. Unterstützt von Facebook, Es zeichnet sich durch seine Schnelligkeit und Sicherheit im Vergleich zu anderen Managern aus. YARN verwendet ein Cache-System, um Installationen zu optimieren, und stellt eine Sperrdatei bereit, um die Konsistenz der Abhängigkeitsversionen in verschiedenen Entwicklungsumgebungen zu gewährleisten.... o Yet Another Resource Negotiator verwaltet die Ressourcen im Cluster und verwaltet die Anwendungen über Hadoop. Ermöglicht die Verarbeitung und Ausführung von in HDFS gespeicherten Daten durch verschiedene Datenverarbeitungs-Engines, als Stapelverarbeitung, Flow-Verarbeitung, interaktive Verarbeitung, Grafikbearbeitung und vieles mehr. Dies erhöht die Effizienz beim Einsatz von YARN.
HBase
HBase ist ein NoSQL-DatenbankNoSQL-Datenbanken sind Datenmanagementsysteme, die sich durch ihre Flexibilität und Skalierbarkeit auszeichnen. Im Gegensatz zu relationalen Datenbanken, Verwenden Sie unstrukturierte Datenmodelle, als Dokumente, Schlüssel/Wert-Paar oder Grafiken. Sie sind ideal für Anwendungen, die den Umgang mit großen Informationsmengen und eine hohe Verfügbarkeit erfordern, wie z. B. bei sozialen Netzwerken oder Cloud-Diensten. Seine Popularität ist gewachsen in... spaltenbasiert. Es läuft auf HDFS und kann jede Art von Daten verarbeiten. Ermöglicht Echtzeitverarbeitung und Lesevorgänge / zufällige Schreibvorgänge auf den Daten.
Schweinefleisch
SchweinDas Schwein, ein domestiziertes Säugetier aus der Familie der Suidae, Es ist bekannt für seine Vielseitigkeit in der Landwirtschaft und Lebensmittelproduktion. In Asien beheimatet, Seine Züchtung hat sich über die ganze Welt verbreitet. Schweine sind Allesfresser und haben eine hohe Anpassungsfähigkeit an verschiedene Lebensräume. Was ist mehr, spielen eine wichtige Rolle in der Wirtschaft, Bereitstellung von Fleisch, Leder und andere abgeleitete Produkte. Ihre Intelligenz und ihr Sozialverhalten sind auch ... Es wurde entwickelt, um große Datensätze zu analysieren und die Schwierigkeit des Schreibens von Karten und der Reduzierung von Funktionen zu überwinden. Es besteht aus den Komponenten: Pig Latin y Pig Engine.
Pig Latin ist eine SQL-ähnliche Skriptsprache. Pig Engine ist die Laufzeit, auf der Pig Latin läuft. Im Inneren, Code, der in Pig geschrieben wurde, wird in Karte verkleinernMapReduce ist ein Programmiermodell, das entwickelt wurde, um große Datensätze effizient zu verarbeiten und zu generieren. Unterstützt von Google, Bei diesem Ansatz wird die Arbeit in kleinere Aufgaben aufgeteilt, die auf mehrere Knoten in einem Cluster verteilt sind. Jeder Knoten verarbeitet seinen Teil und dann werden die Ergebnisse kombiniert. Mit dieser Methode können Sie Anwendungen skalieren und große Informationsmengen verarbeiten, in der Welt von Big Data von grundlegender Bedeutung zu sein.... und macht es Programmierern, die Java nicht fließend beherrschen, sehr einfach.
Bienenstock
BienenstockHive ist eine dezentrale Social-Media-Plattform, die es ihren Nutzern ermöglicht, Inhalte zu teilen und sich mit anderen zu verbinden, ohne dass eine zentrale Behörde eingreifen muss. Verwendet die Blockchain-Technologie, um die Datensicherheit und das Eigentum zu gewährleisten. Im Gegensatz zu anderen sozialen Netzwerken, Hive ermöglicht es Nutzern, ihre Inhalte durch Krypto-Belohnungen zu monetarisieren, die die Schaffung und den aktiven Austausch von Informationen fördert.... ist ein verteiltes Datenspeichersystem, das von Facebook entwickelt wurde. Ermöglicht einfaches Lesen, Schreiben und Verwalten von Dateien in HDFS. Es verfügt über eine eigene Abfragesprache für den als Hive Querying Language bekannten Zweck (HQL), was SQL sehr ähnlich ist. Dies macht es für Programmierer sehr einfach, MapReduce-Funktionen mit einfachen HQL-Abfragen zu schreiben..
Sqoop
Viele Anwendungen speichern Daten immer noch in relationalen Datenbanken, was sie zu einem DatenquelleEIN "Datenquelle" bezieht sich auf jeden Ort oder jedes Medium, an dem Informationen erhalten werden können. Diese Quellen können sowohl primär als auch, wie z.B. Erhebungen und Experimente, als sekundär, als Datenbanken, Wissenschaftliche Artikel oder statistische Berichte. Die richtige Wahl einer Datenquelle ist entscheidend, um die Gültigkeit und Zuverlässigkeit von Informationen in Forschung und Analyse zu gewährleisten.... sehr wichtig. Deswegen, Sqoop spielt eine wichtige Rolle bei der Übertragung von Daten aus relationalen Datenbanken in HDFS.
In Sqoop geschriebene Befehle werden intern in MapReduce-Aufgaben umgewandelt, die in HDFS ausgeführt werden. Funktioniert mit fast allen relationalen Datenbanken wie MySQL, Postgres, SQLite, etc. Kann auch verwendet werden, um Daten von HDFS nach RDBMS zu exportieren.
Künstlicher Kanal
GerinneFlume ist eine Open-Source-Software, die für die Datenerfassung und den Datentransport entwickelt wurde. Verwenden Sie einen flussbasierten Ansatz, Ermöglicht das Verschieben von Daten aus verschiedenen Quellen auf Speichersysteme wie Hadoop. Seine modulare und skalierbare Architektur erleichtert die Integration mit mehreren Datenquellen, Das macht es zu einem wertvollen Werkzeug für die Verarbeitung und Analyse großer Informationsmengen in Echtzeit.... ist ein Open-Source-Dienst, zuverlässig und verfügbar, das zum Sammeln verwendet wird, Effizientes Hinzufügen und Verschieben großer Datenmengen aus mehreren Datenquellen zu HDFS. Kann Daten in Echtzeit und im Batch-Modus sammeln. Hat eine flexible Architektur und ist fehlertolerant mit mehreren Wiederherstellungsmechanismen.
Kafka
Es gibt viele Anwendungen, die Daten generieren, und eine proportionale Anzahl von Anwendungen, die diese Daten verbrauchen. Aber sie einzeln zu verbinden ist eine schwierige Aufgabe. Hier kommt Kafka ins Spiel. Es gehört zu den Anwendungen, die Daten generieren (Hersteller) und Anwendungen, die Daten verbrauchen (Verbraucher).
Kafka wird verteilt und partitioniert, ReplikationReplikation ist ein grundlegender Prozess in Biologie und Wissenschaft, was sich auf die Duplikation von Molekülen bezieht, Zellen oder genetische Informationen. Im Kontext der DNA, Die Replikation sorgt dafür, dass jede Tochterzelle während der Zellteilung eine vollständige Kopie des Erbguts erhält. Dieser Mechanismus ist entscheidend für das Wachstum, Entwicklung und Pflege der Organismen, sowie für die Weitergabe von Erbeigenschaften an zukünftige Generationen.... und integrierte Fehlertoleranz. Es kann Streaming-Daten verarbeiten und ermöglicht es Unternehmen auch, Daten in Echtzeit zu analysieren.
Oozie
OozieOozie ist ein datenstromorientiertes Job-Management-System, Entwickelt für die Koordination von Aufträgen in Hadoop. Ermöglicht es Benutzern, komplexe Aufträge zu definieren und zu planen, MapReduce-Aufgaben einbinden, Schwein, Hive und andere. Oozie verwendet einen XML-basierten Ansatz, um Workflows und deren Ausführung zu beschreiben, Erleichterung der Prozessorchestrierung in Big-Data-Umgebungen. Seine Funktionalität verbessert die Verarbeitungseffizienz.. ist ein Workflow-Planungssystem, das es Benutzern ermöglicht, Aufträge zu verknüpfen, die auf verschiedenen Plattformen wie MapReduce geschrieben wurden, Bienenstock, Schwein, etc. Mit Oozie können Sie einen Job im Voraus planen und eine Pipeline einzelner Jobs erstellen, die nacheinander oder parallel ausgeführt werden, um eine größere Aufgabe zu erledigen.. Zum Beispiel, Sie können Oozie verwenden, um ETL-Operationen an Daten durchzuführen und die Ausgabe dann in HDFS zu speichern.
Tierpfleger
In einem Hadoop-Cluster, Das Koordinieren und Synchronisieren von Knoten kann eine herausfordernde Aufgabe sein. Deswegen, Tierpfleger"Tierpfleger" ist ein Simulationsvideospiel, das im 2001, in der die Spieler in die Rolle eines Zoowärters schlüpfen. Die Hauptaufgabe besteht darin, verschiedene Tierarten zu verwalten und zu pflegen, Sicherstellung Ihres Wohlbefindens und der Zufriedenheit der Besucher. Während des gesamten Spiels, Benutzer können ihren Zoo entwerfen und anpassen, Herausforderungen wie, den Lebensraum und die Gesundheit von Tieren.... Es ist das perfekte Werkzeug, um das Problem zu lösen.
Es ist ein Open-Source-Dienst, verteilt und zentralisiert, um Konfigurationsinformationen zu verwalten, benennen, Bereitstellung verteilter Synchronisation und Bereitstellung von Gruppendiensten im gesamten Cluster.
Funke – Funke
Spark ist ein alternatives Framework zu Hadoop in Scala, unterstützt aber verschiedene in Java geschriebene Anwendungen, Python, etc. Im Vergleich zu MapReduce, bietet In-Memory-Verarbeitung, die eine schnellere Verarbeitung darstellt. Zusätzlich zur Stapelverarbeitung von Hadoop, kann auch Echtzeitverarbeitung verarbeiten.
Was ist mehr, Spark hat sein eigenes Ökosystem:
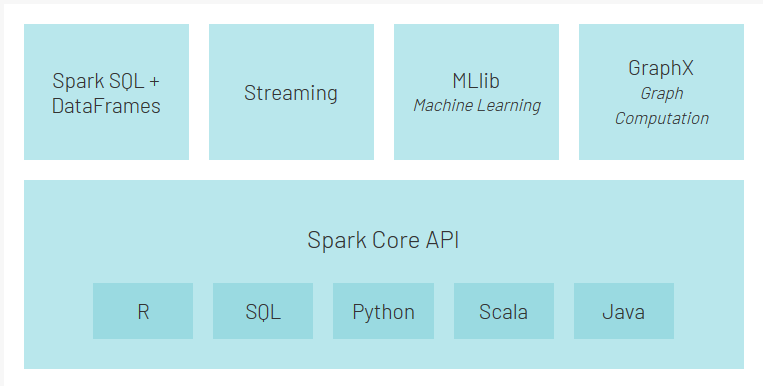
- Funkenkern ist die Hauptlaufzeit für Spark und andere darauf aufbauende APIs
- API von Spark SQL ermöglicht das Abfragen strukturierter Daten, die in DataFrames oder Hive-Tabellen gespeichert sind
- Streaming-API ermöglicht Spark, Daten in Echtzeit zu verarbeiten. Es kann problemlos in eine Vielzahl von Datenquellen wie Flume integriert werden, Kafka und Twitter.
- MLlib ist eine skalierbare Bibliothek für maschinelles Lernen, mit der Sie Data-Science-Aufgaben ausführen und gleichzeitig die Spark-Eigenschaften nutzen können
- GraphX ist eine Grafikberechnungs-Engine, mit der Benutzer erstellen können, strukturierte Daten interaktiv in skalierte Grafiken umwandeln und argumentieren und wird mit einer Bibliothek gängiger Algorithmen geliefert
Phasen der Big-Data-Verarbeitung
Mit so vielen Komponenten innerhalb des Hadoop-Ökosystems, kann ziemlich einschüchternd und schwer zu verstehen sein, was die einzelnen Komponenten bewirken. Deswegen, Es ist einfacher, einige der Komponenten basierend auf ihrer Position in der Big-Data-Verarbeitungsphase zu gruppieren.
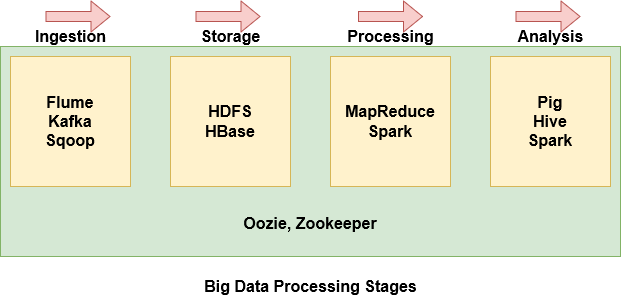
- Gerinne, Kafka und Sqoop werden verwendet, um Daten aus externen Quellen in HDFS aufzunehmen
- HDFS ist das Speicherlaufwerk von Hadoop. Sogar importierte Daten von Hbase werden in HDFS gespeichert
- MapReduce und Spark werden verwendet, um die Daten in HDFS zu verarbeiten und verschiedene Aufgaben auszuführen
- Schwein, Hive und Spark werden verwendet, um die Daten zu analysieren.
- Oozie hilft bei der Planung von Aufgaben. Da es mit verschiedenen Plattformen funktioniert, in allen Phasen verwendet.
- Zookeeper synchronisiert die Cluster-Knoten und wird auch in allen Phasen verwendet.
Abschließende Anmerkungen
Ich hoffe, dieser Artikel war hilfreich, um Big Data zu verstehen, warum herkömmliche Systeme damit nicht umgehen können und was die wichtigen Komponenten des Hadoop-Ökosystems sind.
Ich ermutige Sie, einige weitere Artikel zu Big Data zu lesen, die Ihnen möglicherweise hilfreich sind:





