
Überblick
- SQL ist eine unverzichtbare Sprache für jeden in der Datenwissenschaft oder Analytik.
- Hier gibt es 8 ingeniosas técnicas de SQL para el análisis de datos con las que los profesionales de la AnalyseAnalytics bezieht sich auf den Prozess des Sammelns, Messen und analysieren Sie Daten, um wertvolle Erkenntnisse zu gewinnen, die die Entscheidungsfindung erleichtern. In verschiedenen Bereichen, wie Business, Gesundheit und Sport, Analysen können Muster und Trends erkennen, Prozesse optimieren und Ergebnisse verbessern. Der Einsatz fortschrittlicher Werkzeuge und statistischer Techniken ist unerlässlich, um Daten in anwendbares und strategisches Wissen umzuwandeln.... y la ciencia de datos adorarán trabajar
Einführung
SQL ist ein Schlüsselelement im Arsenal eines Data-Science-Profis. ich spreche aus erfahrung: Sie können einfach nicht hoffen, eine erfolgreiche Karriere in Data Science oder Analytics aufzubauen, wenn Sie noch nicht SQL gelernt haben.
Und warum ist SQL so wichtig?
Auf dem Weg in ein neues Jahrzehnt, Die Geschwindigkeit, mit der wir Daten produzieren und verbrauchen, steigt von Tag zu Tag in die Höhe. Um intelligente datengesteuerte Entscheidungen zu treffen, Unternehmen auf der ganzen Welt stellen Datenexperten wie Business-Analysten und Datenwissenschaftler ein, um Erkenntnisse aus dem riesigen Datenschatz zu gewinnen und zu gewinnen.
Und eines der wichtigsten Werkzeuge dafür ist, Ich schätze es, SQL!
Die strukturierte Abfragesprache (SQL) gibt es schon seit Jahrzehnten. Es ist eine Programmiersprache, die verwendet wird, um Daten zu verwalten, die in relationalen Datenbanken gespeichert sind. SQL wird von den meisten großen Unternehmen weltweit verwendet. Ein Datenanalyst kann SQL verwenden, um auf, lesen, manipular y analizar los datos almacenados en una DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... y generar información útil para impulsar un proceso de toma de decisiones informado.
In diesem Artikel, Ich werde diskutieren 8 Techniken / SQL-Abfragen, die Sie auf alle fortgeschrittenen Datenanalyseprobleme vorbereiten. Bitte beachten Sie, dass dieser Artikel ein sehr grundlegendes Verständnis von SQL voraussetzt.
Ich würde vorschlagen, die folgenden Kurse zu besuchen, wenn Sie neu in SQL sind und / oder Geschäftsanalyse:
Inhaltsverzeichnis
- Lassen Sie uns zuerst den Datensatz verstehen
- SQL-Technik n. ° 1: Zeilen und Elemente zählen
- SQL-Technik n. ° 2: Aggregationsfunktionen
- SQL-Technik # 3: Identifikation von Extremwerten
- SQL-Technik n. ° 4: Datenschnitt
- SQL-Technik n. ° 5: Datenbeschränkung
- SQL-Technik n. ° 6: Datenklassifizierung
- SQL-Technik n. ° 7: Filtermuster
- SQL-Technik n. ° 8: Cluster, Datensammlung und -filterung in Gruppen
Lassen Sie uns zuerst den Datensatz verstehen
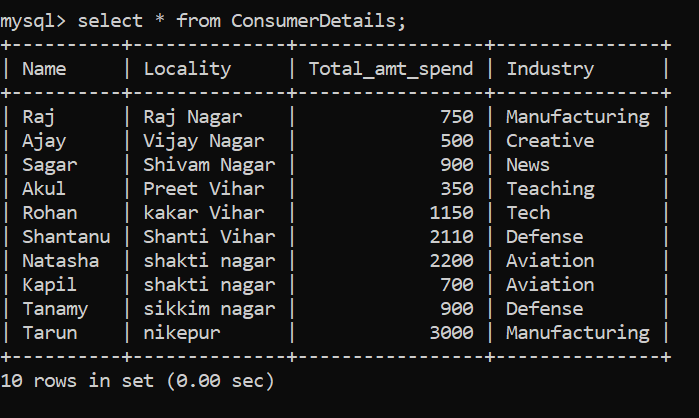
Wie lernt man am besten, Daten zu analysieren?? Tun Sie es Seite an Seite an einem Datensatz!! Für diesen Zweck, Ich habe einen Dummy-Datensatz eines Einzelhandelsgeschäfts erstellt. Die Kundendatentabelle wird dargestellt durch VerbraucherDetails.
Unser Datensatz besteht aus den folgenden Spalten:
- Name – Der Name des Verbrauchers
- Standort – Der Standort des Kunden
- Total_amt_spend – Der Gesamtbetrag, den der Verbraucher im Geschäft ausgegeben hat.
- Industrie – Es bedeutet die Branche, zu der der Verbraucher gehört
Notiz: – Ich werde MySQL verwenden 5.7 im Artikel vorankommen. Sie können es hier herunterladen – Descargas von My SQL 5.7.
SQL-Technik n. ° 1: Zeilen- und Artikelanzahl
Wir beginnen unsere Analyse mit der einfachsten Abfrage, nämlich, Zählen der Zeilen in unserer Tabelle. Wir machen das mit der Funktion – ZÄHLEN ().
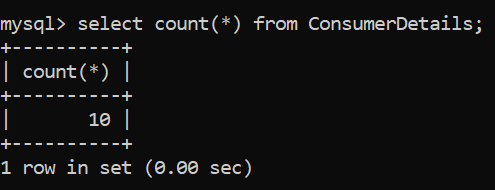
Exzellent! Jetzt kennen wir die Anzahl der Zeilen in unserer Tabelle, Was ist es 10. Es mag Spaß machen, diese Funktion für einen kleinen Satz von Testdaten zu verwenden, Aber es kann einen langen Weg gehen, wenn Ihre Ränge in die Millionen gehen!!
Viele Male, unsere Datentabelle ist voller doppelter Werte. Um den einzigartigen Wert zu erreichen, usamos la función UNTERSCHEIDBARDas Wort "UNTERSCHEIDBAR" im Englischen wird es ins Spanische übersetzt als "unterschiedlich" Ö "Verschieden". Im Bereich Programmierung und Datenbanken, insbesondere in SQL, Wird verwendet, um Duplikate in Abfrageergebnissen zu entfernen. Beim Anwenden der DISTINCT-Klausel, Es werden nur die eindeutigen Werte eines Datensatzes abgerufen, die die Analyse und Darstellung relevanter und nicht redundanter Informationen erleichtert.....
In unserem Datensatz, Wie können wir die einzigartigen Branchen finden, zu denen Kunden gehören??
Du hast es richtig erraten. Wir können dies mit der DISTINCT-Funktion tun.
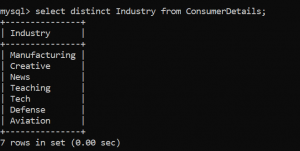
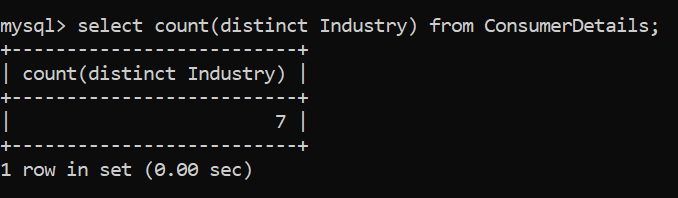
Sie können sogar die Anzahl der eindeutigen Zeilen zählen, indem Sie das Zählen in Verbindung mit verschiedenen verwenden. Sie können sich auf die folgende Abfrage beziehen:
SQL-Technik # 2 – Aggregationsfunktionen
Aggregationsfunktionen sind die Grundlage jeder Art von Datenanalyse. Sie geben uns einen Überblick über den Datensatz. Einige der Funktionen, die wir besprechen werden, sind: SUMME (), AVG () und STDDEV ().
Wir nehmen das SUMME() Funktion zum Berechnen der Summe der numerischen Spalte in einer Tabelle.
Lassen Sie uns die Summe der von jedem Kunden ausgegebenen Beträge herausfinden:
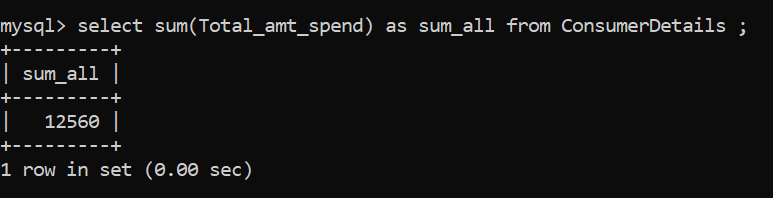
Im obigen Beispiel, sum_all ist der VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... en la que se almacena el valor de la suma. Die Summe des von den Verbrauchern ausgegebenen Geldbetrags beträgt Rs. 12.560.
So berechnen Sie den Durchschnitt numerischer Spalten, wir nehmen das AVG () Funktion. Lassen Sie uns die durchschnittlichen Verbraucherausgaben für unser Einzelhandelsgeschäft ermitteln:
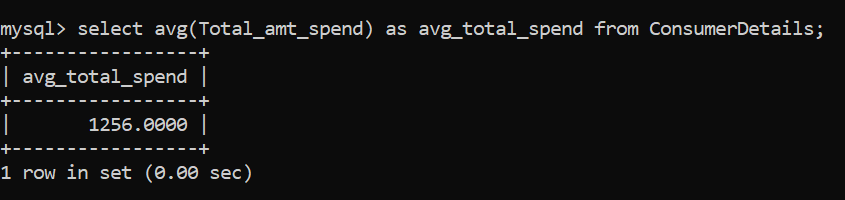
Der durchschnittliche Betrag, den Kunden im Einzelhandelsgeschäft ausgeben, beträgt Rs. 1256.
-
Berechnen Sie die Standardabweichung
Wenn Sie sich den Datensatz und dann den Durchschnittswert der Verbraucherausgaben angesehen haben, Sie werden bemerkt haben, dass etwas fehlt. Durchschnitt liefert kein vollständiges Bild, Suchen wir also nach einer anderen wichtigen Metrik: die Standardabweichung. Die Funktion ist STDDEV ().
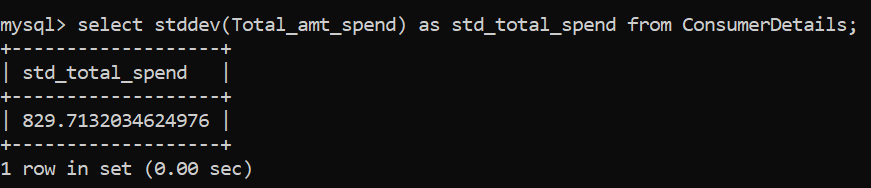
Die Standardabweichung ergibt sich zu 829,7, was bedeutet, dass es eine große Diskrepanz zwischen den Konsumausgaben gibt.
SQL-Technik # 3 – Identifikation von Extremwerten
Die nächste Art der Analyse besteht darin, Extremwerte zu identifizieren, die Ihnen helfen, die Daten besser zu verstehen..
Der maximale Zahlenwert kann durch die MAX-Funktion ermittelt werden (). Mal sehen, wie man es anwendet:
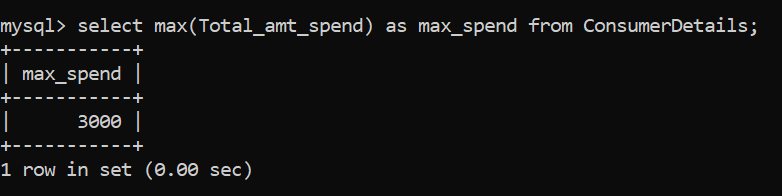
Der maximale Geldbetrag, den der Verbraucher im Einzelhandel ausgibt, beträgt Rs. 3000.
Ähnlich der Max-Funktion, wir haben die MIN-Funktion () um den minimalen numerischen Wert in einer bestimmten Spalte zu identifizieren:
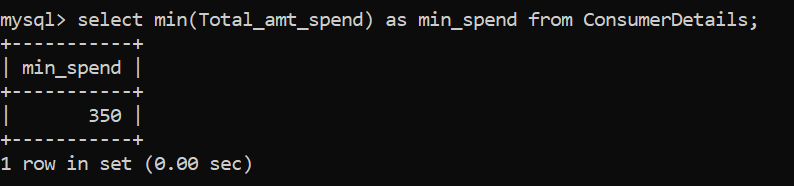
Der Mindestbetrag, der vom Verbraucher im Einzelhandelsgeschäft ausgegeben wird, beträgt Rs. 350.
SQL-Technik n. ° 4: Datenschnitt
Jetzt, Konzentrieren wir uns auf einen der wichtigsten Teile der Datenanalyse: Teile die Daten. Dieser Abschnitt der Analyse bildet die Grundlage für erweiterte Abfragen und hilft Ihnen, Daten basierend auf einer bestimmten Bedingung abzurufen.
- Nehmen wir an, das Einzelhandelsgeschäft möchte Kunden finden, die aus einem Ort stammen, speziell Shakti Nagar und Shanti Vihar. Was wird die Abfrage dafür sein??
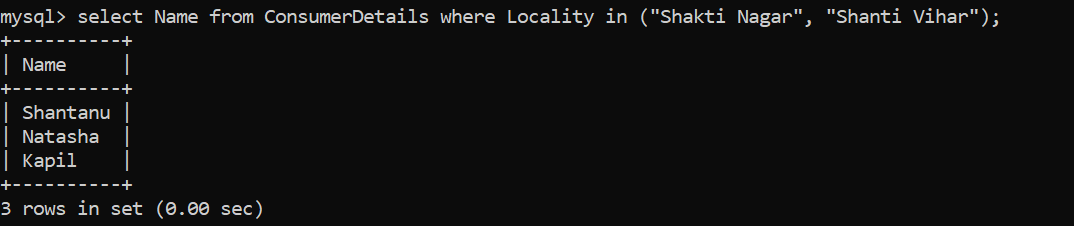
¡Genial, haben 3 Kunden! Hemos utilizado la cláusula WO"WO" ist ein Begriff im Deutschen, der übersetzt wird als "wo" in Spanisch. Wird verwendet, um Fragen über den Standort von Personen zu stellen, Objekte oder Ereignisse. In grammatikalischen Zusammenhängen, Es kann als Adverb des Ortes fungieren und ist grundlegend für die Bildung von Fragen. Die korrekte Anwendung ist in der alltäglichen Kommunikation und im Sprachunterricht unerlässlich, Erleichterung des Verständnisses und des Austauschs von Informationen über Positionen und Richtungen.... para filtrar los datos en función de la condición de que los consumidores deberían vivir en la localidad: Shakti Nagar und Shanti Vihar. Ich habe hier nicht die ODER-Bedingung verwendet. Stattdessen, Ich habe den IN-Operator verwendet, mit dem wir mehrere Werte in der WHERE-Klausel angeben können.
- Wir müssen Kunden finden, die an bestimmten Orten leben (Shakti Nagar und Shanti Vihar) und einen Betrag von mehr als Rs . ausgeben. 2000.
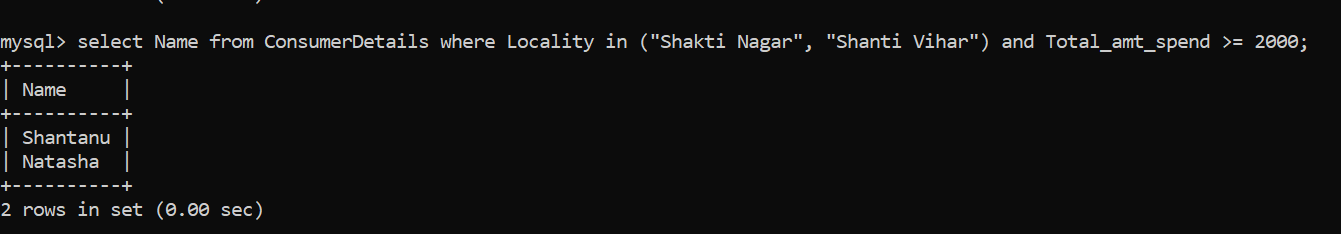
In unserem Datensatz, nur Shantanu und Natasha erfüllen diese Bedingungen. Wie beide Bedingungen erfüllt sein müssen, die UND-Bedingung ist hier am besten geeignet. Sehen wir uns ein weiteres Beispiel an, um unsere Daten aufzuteilen.
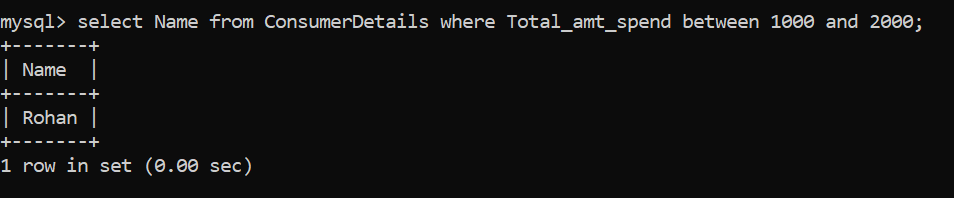
- Diesmal, Das Einzelhandelsgeschäft möchte alle Verbraucher zurückgewinnen, die zwischen Rs . ausgeben. 1000 y Rs. 2000 um spezielle Marketingangebote zu fördern. Was wird die Abfrage dafür sein??
Eine andere Möglichkeit, dieselbe Aussage zu schreiben, wäre:
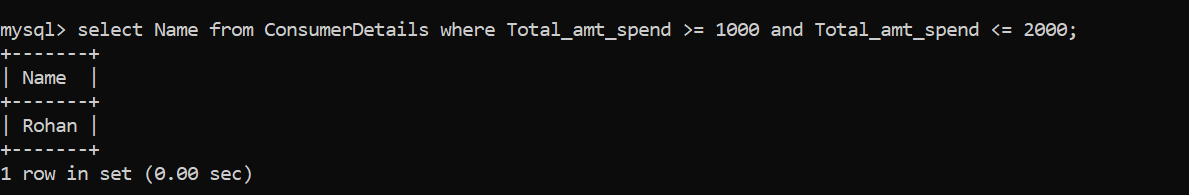
Nur Rohan klärt dieses Kriterium!!
Exzellent! Wir haben die Mitte unserer Reise erreicht. Lasst uns mehr auf dem bisher gewonnenen Wissen aufbauen.
SQL-Technik n. ° 5: Datenbeschränkung
Nehmen wir an, wir möchten die Datentabelle sehen, die aus Millionen von Datensätzen besteht. No podemos usar la instrucción AUSWÄHLENDer Befehl "AUSWÄHLEN" ist in SQL von grundlegender Bedeutung, Wird zum Abfragen und Abrufen von Daten aus einer Datenbank verwendet. Ermöglicht das Angeben von Spalten und Tabellen, Filtern von Ergebnissen mithilfe von Klauseln wie "WO" und Bestellung mit "SORTIEREN NACH". Seine Vielseitigkeit macht es zu einem unverzichtbaren Werkzeug für die Datenmanipulation und -analyse, Erleichterung der effizienten Beschaffung spezifischer Informationen.... directamente ya que esto volcaría la tabla completa en nuestra pantalla, das ist umständlich und rechenintensiv. Stattdessen, wir können das gebrauchen GRENZE Klausel:
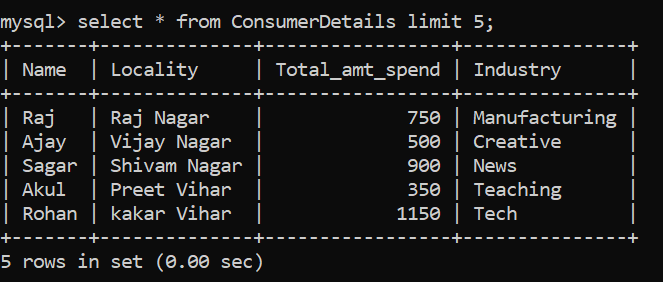
Der obige SQL-Befehl hilft uns, die erste zu zeigen 5 Tabellenzeilen.
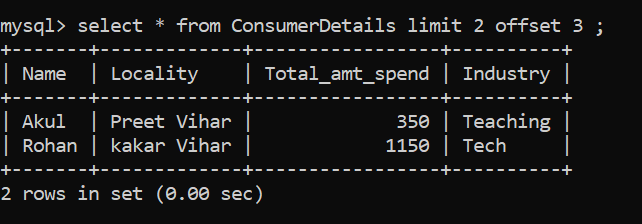
Was tun Sie, wenn Sie nur die vierte und fünfte Reihe auswählen möchten?? Wir verwenden die OFFSET-Klausel. Die OFFSET-Klausel überspringt die angegebene Anzahl von Zeilen. Mal sehen wie es funktioniert:
SQL-Technik n. ° 6: Datenklassifizierung
Das Sortieren von Daten hilft uns, unsere Daten ins rechte Licht zu rücken. Wir können den Klassifizierungsprozess mit dem Schlüsselwort . durchführen – SORTIEREN NACHDer Befehl "SORTIEREN NACH" In SQL wird es verwendet, um die Ergebnisse einer Abfrage basierend auf einer oder mehreren Spalten zu sortieren. Ermöglicht das Festlegen der aufsteigenden Reihenfolge (ASC) oder absteigend (DESC) der Daten, Erleichterung der Visualisierung und Analyse von Informationen. Es ist ein unverzichtbares Werkzeug für die Organisation von Daten in Datenbanken, Verbesserung des Verständnisses und des Zugangs zu relevanten Informationen.....
Das Schlüsselwort kann verwendet werden, um die Daten in aufsteigender oder absteigender Reihenfolge zu sortieren. Das Schlüsselwort ORDER BY sortiert die Daten standardmäßig in aufsteigender Reihenfolge.
Sehen wir uns ein Beispiel an, in dem wir die Daten nach der Spalte Total_amt_spend in aufsteigender Reihenfolge sortieren:
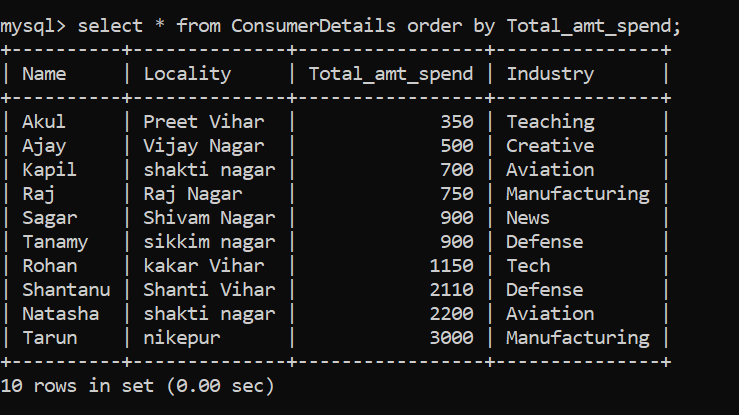
Beeindruckend! So sortieren Sie den Datensatz in absteigender Reihenfolge, wir können dem folgenden Befehl folgen:
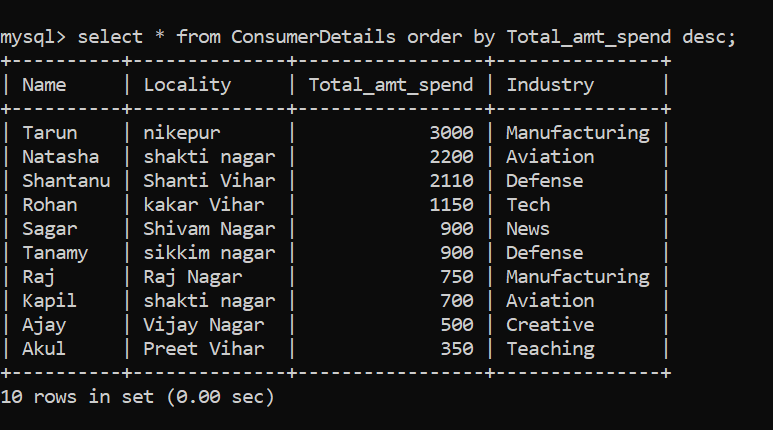
SQL-Technik # 7 – Filtermuster
In den vorherigen Abschnitten, Wir haben gelernt, wie man Daten basierend auf einer oder mehreren Bedingungen filtert. Hier, wir lernen, wie man die Spalten filtert, die einem bestimmten Muster entsprechen. Um damit weiterzumachen, Zuerst werden wir den LIKE-Operator und die Platzhalterzeichen verstehen.
Der LIKE-Operator wird in einer WHERE-Klausel verwendet, um ein bestimmtes Muster in einer Spalte zu finden.
Das Platzhalterzeichen wird verwendet, um ein oder mehrere Zeichen in einer Zeichenfolge zu ersetzen. Diese werden in Verbindung mit dem LIKE-Operator verwendet. Die beiden häufigsten Platzhalterzeichen sind:
-
- %: Es repräsentiert 0 oder mehr Zeichen
- _ – Stellt ein einzelnes Zeichen dar
In unserem fiktiven Einzelhandelsdatensatz, sagen wir, wir wollen alle Orte, die mit "Nagar" enden. Nehmen Sie sich einen Moment Zeit, um die Problemstellung zu verstehen und überlegen Sie, wie wir sie lösen können.
Versuchen wir das Problem zu lösen. Wir benötigen alle Orte, die mit enden „Nagar“ und sie können eine beliebige Anzahl von Zeichen vor dieser bestimmten Zeichenfolge haben. Deswegen, wir können die Wildcard nutzen „%“ Vor „Nagar“:
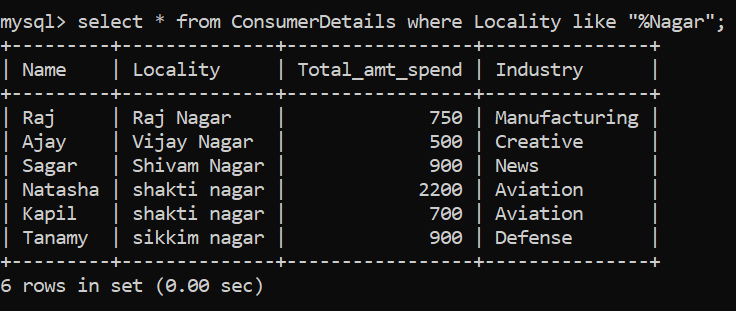
Beeindruckend, haben 6 Orte die auf diesen Namen enden. Beachten Sie, dass wir den LIKE-Operator verwenden, um einen Mustervergleich durchzuführen.
Dann, Wir werden versuchen, ein weiteres Problem anhand von Mustern zu lösen. Wir wollen die Namen von Verbrauchern, deren zweites Zeichen hat „ein“ in ihren jeweiligen Namen. Nochmal, Ich schlage vor, Sie nehmen sich einen Moment Zeit, um das Problem zu verstehen und sich eine Logik zu überlegen, um es zu lösen.
Lass uns das Problem analysieren. Hier, das zweite Zeichen muss sein „ein“. Das erste Zeichen kann alles sein, Also ersetzen wir diesen Buchstaben durch den Platzhalter "_". Nach dem zweiten Zeichen, es kann eine beliebige Anzahl von Zeichen geben, Also ersetzen wir diese Zeichen durch den Platzhalter „%“. Die endgültige Musterübereinstimmung wird so aussehen:
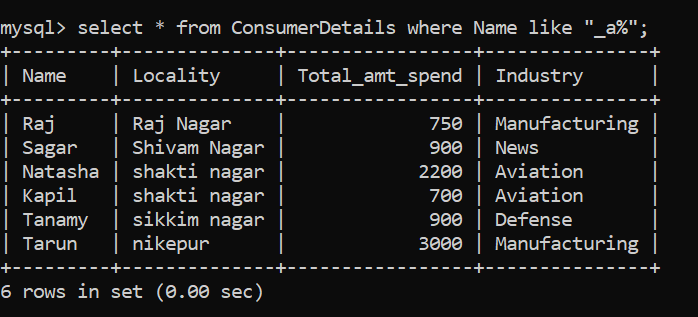
Verfügen über 6 Menschen, die diese seltsame Bedingung erfüllen!
SQL-Technik n. ° 8: Cluster, Datensammlung und -filterung in Gruppen
Endlich sind wir bei einem der mächtigsten Analysetools in SQL angekommen: la agrupación de datos que se realiza utilizando la instrucción GRUPPIEREN NACHDie Klausel "GRUPPIEREN NACH" In SQL wird es verwendet, um Zeilen, die Werte teilen, in bestimmte Spalten zu gruppieren. Auf diese Weise können Aggregationsfunktionen ausgeführt werden, als SUM, COUNT oder AVG, Informationen zu den resultierenden Gruppen. Seine Verwendung ist unerlässlich, um Daten zu analysieren und statistische Zusammenfassungen zu erhalten. Es ist wichtig zu beachten, dass alle markierten Spalten, die nicht Teil einer Aggregationsfunktion sind, in die "GRUPPIEREN NACH"..... Die nützlichste Anwendung dieser Aussage besteht darin, die Verteilung kategorialer Variablen zu finden. Dies geschieht mit der GROUP BY-Anweisung in Verbindung mit Aggregationsfunktionen wie – ZÄHLEN, SUMME, AVG, etc.
Versuchen wir, dies besser zu verstehen, indem wir eine Erklärung des Problems machen. Das Einzelhandelsgeschäft möchte die Anzahl der Kunden ermitteln, die der Branche entspricht, zu der es gehört:
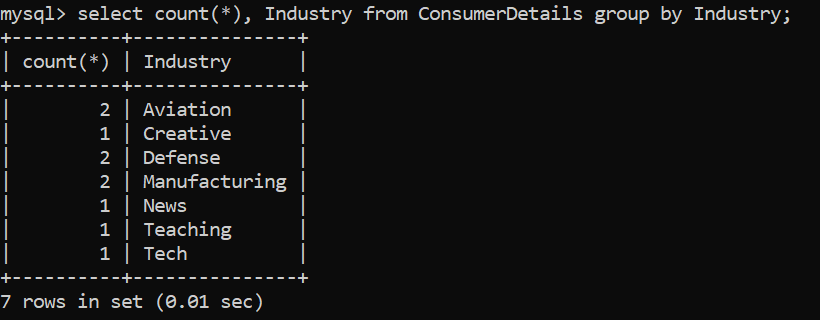
Wir beobachten, dass die Anzahl der Kunden aus den verschiedenen Branchen mehr oder weniger gleich ist. Dann, Lassen Sie uns die Summe der Ausgaben der Kunden nach Branche gruppieren, zu der sie gehören:
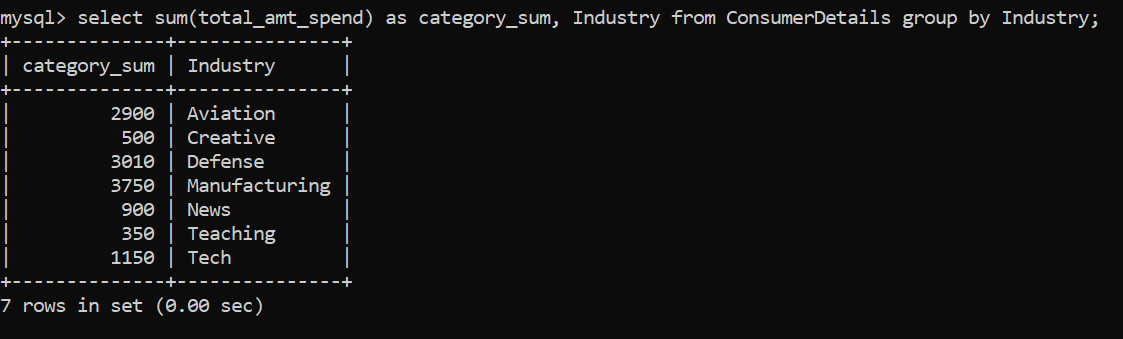
Wir können sehen, dass der maximale Geldbetrag von Kunden ausgegeben wird, die zu den . gehören Herstellung Industrie. Das scheint ein bisschen einfach zu sein, Wahrheit? Lasst uns einen Schritt nach vorne machen und es komplizierter machen.
Jetzt, der Einzelhändler möchte die Branchen finden, deren Gesamtsumme ist größer als 2500. Um dieses Problem zu lösen, volveremos a agrupar los datos según la industria y luego usaremos la cláusula HABENDas Verb "haben" Im Spanischen ist es ein Grundhilfsmittel, das zur Bildung von zusammengesetzten Zeitformen verwendet wird. Seine Konjugation variiert je nach Zeit und Subjekt, Sein "Ich", "Du", "hat", "wir haben", "Du" Ja "haben" Die Formen der Gegenwart. Was ist mehr, in einigen Regionen, Gebraucht "haben" als unpersönliches Verb, um Existenz anzuzeigen, wie in "Es gibt" zu "Es gibt/gibt". Die korrekte Anwendung ist für eine effektive Kommunikation auf Spanisch unerlässlich.....
Die HAVING-Klausel ist wie die WHERE-Klausel, aber nur zum Filtern gruppierter Daten. Erinnern, kommt immer nach der GROUP BY-Anweisung.
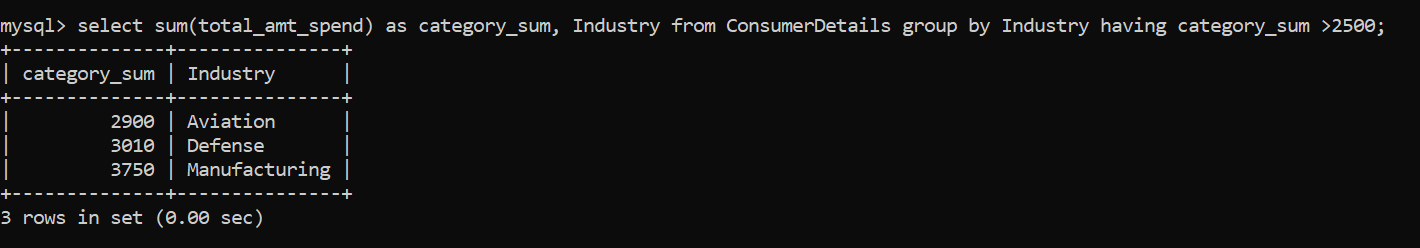
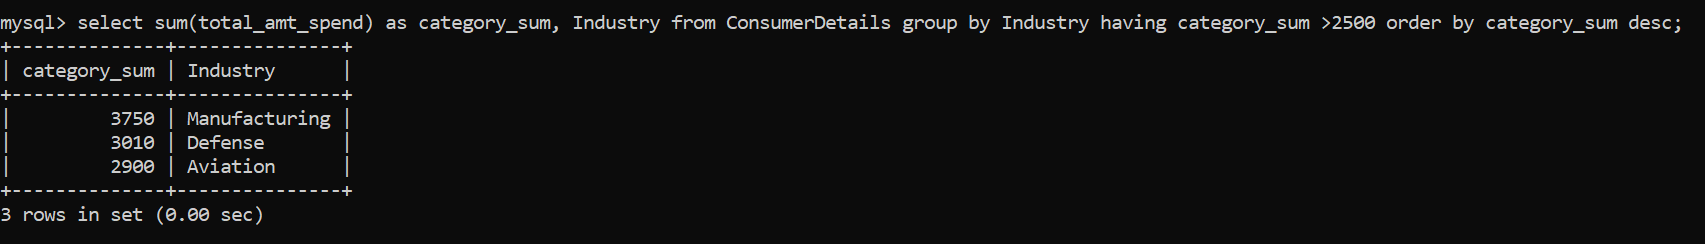
Wir haben nur 3 Kategorien, die die Bedingungen erfüllen: Luftfahrt, Verteidigen, Ja Herstellung. Aber um es klarer zu machen, Ich werde auch das Schlüsselwort ORDER BY hinzufügen, um es intuitiver zu machen:
Abschließende Anmerkungen
Ich freue mich, dass du es bis hierher geschafft hast. Dies sind die Bausteine aller Datenanalyseabfragen in SQL. Mit diesen Grundlagen können Sie auch erweiterte Abfragen durchführen. In diesem Artikel, ich habe mysql benutzt 5.7 um die Beispiele zu setzen.
Ich hoffe wirklich, dass diese SQL-Abfragen Ihnen bei der täglichen Analyse komplexer Daten helfen. Haben Sie einen Ihrer Tipps und Tricks zum Analysieren von Daten in SQL? Lass es mich in den Kommentaren wissen!!





