
Cet article a été publié dans le cadre de la Blogathon sur la science des données
introduction
pour mieux comprendre vos données, qui aide à un prétraitement ultérieur des données. Et la visualisation des données est la clé, car il rationalise la procédure d'analyse exploratoire des données et analyse les données facilement grâce à de magnifiques tableaux et graphiques.
Table des matières
- Visualisation de données
- L'analyse exploratoire des données
- Analyse univariée
- Données catégorielles
- Donnees numeriques
- Analyse bivariée / multivarié
- Numérique et numérique
- Numérique et catégoriel
- Catégorique et catégorique
- Remarques finales
Visualisation de données
La visualisation des données représente du texte ou des données numériques dans un format visuel, qui facilite la compréhension des informations exprimées par les données. NOUS, les humains, nous nous souvenons plus facilement des images que du texte lisible, donc Python nous fournit diverses bibliothèques pour la visualisation de données comme matplotlib, marin, comploter, etc. Dans ce tutoriel, nous utiliserons Matplotlib et seaborn pour effectuer diverses techniques d'exploration des données à l'aide de divers tracés.
L'analyse exploratoire des données
Créer des hypothèses, tester diverses hypothèses commerciales tout en traitant tout énoncé de problème d'apprentissage automatique est très important et c'est ce que l'EDA aide à atteindre. Il existe plusieurs outils et techniques pour comprendre vos données, et le besoin de base est que vous devez avoir la connaissance de Numpy pour les opérations mathématiques et de Pandas pour la manipulation de données.
Nous utiliserons un jeu de données Titanic très populaire que tout le monde connaît et peut télécharger à partir de ici.
Commençons maintenant à explorer les données et à étudier différents graphiques de visualisation de données avec différents types de données.. Et pour montrer quelques-unes des techniques, Nous utiliserons également un ensemble de données intégré de seaborn comme données de pourboire qui explique les pourboires que chaque serveur reçoit de différents clients..
commençons par importer des bibliothèques et charger des données
importer numpy en tant que np
importer des pandas pd
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
à partir de l'importation maritime load_dataset
#jeu de données titanesque
données = pd.read_csv("train_titane.csv")
#ensemble de données de conseils
astuces = load_dataset("des astuces")
Analyse univariée
L’analyse univariée est la forme d’analyse la plus simple où l’on explore un seul variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes..... Une analyse univariée est effectuée pour mieux décrire les données. nous effectuons des analyses univariées de variables numériques et catégorielles différemment car le graphique utilise des graphiques différents.
Données catégorielles
Une variable contenant des informations textuelles est appelée variables catégorielles. regardons plusieurs graphiques que nous pouvons utiliser pour visualiser des données catégorielles.
1) CountPlot
Countplot est simplement un graphique du comptage de fréquence sous la forme de graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité..... Tracez le décompte pour chaque catégorie sur une barre séparée. Lorsque nous utilisons la fonction de comptage des valeurs de pandas dans n'importe quelle colonne, est la même forme visuelle de la fonction de valeur de comptage. Dans notre variable de destination des données, elle survit et est catégorique, alors dessinons un graphique de pointage de cela.
sns.countplot(data['Survived'])
plt.show()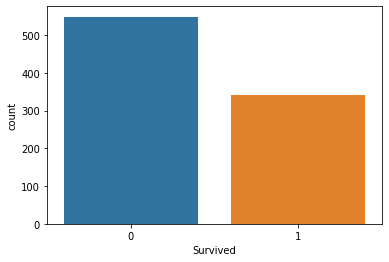
2) diagramme circulaireLe graphique circulaire, Aussi connu sous le nom de graphique circulaire, est une représentation visuelle qui montre la proportion de différentes parties par rapport à un tout. Il est couramment utilisé en statistique pour illustrer la distribution de données catégorielles. Chaque section du graphique représente un pourcentage du total, faciliter la comparaison entre les catégories. Sa conception claire et concise en fait un outil efficace pour la présentation d’informations quantitatives....
De plus, le camembert est le même que le graphique de comptage., il ne vous donne que des informations supplémentaires sur le pourcentage de présence de chaque catégorie dans les données, ce qui signifie quelle catégorie obtient la quantité de poids dans les données. Regardons la colonne Sexe, quel est le pourcentage de membres masculins et féminins voyageant.
data['Sex'].value_counts().plot(kind="pie", autopct="%.2f")
plt.show()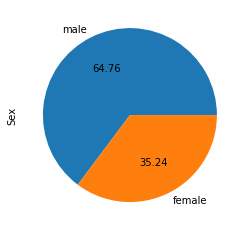
Donnees numeriques
L'analyse des données numériques est essentielle car la compréhension de la distribution des variables permet de traiter davantage les données. La plupart du temps, vous trouverez beaucoup d'incohérences avec les données numériques, donc explorer les variables numériques.
1) Histogramme
Un histogramme est un graphique de distribution de valeurs de colonnes numériques. Il crée simplement des bacs dans différentes plages de valeurs et les trace où nous pouvons visualiser comment les valeurs sont distribuées. Nous pouvons voir où se trouvent plus de valeurs, comme positif, négatif ou au centre (médias). Jetons un coup d'œil à la colonne Âge.
plt.hist(data['Age'], bins=5)
plt.show()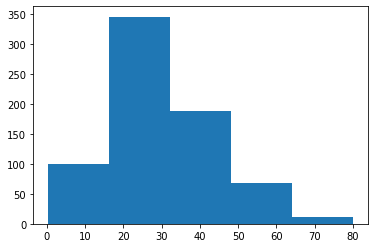
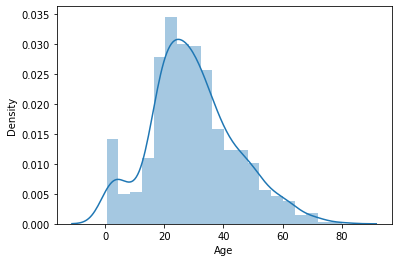
2) Distplot
Distplot est également connu sous le nom de deuxième histogramme car il s'agit d'une version légèrement améliorée de l'histogramme.. Distplot nous donne un KDE (Estimation de la densité du noyau) à propos de l'histogramme expliquant le PDF (Fonction de densité de probabilité), ce qui signifie quelle est la probabilité que chaque valeur se produise dans cette colonne. Si vous avez déjà étudié les statistiques, vous devez absolument connaître la fonction PDF.
sns.distplot(Les données['Âge'])
plt.show()
3) Box plot
Boxplot est une intrigue très intéressante qui trace simplement un résumé de 5 nombres. Pour un résumé de 5 nombres, nous devons décrire certains termes.
- MédianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes....: valeur moyenne en série après tri
- Centile: donne quel que soit le nombre est le nombre de valeurs présentes avant ce centile comme, par exemple, 50 en dessous du centile 25, donc cela explique le total de 50 valeurs inférieures au centile 25
- Minimum et maximum: ce ne sont pas des valeurs minimales et maximales, Ils décrivent plutôt les limites inférieure et supérieure de l'écart type calculé à l'aide de l'intervalle interquartile. (IQR).
IQR = Q3 - T1
Limite_inférieure = Q1 - 1.5 * IQR
Upper_bounday = Q3 +  1.5 * IQR
Ici Q1 et Q3 sont le premier quantile (centile 25) et le troisième quantile (centile 75)
Analyse bivariée / multivarié
Nous avons étudié plusieurs parcelles pour explorer des données numériques et catégorielles uniques. L'analyse bivariée est utilisée lorsque nous devons explorer le lien entre 2 différentes variables et nous devons le faire parce que, à la fin, notre tâche principale est d'explorer le lien entre les variables pour construire un modèle puissant. Et quand on analyse plus de 2 variables ensemble, connue sous le nom d'analyse multivariée. nous allons travailler sur différents graphiques pour l'analyse bivariée ainsi que multivariée.
Numérique et numérique
Premier, explorons les graphiques lorsque les deux variables sont numériques.
1) Nuage de pointsUn nuage de points est une représentation visuelle qui montre la relation entre deux variables numériques à l’aide de points sur un plan cartésien. Chaque axe représente une variable, et l’emplacement de chaque point indique sa valeur par rapport aux deux. Ce type de graphique est utile pour identifier des modèles, Corrélations et tendances dans les données, faciliter l’analyse et l’interprétation des relations quantitatives....
Tracer le lien entre deux nuages de points de variables numériques est un graphique simple à faire. Regardons le lien entre la facture totale et le pourboire fourni par le biais d’un Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées.....
sns.scatterplot(tips["total_bill"], tips["tip"])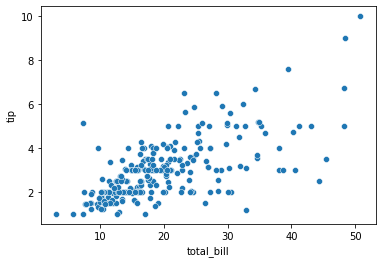
Analyse multivariée avec nuage de points
nous pouvons également représenter graphiquement les relations de 3 variables ou 4 variables avec un nuage de points. Supposons que nous voulions trouver le ratio séparé d'hommes et de femmes avec la facture totale et le pourboire fournis.
sns.scatterplot(tips["total_bill"], tips["tip"], hue=tips["sex"])
plt.show()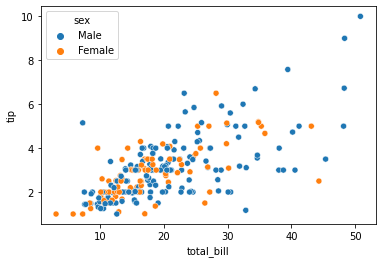
On peut également voir une analyse multivariée de 4 variables avec nuages de points utilisant des arguments de style. Supposons maintenant, avec le sexe, Je veux aussi savoir si le client était fumeur ou non pour qu'on puisse le faire.
sns.scatterplot(tips["total_bill"], tips["tip"], hue=tips["sex"], style=tips['smoker'])
plt.show()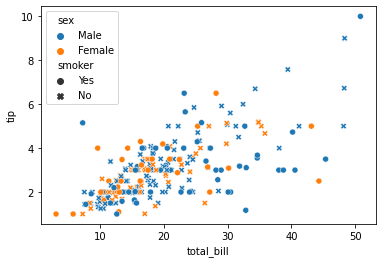
Numérique et catégoriel
Si une variable est numérique et l'autre catégorielle, il existe plusieurs graphiques que nous pouvons utiliser pour l'analyse bivariée et multivariée.
1) Graphique à barres
Le graphique à barres est un diagramme simple que nous pouvons utiliser pour tracer une variable catégorielle sur l'axe des x et une variable numérique sur l'axe des y et explorer la relation entre les deux variables.. La pointe noire en haut de chaque barre indique l'intervalle de confiance. Explorons la Classe P avec l'âge.
sns.barplot(data['Pclass'], data['Age'])
plt.show()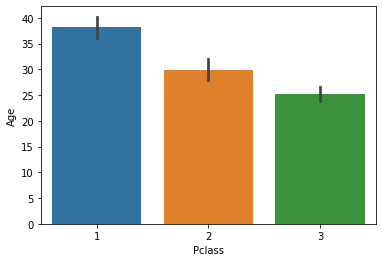
Analyse multivariée par graphique à barres
L'argument de Hue est très utile et permet d'analyser plus de 2 variables. À présent, avec le lien ci-dessus, nous voulons faire avec le genre.
sns.barplot(data['Pclass'], data['Fare'], hue = data["Sex"])
plt.show()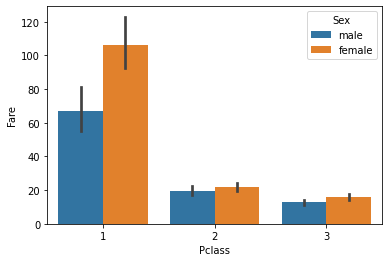
2) Box plot
Nous avons déjà étudié boîtes à moustachesDiagrammes encadrés, Aussi connu sous le nom de diagrammes en boîte et à moustaches, sont des outils statistiques qui représentent la distribution d’un ensemble de données. Ces diagrammes montrent la médiane, quartiles et valeurs aberrantes, Permettre de visualiser la variabilité et la symétrie des données. Ils sont utiles pour la comparaison entre différents groupes et pour l’analyse exploratoire, faciliter l’identification des tendances et des modèles dans les données.... Dans l’analyse univariée précédente. nous pouvons dessiner une boîte à moustaches séparée pour les deux variables. Explorons le genre avec l'âge à l'aide d'une boîte à moustaches.
sns.boxplot(data['Sex'], data["Age"])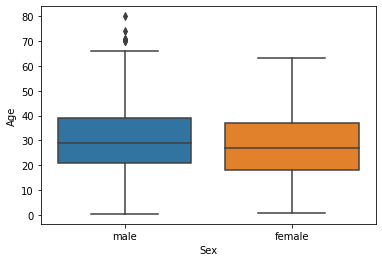
Analyse multivariée avec box plot
Avec l'âge et le sexe, voyons qui a survécu et qui n'a pas.
sns.boxplot(data['Sex'], data["Age"], data["Survived"])
plt.show()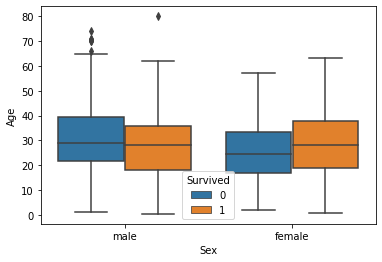
3) Distplot
Distplot explique la fonction PDF via l'estimation de la densité du noyau. Distplot n'a pas de paramètre de hauteur, mais nous pouvons le créer. Supposons que nous voulions voir la probabilité de personnes ayant une tranche d'âge de probabilité de survie et découvrir quelle probabilité de survie est élevée pour la tranche d'âge du taux de mortalité.
sns.distplot(data[data['Survived'] == 0]['Age'], hist=False, color="blue")
sns.distplot(data[data['Survived'] == 1]['Age'], hist=False, color="orange")
plt.show()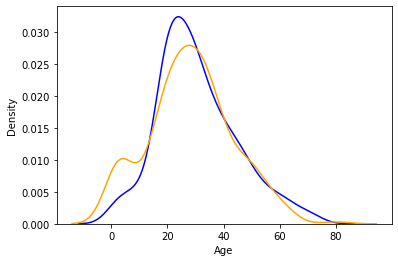
Comme nous pouvons le voir, le graphique est vraiment très intéressant. le bleu montre la probabilité de mourir et le graphique orange montre la probabilité de survie. Si on l'observe, on voit que la probabilité de survie des enfants est supérieure à la mort et que c'est l'inverse dans le cas des personnes âgées. Cette petite analyse dit parfois des choses importantes sur les données et aide à préparer des histoires de données.
Catégorique et catégorique
Nous allons maintenant travailler sur les colonnes catégorielles et catégorielles.
1) Carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées....
Si vous avez déjà utilisé une fonction de tableau croisé de pandas, Heatmap est une représentation visuelle équivalente de cela seulement. Simplement, montre combien de présence d'une catégorie en lien avec une autre catégorie est présente dans l'ensemble de données. permettez-moi de montrer d'abord avec le tableau croisé et plus tard avec la carte thermique.
pd.crosstab(data['Pclass'], data['Survived'])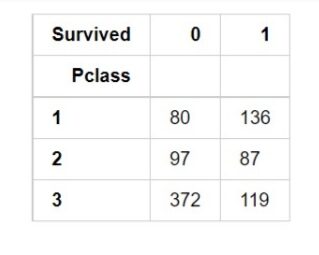
À présent, avec la carte thermique, nous devons trouver combien de personnes ont survécu et sont mortes.
sns.heatmap(pd.crosstab(data['Pclass'], data['Survived']))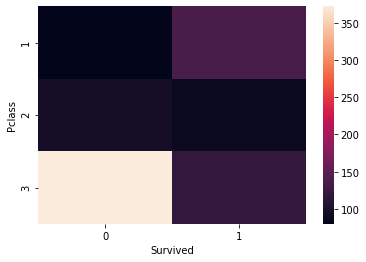
2) Carte de cluster
nous pouvons également utiliser une carte de cluster pour comprendre le lien entre deux variables catégorielles. Une carte de cluster dessine simplement un dendrogramme montrant les catégories de comportement équivalent ensemble..
sns.clustermap(pd.crosstab(data['Parch'], data['Survived']))
plt.show()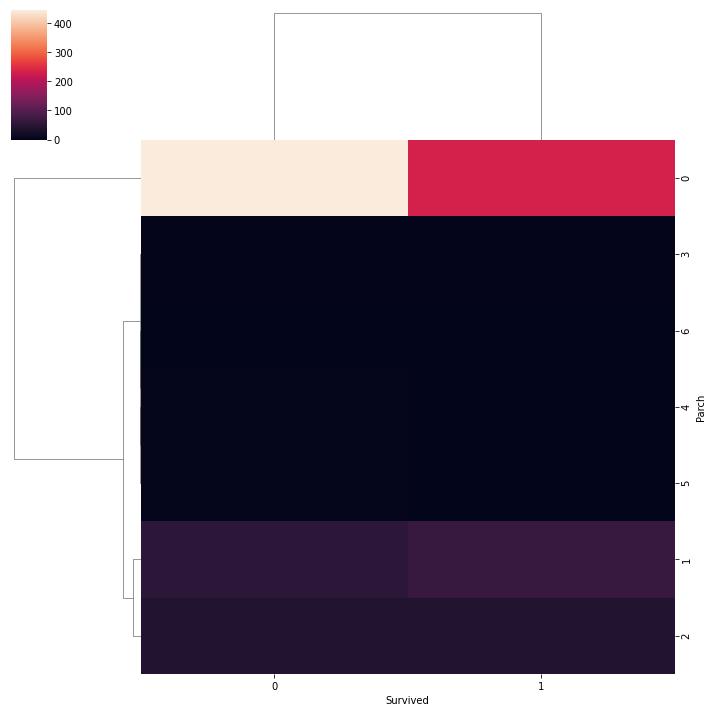
Si vous connaissez les algorithmes de clustering principalement sur DBSCAN, alors vous devriez connaître le dendrogramme. Ensuite, ce sont tous des graphiques qui sont principalement utilisés lors de l'analyse exploratoire. Il y a quelques autres intrigues que vous pouvez dessiner comme une intrigue violente, motif de ligne, une trame commune qui n'est pas principalement utilisée.
Le Notebook complet pour plus de pratique dans l'EDA et la visualisation des données est activé dans mes Notebooks par kaggle, y accéder depuis ici.
Remarques finales
L'EDA n'est qu'une clé pour mieux comprendre et représenter vos données, ce que, comme conséquence, vous aide à construire un modèle puissant et plus généralisé. La visualisation des données est facile à réaliser EDA, faciliter la compréhension de notre analyse pour les autres.
J'espère que c'était facile de rattraper toutes les intrigues que nous avons dessinées. Si vous avez des doutes, mentionnez-le dans la section commentaire ci-dessous. je serai ravi de vous aider.
A propos de l'auteur
Raghav Agrawal
Je poursuis ma licence en informatique. J'aime beaucoup la science des données et le big data. J'aime travailler avec les données et apprendre de nouvelles technologies. S'il vous plait, n'hésitez pas à me contacter sur Linkedin.





