
introduction
La manipulation des données est une phase inévitable de la modélisation prédictive. Un modèle prédictif robuste ne peut pas être construit simplement à l'aide d'algorithmes d'apprentissage automatique. Mais, avec une approche pour comprendre le problème de l'entreprise, les données sous-jacentes, effectuer les manipulations de données nécessaires puis extraire les informations commerciales.
Parmi ces différentes phases de construction du modèle, la plupart du temps est généralement consacré à comprendre les données sous-jacentes et à effectuer les manipulations nécessaires. Ce serait aussi le thème central de cet article: packages pour une manipulation plus rapide des données dans R.
Qu'est-ce que la manipulation de données?
Si vous êtes encore confus à ce sujet ‘fini’, laissez-moi expliquer. La manipulation de données est un terme qui est utilisé librement avec « Exploration des données ». ça implique ‘manipuler’ données à l'aide d'un ensemble de variables disponibles. Ceci est fait pour améliorer l'exactitude et la précision associées aux données..
En réalité, le processus de collecte de données peut comporter de nombreuses lacunes. Il existe plusieurs facteurs incontrôlables qui conduisent à l'inexactitude des données, que la situation mentale des enquêtés, préjugés personnels, différences / erreurs dans les lectures de la machine, etc. Pour pallier ces inexactitudes, les données sont manipulées pour augmenter la précision (maximum) possible dans les données.
Parfois, cette étape est également connue sous le nom de litige de données ou de nettoyage de données.
Différentes manières de manipuler / données de processus:
Il n'y a pas de bonne ou de mauvaise façon de manipuler les données, tant que vous les comprenez et avez pris les mesures nécessaires à la fin de l'exercice. Cependant, voici quelques façons générales dont les gens essaient d'aborder la manipulation des données. Sont ici:
- Comme d'habitude, les débutants en R sont à l'aise manipuler les données à l'aide des fonctions de base R intégrées. C'est une bonne première étape., mais c'est souvent répétitif et chronophage. Donc, est un moyen moins efficace de résoudre le problème.
- Utilisation de packages pour la manipulation de données. Le CRAN a plus de 7000 forfaits actuellement disponibles. En mots simples, ces packages ne sont rien de plus qu'une collection de codes pré-écrits couramment utilisés. Vous aider à effectuer des tâches répétitives à jeun, réduisez les erreurs de codage et obtenez l'aide d'un code écrit par des experts (à travers l'écosystème open source pour R) pour rendre votre code plus efficace. C'est généralement la façon la plus courante de manipuler des données.
- Utilisation d'algorithmes de ML pour la manipulation de données. Vous pouvez utiliser des algorithmes de renforcement arborescents pour traiter les données manquantes et les valeurs aberrantes. Bien que ceux-ci nécessitent certainement moins de temps, ces approches vous laissent généralement souhaiter une meilleure compréhension des données à la fin.
Donc, la plupart du temps, l'utilisation de packages est la méthode de facto pour effectuer la manipulation de données. Dans cet article, j'ai expliqué plusieurs packages qui facilitent la vie de ‘R’ pendant la phase de manipulation des données.
Noter: Cet article est plus adapté aux débutants en langage R. Vous pouvez installer un paquet en utilisant:
install.packages('package name')
Liste des paquets
Pour une meilleure compréhension, J'ai également démontré son utilisation en effectuant des opérations couramment utilisées. Vous trouverez ci-dessous la liste des packages abordés dans cet article:
- dépliant
- tableau de données
- ggplot2
- remodeler2
- lecteur
- ranger
- lubrifier
Noter: Je comprends que ggplot2 est un package graphique. Mais, en général, aide à visualiser les données (répartitions, corrélations) et effectuer des manipulations en conséquence. Donc, je l'ai ajouté à cette liste. Dans tous les forfaits, J'ai couvert uniquement les commandes les plus utilisées dans la manipulation de données.
paquet dplyr
Ces packages sont créés et maintenus par Hadley Wickham. Ce paquet a tout (presque) pour accélérer vos efforts de manipulation de données. Il est surtout connu pour l'exploration et la transformation des données. Sa syntaxe de chaînage le rend hautement personnalisable à utiliser. Il comprend 5 principales commandes de manipulation de données:
- filtre: filtrer les données en fonction d'une condition
- pour sélectionner: utilisé pour sélectionner des colonnes d'intérêt à partir d'un ensemble de données
- Organiser: est utilisé pour organiser les valeurs de l'ensemble de données par ordre croissant ou décroissant.
- tournoiement: utilisé pour créer de nouvelles variables à partir de variables existantes
- résumé (avec group_by): utilisé pour effectuer une analyse à l'aide d'opérations couramment utilisées, au minimum, maximum, nombre moyen, etc.
Concentrez-vous sur ces commandes et faites un excellent travail en explorant les données. Comprenons ces commandes une par une. J'ai utilisé 2 ensembles de données R préinstallés, a savoir, mtcars et iris.
> une bibliothèque(dépliant)
> Les données("mtcars")
> Les données('iris')
> mes données <- mtcars
#lire les données
> diriger(mes données)
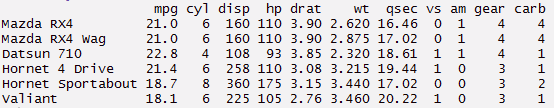
#créer une base de données locale. Les trames de données locales sont plus faciles à lire

> données d'accès <- tbl_df(mes données)
> myirisdata <- tbl_df(iris)
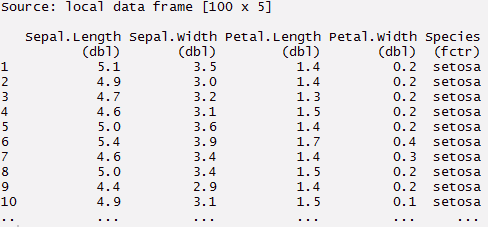
#maintenant les données seront dans une structure tabulaire > données d'accès> myirisdata
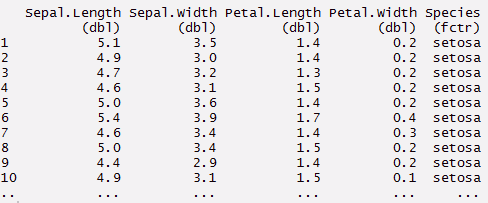
#utiliser le filtre pour filtrer les données avec la condition requise > filtre(données d'accès, cylindre > 4 & équipement > 4 )> filtre(données d'accès, cylindre > 4)
> filtre (myirisdata, Espèce% en% c ('setosa', 'virginica'))
#utilisation sélectionnerLa commande "SÉLECTIONNER" est fondamental en SQL, utilisé pour interroger et récupérer des données d'une base de données. Permet de spécifier des colonnes et des tables, en filtrant les résultats avec des clauses telles que "OÙ" et en triant avec "COMMANDÉ PAR". Sa polyvalence en fait un outil essentiel pour la manipulation et l'analyse des données, facilitant l'obtention d'informations spécifiques de manière efficace.... pour sélectionner des colonnes par nom > sélectionner(données d'accès, cylindre,mpg,ch)#ici vous pouvez utiliser (-) masquer des colonnes > sélectionner(données d'accès, -cylindre, -mpg )
# masquer une plage de colonnes> pour sélectionner (données d'accès, -c (cylindre, mpg))
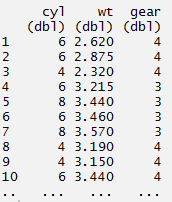
#chaînage ou pipeline - un moyen d'effectuer plusieurs opérations
#en une seule ligne
> accès%>%
     sélectionner(cylindre, poids, équipement)%>%
     filtre(poids > 2)
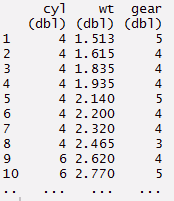
#arrange peut être utilisé pour réorganiser les lignes
> accès%>%
     sélectionner(cylindre, poids, équipement)%>%
     organiser(poids)
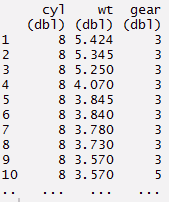
#ou
> accès%>%
     sélectionner(cylindre, poids, équipement)%>%
     organiser(desc(poids))
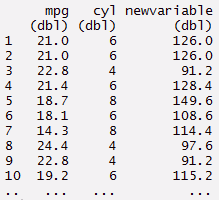
#subir une mutation - créer de nouvelles variables

> accès%>%
      sélectionner(mpg, cylindre)%>%
      subir une mutation(nouvelle variable = mpg*cyl)
#ou
> nouvelle variable <- accès%>% subir une mutation(nouvelle variable = mpg*cyl)
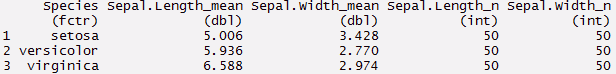
#résumer - ceci est utilisé pour trouver des informations à partir des données
> myirisdata%>%
       par groupe(Espèce)%>%
       résumer(Moyenne = moyenne(Longueur.sépale, na.rm = VRAI))
#ou utilisez résumer chaque
> myirisdata%>%
par groupe(Espèce)%>%
récapituler_chaque(amusements(moyenne, m()), Longueur.sépale, Largeur.sépale)
 #Vous pouvez créer des commandes de chaîne complexes en utilisant ces 5 verbes.
#vous pouvez renommer les variables en utilisant la commande rename
> accès%>% Renommer(miles = mpg)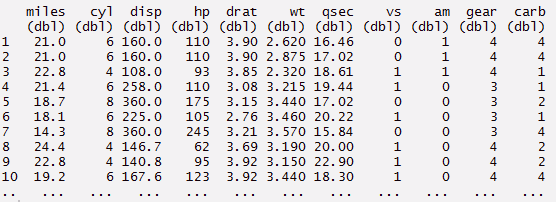
paquet data.table
Ce package vous permet d'effectuer une manipulation plus rapide sur un ensemble de données. Abandonnez vos méthodes traditionnelles de sous-configuration des lignes et des colonnes et utilisez ce package. Avec un codage minimal, peut faire beaucoup plus. L'utilisation de data.table permet de réduire le temps de calcul par rapport à data.frame. Vous serez étonné par la simplicité de ce forfait.
Un tableau de données a 3 les pièces, a savoir, DT[je,j,par]. Vous pouvez comprendre cela comme, nous pouvons demander à R de créer un sous-ensemble des lignes en utilisant ‘je’, pour calculer ‘j’ qui est regroupé par ‘pour’. La plupart du temps, « pour » est lié à un variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... categórica. Dans le code suivant, j'ai utilisé 2 ensembles de données (qualité de l'air et iris).
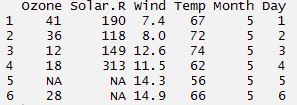
#charger les données
> Les données("qualité de l'air")
> mes données <- qualité de l'air
> diriger(qualité de l'air,6)
> Les données(iris)
> myiris <- iris
#charger le paquet
> une bibliothèque(data.table)
> mes données <- data.table(mes données)
> mes données
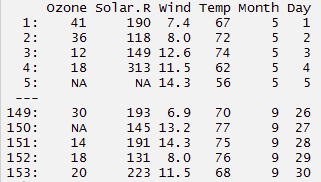
> myiris <- data.table(myiris)
> myiris
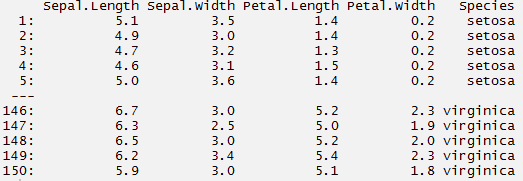
#lignes de sous-ensemble - sélectionnez la 2e à la 4e rangée

> mes données[2:4,]
#sélectionner des colonnes avec des valeurs particulières
> myiris[Species == 'setosa']
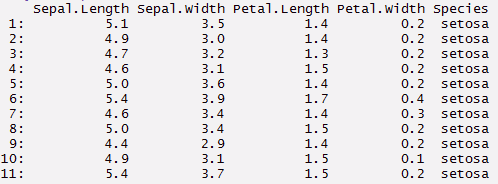
#sélectionner des colonnes avec plusieurs valeurs. Cela vous donnera des colonnes avec Setosa
#et les espèces virginica
> myiris[Espèce %en% c('setosa', 'virginica')]

#sélectionner des colonnes. Renvoie un vecteur
> mes données[,Temp]
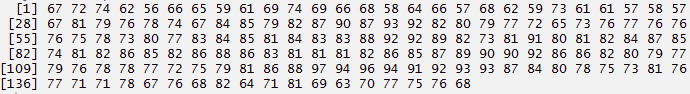
> mes données[,.(Temp,Mois)]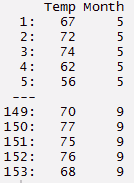
#renvoie la somme de la colonne sélectionnée
> mes données[,somme(Ozone, na.rm = VRAI)]

[1]4887
#renvoie la somme et l'écart type
> mes données[,.(somme(Ozone, na.rm = VRAI), Dakota du Sud(Ozone, na.rm = VRAI))]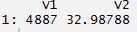
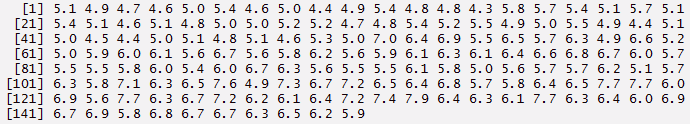
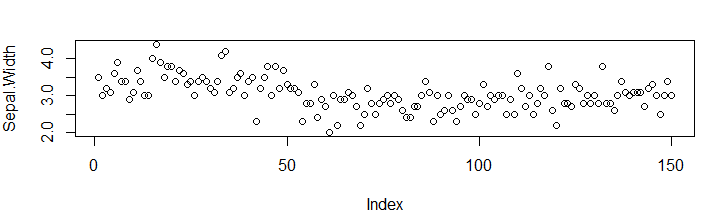
#imprimer et tracer
> myiris[,{imprimer(Longueur.sépale)
> terrain(Largeur.sépale)
 NUL}]
#regroupement par une variable
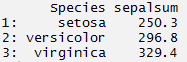
> myiris[,.(sepalsum = somme(Longueur.sépale)), par=Espèce]
#sélectionner une colonne pour le calcul, donc besoin de définir la clé sur la colonne
> setkey(myiris, Espèce)

#sélectionne toutes les lignes associées à ce point de données
> myiris['setosa']
> myiris[c('setosa', 'virginica')]
Paquet Ggplot2
ggplot offre un tout nouveau monde de couleurs et de motifs. Si vous êtes une âme créative, vous allez adorer ce pack au cœur. Mais, si vous voulez apprendre ce qui est nécessaire pour commencer, suivez les codes ci-dessous. Vous devez apprendre les moyens de tracer au moins ces 3 graphique: Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées...., Diagramme à bandes, Histogramme.
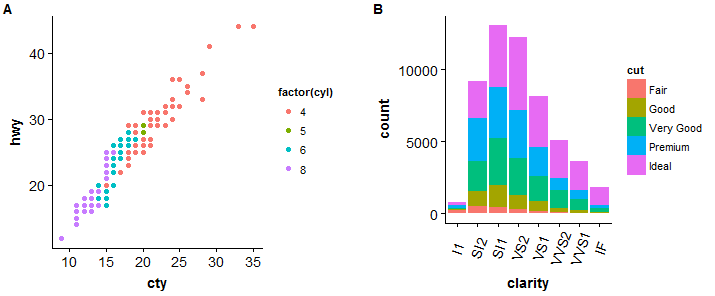
Ces 3 les modèles de graphique couvrent presque tous les types de représentation de données, sauf les cartes. ggplot est enrichi de fonctions personnalisées pour rendre votre visualisation de mieux en mieux. Il devient encore plus puissant lorsqu'il est associé à d'autres packages comme cowplot, grilleExtra. En réalité, il y a plusieurs fonctions. Donc, vous devez vous concentrer sur quelques commandes et développer votre expertise sur celles-ci. J'ai aussi montré la méthode pour comparer des graphiques dans une fenêtre. Nécessite le package ‘grilleExtra’. Donc, faut l'installer. J'ai utilisé des jeux de données R préinstallés.
> une bibliothèque(ggplot2)
> une bibliothèque(grilleExtra)
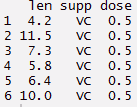
> df <- DentCroissance
> df$dose <- comme.facteur(df$dose)
> diriger(df)
#boîte à moustaches
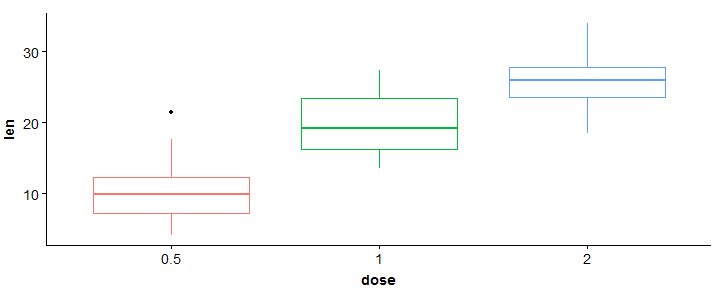
> pb <- ggplot(df, aes(x = dose, y = longueur, couleur = dose)) + geom_boxplot() + thème(legend.position = 'none')
> pb
#ajouter un quadrillage
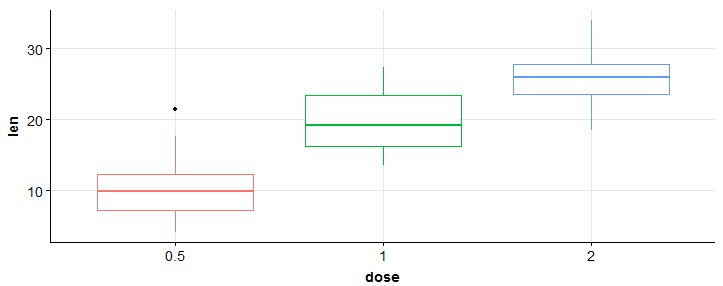
> pb + background_grid(majeur = "xy", mineur ="rien")
#nuage de points
> sp <- ggplot(mpg, aes(x = ct, y = autoroute, couleur = facteur(cylindre)))+geom_point(taille = 2.5)
> sp
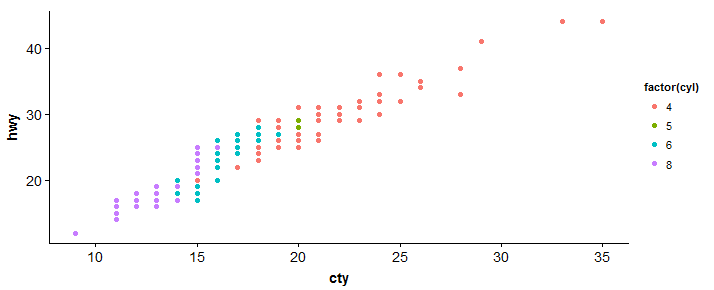
#graphique à barres
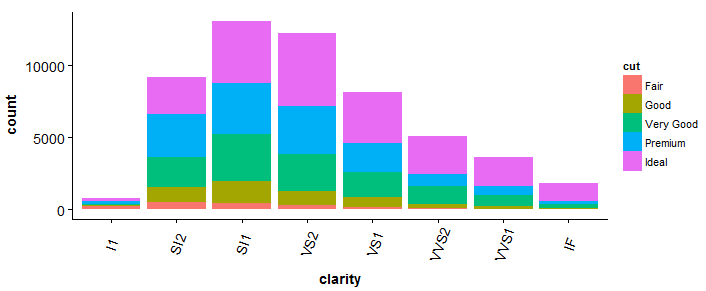
> pb <- ggplot(diamants, aes(clarté, remplir = couper)) + geom_bar() +thème(axe.texte.x = texte_élément(angle = 70, vjust = 0.5))
> pb
#comparer deux parcelles
> plot_grid(sp, pb, étiquettes = c("UNE","B"), ncol = 2, nrow = 1)
 #histogramme
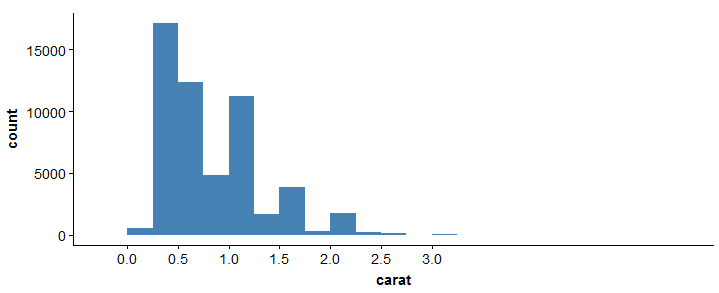
> ggplot(diamants, aes(x = carat)) + geom_histogramme(largeur de bac = 0.25, remplir="bleu acier")+scale_x_continuous(pauses=séquence(0,3, par=0,5))
Pour plus d'informations sur ce forfait, voir la fiche de référence ici: aide-mémoire ggplot2
paquet remodeler2
Comme son nom l'indique, ce paquet est utile pour remodeler les données. Nous savons tous que les données se présentent sous de nombreuses formes. Donc, nous sommes obligés de l'apprivoiser selon nos besoins. Comme d'habitude, le processus de remodelage des données dans R est fastidieux et inquiétant. Les fonctions de base de R consistent en l'option ‘Agrégation’ où les données peuvent être réduites et réorganisées sous des formes plus petites, mais avec une réduction de la quantité d'informations. L'agrégation comprend les fonctions de base tapply, par et ajouté. Le package de rénovation résout ces problèmes. Ici, nous essayons de combiner des fonctionnalités qui ont des valeurs uniques. Possède 2 fonctions à connaître faire fondre Oui émettre.
faire fondre : Cette fonction convertit les données du format large au format long. C'est une forme de restructuration dans laquelle plusieurs colonnes catégoriques se ‘fusionnent’ en rangées uniques. Comprenons en utilisant le code ci-dessous.
#créer une donnée
> identifiant <- c(1,2,3,4,5)
> Noms <- c('Joseph','Matrin','Joseph','James','Matrin')
> Date de naissance <- c(1993,1992,1993,1994,1992)
> Matière<- c('Maths','Biologie','Science','Psychologie','Physique')
> ces données <- trame de données(identifiant, Noms, Date de naissance, Matière)
> data.table(ces données)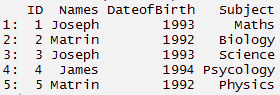
#charger le paquet
> install.paquets('reshape2')
> une bibliothèque(remodeler2)
#faire fondre
> mont <- faire fondre(ces données, identifiant =(c('ID','Noms')))
> mont
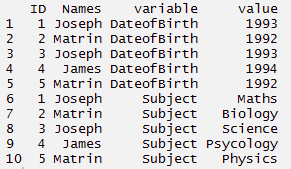
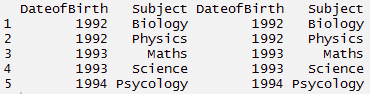
émettre : Cette fonction convertit les données du format long au format large. Commence avec des données fusionnées et passe au format long. C'est juste l'inverse de faire fondre une fonction. Il a deux fonctions à savoir, dcast Oui un casting. dcast renvoie une trame de données en sortie. acast renvoie un vecteur / quartier général / tableau en sortie. Comprenons en utilisant le code ci-dessous.
#jeter
> mcast <- dcast(mont, Date de naissance + Sujet ~ variable)
> mcast
Noter: En recherchant, J'ai trouvé cette image qui décrit bien le package de rénovation.
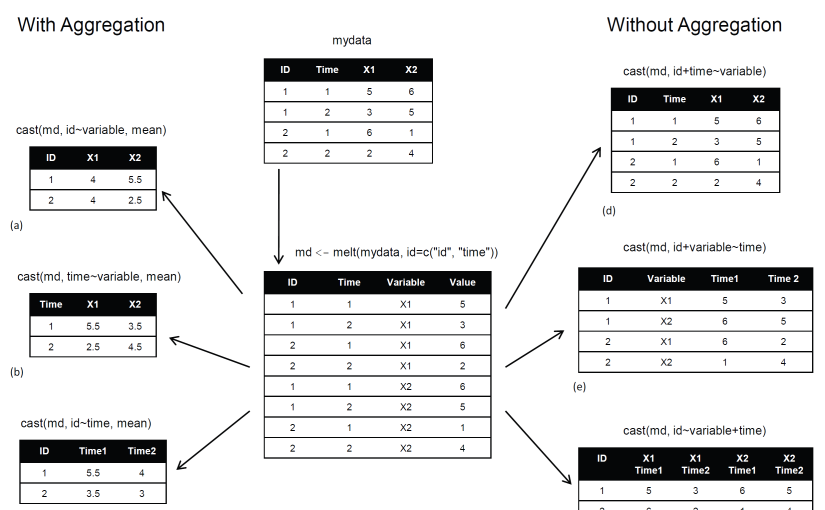 la source: r-statistiques
paquet lecteur
Comme le nom le suggère, ‘lecteur’ aide à lire diverses formes de données dans R. Avec une vitesse 10 fois plus rapide. Ici, les personnages ne deviennent jamais des facteurs (donc plus de chaîneAsFactors = FALSE). Ce package peut remplacer les fonctions de base R traditionnelles read.csv () y lire.table (). Aide à la lecture des données suivantes:
- Fichiers délimités par
read_delim(),read_csv(),read_tsv(), Ouiread_csv2(). - Fichiers à largeur fixe avec
read_fwf(), Ouiread_table(). - Fichiers journaux Web avec
read_log()
Si le temps de chargement des données est supérieur à 5 secondes, cette fonction vous montrera également une barre de progression. Vous pouvez supprimer la barre de progression en la marquant comme FAUX. Voyons le code suivant:
> install.paquets('readr')
> une bibliothèque(lecteur)
> lire_csv('test.csv',col_names = VRAI)
Vous pouvez également spécifier le type de données de chaque colonne chargée dans les données à l'aide du code suivant:
> lire_csv("iris.csv", col_types = liste(
      Sepal.Length = col_double(),
      Sepal.Largeur = col_double(),
      Pétale.Longueur = col_double(),
      Pétale.Largeur = col_double(),
      Espèce = col_facteur(c("soyeux", "versicolor", "virginique"))
))
Cependant, si vous choisissez de sauter les colonnes sans importance, s'en occupera automatiquement. Ensuite, le code ci-dessus peut également être réécrit comme:
> lire_csv("iris.csv", col_types = liste(
           Espèce = col_facteur(c("soyeux", "versicolor", "virginique"))
)
PS – readr a de nombreuses fonctions d'assistance. Ensuite, lors de l'écriture d'un fichier csv, utiliser write_csv en su lugar. C'est beaucoup plus rapide que write.csv.
pack de rangement
Ce package peut donner l'impression que vos données « organisé ». Possède 4 fonctions principales pour effectuer cette tâche. Il va sans dire que si vous êtes bloqué dans la phase d'exploration des données, vous pouvez les utiliser à tout moment (avec dplyr). Ce duo forme une équipe formidable. Ils sont faciles à apprendre, coder et implémenter. Sommes 4 les fonctions sont:
- rassembler () – ‘réunit’ plusieurs colonnes. Alors, les transforme en paires de clés: valeur. Cette fonction passera d'une forme large de données à une forme longue. Vous pouvez l'utiliser comme une alternative à ‘faire fondre’ dans le forfait rénovation.
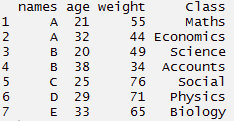
- diffuser (): il est inversé pour collecter. Prenez une paire de clés: valeur et la convertit en colonnes séparées.
- briser (): diviser une colonne en plusieurs colonnes.
- unir (): est inversé ou séparé. Joindre plusieurs colonnes en une seule colonne
Comprenons de près en utilisant le code suivant:
#charger le paquet
> une bibliothèque(ranger)
#créer un jeu de données factice
> noms <- c('A','B','C','D','E','A','B')
> poids <- c(55,49,76,71,65,44,34)
> âge <- c(21,20,25,29,33,32,38)
> Classer <- c('Maths','Science','Social','Physique','Biologie','Économie','Comptabilité')
#créer un bloc de données > tdata <- trame de données(noms, âge, poids, Classer) > tdata#en utilisant la fonction de rassemblement > long_t <- tdata%>% rassembler(Clé, Valeur, poids:Classer) > long_t
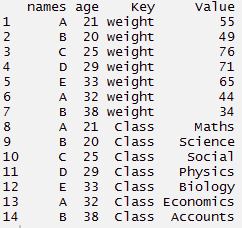
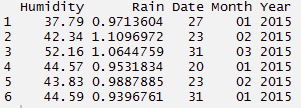
La fonction séparée est mieux utilisée lorsque nous disposons d'une variable datetime dans l'ensemble de données. Étant donné que la colonne contient plusieurs informations, il est logique de le diviser et d'utiliser ces valeurs individuellement. En utilisant le code ci-dessous, j'ai séparé une colonne en date, mois et année.
#créer un ensemble de données
> Humidité <- c(37.79, 42.34, 52.16, 44.57, 43.83, 44.59)
> Pluie <- c(0.971360441, 1.10969716, 1.064475853, 0.953183435, 0.98878849, 0.939676146)
> Temps <- c("27/01/2015 15:44","23/02/2015 23:24", "31/03/2015 19:15", "20/01/2015 20:52", "23/02/2015 07:46", "31/01/2015 01:55")
#construire un bloc de données
> d_set <- trame de données(Humidité, Pluie, Temps)
#en utilisant une fonction séparée, nous pouvons séparer la date, mois, année
> séparé <- d_set %>% séparé(Temps, c('Date', 'Mois','Année'))
> séparé
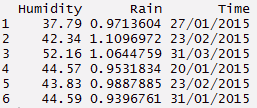
 #en utilisant la fonction unir - inverse de séparé
> uni <- séparé%>% unir(Temps, c(Date, Mois, Année), sept = "/")
> uni
 #en utilisant la fonction de propagation - compilation inversée> large_t % diffuser (mot de passe, valeur)> large_t
Paquet de lubrification
Le package Lubridate réduit les tracas liés à l'utilisation de la variable de temps de données dans R. La fonction intégrée de ce package offre un bon moyen pour faciliter l'analyse des dates et des heures. Ce package est fréquemment utilisé avec des données comprenant des données ponctuelles. Ici, j'ai couvert trois tâches de base effectuées avec Lubridate.
Cela inclut la fonction de mise à jour, fonction de durée et extraction de date. En tant que débutant, connais ces 3 les fonctions vous donneront suffisamment d'expérience pour gérer les variables de temps. Même si, R a des fonctions intégrées pour gérer les dates, mais c'est beaucoup plus rapide. Comprenons en utilisant le code suivant:
> install.paquets('lubridate')
> une bibliothèque(lubrifier)
#date et heure actuelles
> maintenant()
[1] "2015-12-11 13:23:48 EST"
#affectation de la date et de l'heure actuelles à la variable n_time
> n_heure <- maintenant()
#en utilisant la fonction de mise à jour
> n_mise à jour <- mettre à jour(n_heure, année = 2013, mois = 10)
> n_mise à jour
[1] "2013-10-11 13:24:28 EST"
#ajouter des jours, mois, année, secondes
> d_heure <- maintenant()
> d_heure + jours(1)
[1] "2015-12-12 13:24:54 EST"
> d_heure + semaines(2)
[1] "2015-12-12 13:24:54 EST"

> d_heure + ans(3)
[1] "2018-12-10 13:24:54 EST"

> d_heure + dheures(2)
[1] "2015-12-11 15:24:54 EST"

> d_heure + dminutes(50)
[1] "2015-12-11 14:14:54 EST"

> d_heure + dsecondes(60)
[1] "2015-12-11 13:25:54 EST"
#date d'extraction,temps
> n_time$heure <- heure(maintenant())
> n_time$minute <- minute(maintenant())
> n_time$seconde <- seconde(maintenant())
> n_time$mois <- mois(maintenant())
> n_time$année <- année(maintenant())
#vérifier les dates extraites dans des colonnes séparées
> nouvelles données <- trame de données(n_time$heure, n_time$minute, n_time$seconde, n_time$mois, n_time$année)
> nouvelles données
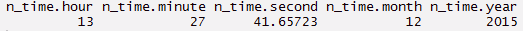
Noter: La meilleure utilisation de ces packages n'est pas isolément mais ensemble. Vous pouvez facilement utiliser ce package avec dplyr, où vous pouvez facilement sélectionner une variable de données et en extraire les données utiles à l'aide de la commande string.
Remarques finales
Ces packages amélioreraient non seulement votre expérience de manipulation de données, ils vous donneraient également des raisons d'explorer R en profondeur. Maintenant que nous avons vu, ces packages facilitent l'encodage en R. Plus besoin d'écrire de longs codes. À sa place, écrivez des shortcodes et faites plus.
Chaque package a des capacités multitâches. Donc, Je vous suggère d'obtenir une fonction importante qui peut être utilisée fréquemment. Oui, une fois que vous les connaissez, tu peux aller plus loin. J'ai d'abord fait cette erreur. J'ai essayé d'explorer toutes les fonctions de ggplot2 et j'ai fini dans la confusion. Je vous suggère de pratiquer ces codes en lisant. Cela vous aiderait à renforcer la confiance dans l'utilisation de ces packages..
Dans cet article, J'ai expliqué l'utilisation des packages 7 R qui peut rendre l'exploration des données plus facile et plus rapide. R connu pour ses incroyables fonctions statistiques, avec des packages récemment mis à jour, en fait également un outil de prédilection des data scientists.





