
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
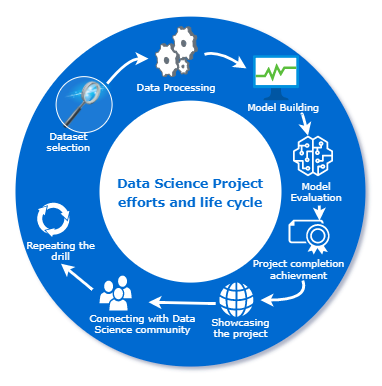
Etapas para seu primeiro projeto de ciência de dados
Neste artigo, Vejamos algumas dicas que você pode usar para começar seus projetos de ciência de dados pessoais..
1. Escolha um conjunto de dados
Se você estiver participando do projeto de ciência de dados pela primeira vez, escolha um conjunto de dados de seu interesse. Pode estar relacionado a esportes, filmes ou musica, qualquer coisa que te interesse. Os sites mais comuns para obter os dados são:
Para quem já fez um ou dois projetos, fim a fim por conta própria, seguindo as diretrizes acima, pode direcionar a análise de um conjunto de dados complexo de um domínio particular, como varejo, finanças ou saúde para ter uma ideia de projetos em tempo real.
Para começar, havia selecionado um conjunto de dados de seguro de saúde para praticar análises preditivas. Tirei o conjunto de dados do site kaggle
! pip install -q kaggle
#from google.colab import files
#files.upload()
! mkdir ~/.kaggle
! cp kaggle.json ~/.kaggle/
! chmod 600 ~/.kaggle/kaggle.json
#! kaggle datasets download -d mirichoi0218/seguro
#! seguro de unzip.zip -d seguro de saúde
! kaggle datasets download -d mirichoi0218/seguro
! seguro de unzip.zip -d seguro de saúde
2. Escolha um IDE
Selecione um IDE com o que você está mais confortável. Se você estiver usando python como linguagem, aqui estão alguns exemplos
- – É um IDE projetado para escrever códigos Python. Fornece várias funções produtivas, como cuidados de rotina, completamento de código inteligente, verificação de erros e correção de código. Facilita a manutenção do projeto, fornecendo integração com funções de controle de versão, suporta desenvolvimento web e ciência de dados.
- Notebook Jupyter – É um aplicativo da web de código aberto que permite criar e compartilhar documentos contendo código ativo, equações e visualização. Ajuda a agilizar o trabalho e facilitar as colaborações
- Google Colab – Permite que os usuários escrevam e executem código Python. É muito adequado para projetos de ciência de dados e aprendizado de máquina, uma vez que oferece recursos computacionais gratuitamente. Você pode executar algoritmos de aprendizado de máquina pesados aqui com facilidade, sem ter que se preocupar com infraestrutura ou custos.
- Arquivo de texto simples com extensão .py: embora as opções acima estejam disponíveis e sejam fáceis de usar, se você se sentir mais confortável usando o bloco de notas para escrever seu código, você pode usá-lo e salvar seu arquivo com a extensão .py. Então você pode executar o mesmo usando uma linha de comando com sintaxe como "python <> .py. Isso irá executar o seu programa, mas para empregos de ciência de dados, esta pode não ser a melhor opção, já que você não pode ver a saída do código ou visualizações em tempo real.
Selecionei o Google Colab como ambiente de trabalho.
3. Liste claramente as atividades
Faça uma lista das atividades que deseja fazer no conjunto de dados para ter um caminho claro antes de começar. As atividades comuns que fazemos em projetos de ciência de dados são a ingestão de dados, limpeza de dados, transformação de dados, Análise exploratória de dados, construção de modelo, avaliação de modelo e implementação de modelo. Aqui está um resumo sobre todas essas etapas.
- Ingestão de dados – É um processo de leitura dos dados em um quadro de dados.
###O pacote Panda facilita a leitura de um arquivo em um dataframe

#Importing the libraries
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib.cbook import boxplot_stats
import statsmodels.api as sm
from sklearn.model_selection import train_test_split,GridSearchCV, cross_val_score, cross_val_predict
from statsmodels.stats.outliers_influence import variance_inflation_factor
from sklearn.tree import DecisionTreeRegressor
from sklearn import ensemble
import numpy as np
import pickle

#Reading and summarizing the data
health_ins_df = pd.read_csv("seguro de saúde/seguro.csv")
health_ins_df.columns
health_ins_df.shape
health_ins_df.describe()
- Limpeza de dados – Es el proceso de identificar y eliminar las anomalías en el conjunto de datos.
- Transformação de dados – Envolve a mudança do tipo de dados das colunas, crie colunas derivadas ou remova dados duplicados, para nomear alguns.
- Análise exploratória de dados – Realize análises univariadas e multivariadas em conjuntos de dados para encontrar informações e padrões ocultos neles.
Eu me dediquei à limpeza de dados e análise exploratória de dados de variáveis numéricas e categóricas em dias separados para me concentrar nos detalhes..
#Visualizando a coluna de idade com um histograma
FIG,axes = plt.subplots(1,2,figsize =(10,5))
sns.histplot( health_ins_df['age'] , color ="céu azul",ax = axes[0])
sns.histplot( health_ins_df['BMI'] , color ="Oliva",ax = axes[1])
plt.show()
#Visualizing age column with a boxplot
fig,axes = plt.subplots(1,2,figsize =(10,5))
sns.boxplot(x = 'idade', dados = health_ins_df, ax = axes[0])
sns.boxplot(x = 'BMI', dados = health_ins_df, ax = axes[1])
plt.show()
#Finding the outlier values in the bmi column
outlier_list = boxplot_stats(health_ins_df.bmi).pop(0)['fliers'].listar()
imprimir(outlier_list)
#Finding the number of rows containing outliers
outlier_bmi_rows = health_ins_df[health_ins_df.bmi.isin(outlier_list)].forma[0]
imprimir("Número de linhas que contaminam outliers no BMI : ", outlier_bmi_rows)
#Percentage of rows which are outliers
percent_bmi_outlier = (outlier_bmi_rows/health_ins_df.shape[0])*100
imprimir("Percentual de outliers em colunas de IMC : ", percent_bmi_outlier)
#Converting age into age brackets
print("Valor mínimo para idade : ", health_ins_df['age'].min(),"n Valor máximo para idade : ", health_ins_df['age'].max())
#Idade entre 18 para 40 years will fall under young
#Age between 41 para 58 years will fall under mid-age
#Age above 58 years will fall under old age
health_ins_df.loc[(health_ins_df['age'] >=18) & (health_ins_df['age'] <= 40), 'age_group'] = 'young'
health_ins_df.loc[(health_ins_df['age'] >= 41) & (health_ins_df['age'] <= 58), 'age_group'] = 'mid-age'
health_ins_df.loc[health_ins_df['age'] > 58, 'age_group'] = 'old'

fig,axes = plt.subplots(1,5,figsize =(20,8))
sns.countplot(x = 'sexo', dados = health_ins_df_clean, paleta ="magma",ax = axes[0])
sns.countplot(x = 'crianças', dados = health_ins_df_clean, paleta ="magma",ax = axes[1])
sns.countplot(x = 'fumante', dados = health_ins_df_clean, paleta ="magma",ax = axes[2])
sns.countplot(x = 'região', dados = health_ins_df_clean, paleta ="magma",ax = axes[3])
sns.countplot(x = 'age_group', dados = health_ins_df_clean, paleta ="magma",ax = axes[4])
mapa de calor = sns.heatmap(health_ins_df_clean.corr(), vmin=-1, vmax=1, annot = True)
sns.relplot(x ="bmi", y ="Acusações",matiz ="sexo", estilo = "sexo", data=health_ins_df_clean);
sns.boxplot(x ="fumante", y ="Acusações", data=health_ins_df_clean)
- Construção do modelo – Pruebe y pruebe todos los modelos posibles en el conjunto de datos antes de elegir el correcto según las limitaciones comerciales / técnicas. Durante esta fase, también puede probar algunas técnicas de embolsado o refuerzo.
Base primero desarrollé un modelo, antes de probar cualquier modelo avanzado en el conjunto de datos
#Data Pre-processing
#Converting categorical values into dummies using one-hot encoding technique
health_ins_df_processed = pd.get_dummies(health_ins_df_clean, colunas =['sexo','crianças','fumante','região','age_group'], prefixo=['sexo','crianças','fumante','região','age_group'])
health_ins_df_processed.drop(['age'],eixo = 1, local = Verdadeiro)
#Building linear regression model
X = health_ins_df_processed.loc[:, health_ins_df_processed.colunas != 'charges']
y = health_ins_df_processed['charges']
X_train, X_test, y_train, y_test = train_test_split(X, e, test_size = 0,33)
X = sm.add_constant(X) # adding a constant
model = sm.OLS(e, X).ajuste()
predictions = model.predict(X)
print_model = modelo.resumo()
imprimir(print_model)
#Final model after eliminating variable with least significance and high vif
X = health_ins_df_processed[['BMI','children_0', 'smoker_yes',  'region_southeast', 'region_southwest', 'age_group_old', 'age_group_young']]
y = health_ins_df_processed['charges']
X_train, X_test, y_train, y_test = train_test_split(X, e, test_size = 0,33)
X = sm.add_constant(X) # adding a constant
model = sm.OLS(e, X).ajuste()
predictions = model.predict(X)
print_model = modelo.resumo()
imprimir(print_model)
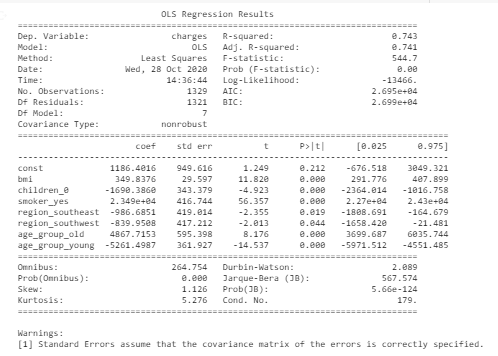
- Avaliação de modelo – En esta fase, testamos se nosso modelo é bom o suficiente para obter o resultado esperado. Nós medimos precisão, especificidade, sensibilidade ou R-quadrado ajustado de acordo com o modelo que usamos
Esta é a métrica de avaliação final do modelo básico que mostra um 74% precisão e 7 variáveis significativas (valor de p <valor de significância)
4. Conclua as tarefas uma por uma
A estas alturas, você deve ter uma ideia de quais atividades fazer em seu projeto. Você pode pegá-los um por um. Não necessariamente, você tem que completar tudo em um dia. Pode demorar até 1 dia para decidir em qual conjunto de dados você deseja trabalhar e com qual ambiente você se sente confortável.
Pode dedicar o dia 2 entender dados e realizar atividades de limpeza de dados. Do mesmo modo, você pode ter como objetivo concluir seu projeto em um período de 7-8 dias.
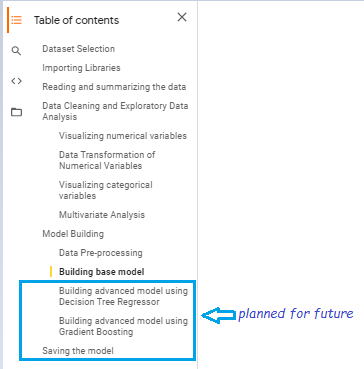
Eu fiz este projeto em um período de 4 dias. Eu planejei testar alguns modelos mais avançados para aumentar o desempenho preditivo
5. Prepare um resumo
Estarei preparando um breve resumo após a conclusão deste projeto.
6. Compartilhe em plataformas de código aberto
Escolha uma plataforma de código aberto onde você deseja publicar o resumo ou os códigos do projeto para que possa ganhar visibilidade na comunidade de ciência de dados e se conectar com outros entusiastas. GitHub é mais comumente usado hoje em dia. Existem alguns sites como Kaggle, Google Colab oferecendo kernels embutidos para que você possa escrever código e executar sem ter que se preocupar com a infraestrutura. Você também pode aproveitar essas plataformas.
O código-fonte está disponível em meu GitHub conta
As vantagens de assumir projetos em etapas
1. Não há pressão para concluir o projeto em um dia.
2. Você pode se concentrar apenas em uma tarefa específica em um dia e pode concluí-la com eficiência.
3. Isso o manterá grudado nas tarefas até terminar
4. O resumo do projeto pode ser consultado no futuro, durante a preparação para entrevistas ou realização de tipos semelhantes de projetos..
5. Você pode aproveitar este projeto para se conectar com outros entusiastas da ciência de dados e compartilhar ideias criativas..
Aprendi que devemos seguir uma abordagem disciplinada para aprender e investir nosso tempo fazendo projetos. Todos nós aprendemos mais, fazendo as coisas de uma maneira prática. Em última instância, é o trabalho árduo e a perseverança que o conduzirá pelo caminho que sempre sonhou pavimentar.





