
Esta postagem foi lançada como parte do Data Science Blogathon
Introdução
para entender melhor seus dados, o que ajuda no pré-processamento de dados. E a visualização de dados é a chave, uma vez que simplifica o procedimento de análise exploratória de dados e analisa os dados facilmente por meio de tabelas e gráficos maravilhosos.
Tabela de conteúdo
- Visualização de dados
- Análise exploratória de dados
- Análise univariada
- Dados categóricos
- Dados numéricos
- Análise bivariada / multivariado
- Numérico e numérico
- Numérico e categórico
- Categórico e categórico
- Notas finais
Visualização de dados
A visualização de dados representa texto ou dados numéricos em um formato visual, o que facilita o entendimento das informações expressas pelos dados. Nós, os humanos, nos lembramos de imagens com mais facilidade do que de texto legível, então Python nos fornece várias bibliotecas para visualização de dados como matplotlib, nascido do mar, conspirar, etc. Neste tutorial, usaremos Matplotlib e seaborn para executar várias técnicas para explorar dados usando vários gráficos.
Análise exploratória de dados
Crie hipóteses, testar várias suposições de negócios enquanto lida com qualquer declaração de problema de aprendizado de máquina é muito importante e é isso que a EDA ajuda a alcançar. Existem várias ferramentas e técnicas para entender seus dados, e a necessidade básica é que você deve ter o conhecimento de Numpy para operações matemáticas e Pandas para manipulação de dados.
Usaremos um conjunto de dados muito popular do Titanic com o qual todos estão familiarizados e podem fazer download em aqui.
Agora vamos começar a explorar dados e estudar diferentes gráficos de visualização de dados com diferentes tipos de dados.. E para demonstrar algumas das técnicas, também usaremos um conjunto de dados embutido como dados de gorjeta que explicam os conselhos que cada garçom recebe de diferentes clientes..
vamos começar importando bibliotecas e carregando dados
import numpy as np
import pandas pd
import matplotlib.pyplot as plt
import seaborn as sns
from seaborn import load_dataset
#titanic dataset
data = pd.read_csv("titanic_train.csv")
#tips dataset
tips = load_dataset("Dicas")
Análise univariada
El análisis univariado es la forma más simple de análisis donde exploramos una sola variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos..... A análise univariada é realizada para descrever melhor os dados. realizamos análises univariadas de variáveis numéricas e categóricas de maneira diferente porque o gráfico usa gráficos diferentes.
Dados categóricos
Uma variável com informações baseadas em texto é conhecida como variáveis categóricas. vamos dar uma olhada em vários gráficos que podemos usar para visualizar dados categóricos.
1) CountPlot
Countplot es simplemente un gráfico de recuento de frecuencias en forma de gráfico de barrasO gráfico de barras é uma representação visual de dados que usa barras retangulares para mostrar comparações entre diferentes categorias. Cada barra representa um valor e seu comprimento é proporcional a ele. Esse tipo de gráfico é útil para visualizar e analisar tendências, facilitar a interpretação de informações quantitativas. É amplamente utilizado em várias disciplinas, como estatísticas, Marketing e pesquisa, devido à sua simplicidade e eficácia..... Trace a contagem para cada categoria em uma barra separada. Quando usamos a função de contagem de valores de pandas em qualquer coluna, é a mesma forma visual da função de valor de contagem. Em nossa variável de destino de dados, ele sobrevive e é categórico, então vamos desenhar um gráfico de contagem deste.
sns.countplot(data['Survived'])
plt.show()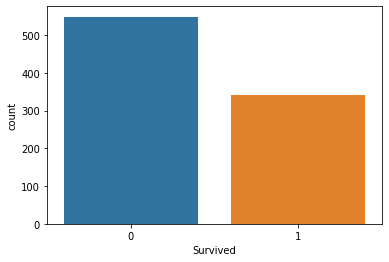
2) gráfico de pizzaO gráfico de pizza, Também conhecido como gráfico de pizza, é uma representação visual que mostra a proporção de diferentes partes para um todo. É comumente usado em estatística para ilustrar a distribuição de dados categóricos. Cada seção do gráfico representa uma porcentagem do total, facilitando a comparação entre categorias. Seu design claro e conciso o torna uma ferramenta eficaz para a apresentação de informações quantitativas....
O gráfico de pizza também é o mesmo que o gráfico de contagem, ele apenas fornece informações adicionais sobre a porcentagem de presença de cada categoria nos dados, o que significa que categoria obtém a quantidade de peso nos dados. Vejamos a coluna Sexo, qual é a porcentagem de membros masculinos e femininos viajando.
data['Sex'].value_counts().plot(kind="pie", autopct="%.2f")
plt.show()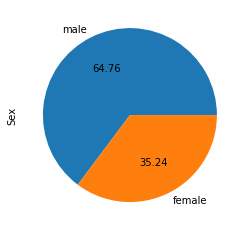
Dados numéricos
A análise de dados numéricos é essencial porque compreender a distribuição das variáveis ajuda a processar os dados posteriormente. Na maioria das vezes, você encontrará muitas inconsistências com os dados numéricos, portanto, explore as variáveis numéricas.
1) Histograma
Um histograma é um gráfico de distribuição de valores de colunas numéricas. Ele apenas cria caixas em vários intervalos de valores e os plota onde podemos visualizar como os valores são distribuídos. Podemos ver onde mais valores são encontrados, tão positivo, negativo ou no centro (meios de comunicação). Vamos dar uma olhada na coluna Idade.
plt.hist(data['Age'], bins=5)
plt.show()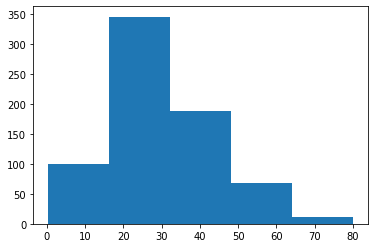
2) Distplot
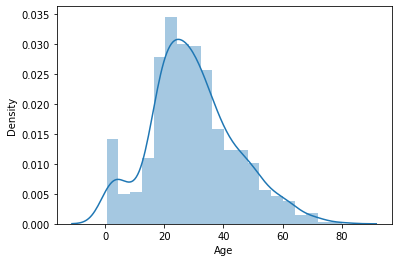
Distplot também é conhecido como o segundo histograma porque é uma versão ligeiramente aprimorada do histograma.. Distplot nos dá um KDE (Estimativa de densidade do kernel) sobre histograma explicando PDF (Função densidade de probabilidade), o que significa qual é a probabilidade de cada valor ocorrer nesta coluna. Se você já estudou estatísticas antes, você deve definitivamente saber a função PDF.
sns.distplot(dados['Age'])
plt.show()
3) Box plot
Boxplot é uma trama muito interessante que simplesmente traça um resumo de 5 números. Para um resumo de 5 números, precisamos descrever alguns termos.
- MedianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos....: valor médio na série após a classificação
- Percentil: dá qualquer número que é o número de valores presentes antes deste percentil como, como um exemplo, 50 abaixo do percentil 25, por isso explica o total de 50 valores que estão abaixo do percentil 25
- Mínimo e Máximo: estes não são valores mínimos e máximos, em vez disso, eles descrevem o limite inferior e superior do desvio padrão que é calculado usando a faixa interquartil (IQR).
IQR = Q3 - Q1
Lower_boundary = Q1 - 1.5 * IQR
Upper_bounday = Q3 +  1.5 * IQR
Aqui Q1 e Q3 são o primeiro quântico (percentil 25) e o terceiro quântico (percentil 75)
Análise bivariada / multivariado
Estudamos vários gráficos para explorar dados numéricos e categóricos únicos. A análise bivariada é usada quando temos que explorar a ligação entre 2 variáveis diferentes e temos que fazer isso porque, ao final, nossa principal tarefa é explorar a ligação entre as variáveis para construir um modelo poderoso. E quando analisamos mais do que 2 variáveis juntas, conhecido como análise multivariada. vamos trabalhar em diferentes gráficos para análise bivariada, bem como análise multivariada.
Numérico e numérico
Primeiro, vamos explorar os gráficos quando ambas as variáveis são numéricas.
1) Gráfico de dispersãoUm gráfico de dispersão é uma representação visual que mostra a relação entre duas variáveis numéricas usando pontos em um plano cartesiano. Cada eixo representa uma variável, e a localização de cada ponto indica seu valor em relação a ambos. Esse tipo de gráfico é útil para identificar padrões, Correlações e tendências nos dados, facilitando a análise e interpretação de relações quantitativas....
Traçar a ligação entre dois gráficos de dispersão de variáveis numéricas é um gráfico simples de fazer. Veamos la vinculación entre la cuenta total y la propina proporcionada a través de un Diagrama de dispersãoO gráfico de dispersão é uma ferramenta gráfica usada em estatística para visualizar a relação entre duas variáveis. Consiste em um conjunto de pontos em um plano cartesiano, onde cada ponto representa um par de valores correspondentes às variáveis analisadas. Este tipo de gráfico permite identificar padrões, Tendências e possíveis correlações, facilitando a interpretação dos dados e a tomada de decisão com base nas informações visuais apresentadas.....
sns.scatterplot(tips["total_bill"], tips["tip"])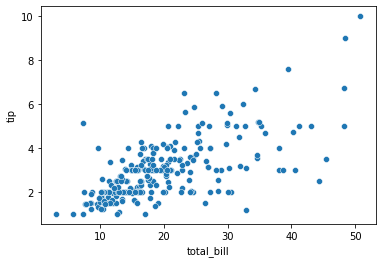
Análise multivariada com gráfico de dispersão
também podemos representar graficamente as relações de 3 variáveis ou 4 variáveis com um gráfico de dispersão. Suponha que desejamos encontrar a proporção separada de homens e mulheres com o total de contas e gorjetas fornecidas.
sns.scatterplot(tips["total_bill"], tips["tip"], hue=tips["sex"])
plt.show()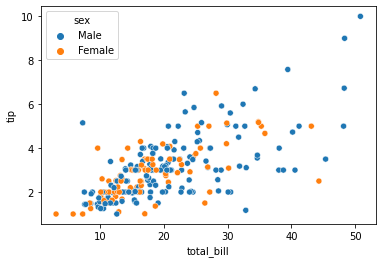
Também podemos ver a análise multivariada de 4 variáveis com gráficos de dispersão usando argumentos de estilo. Suponha agora, junto com gênero, Também quero saber se o cliente era fumante ou não, para que possamos fazer isso.
sns.scatterplot(tips["total_bill"], tips["tip"], hue=tips["sex"], style=tips['smoker'])
plt.show()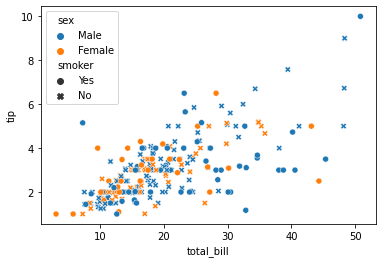
Numérico e categórico
Se uma variável for numérica e a outra categórica, existem vários gráficos que podemos usar para análises bivariadas e multivariadas.
1) Gráfico de barras
O gráfico de barras é um diagrama simples que podemos usar para plotar uma variável categórica no eixo xe uma variável numérica no eixo y e explorar a relação entre as duas variáveis.. A ponta preta no topo de cada barra mostra o intervalo de confiança. Vamos explorar o P-Class com a idade.
sns.barplot(data['Pclass'], data['Age'])
plt.show()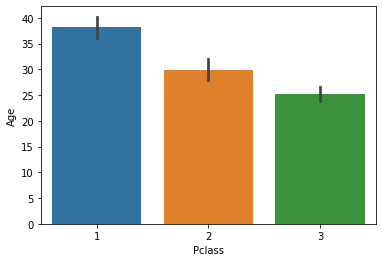
Análise multivariada por meio de gráfico de barras
O argumento de Hue é muito útil e ajuda a analisar mais do que 2 variáveis. Agora, junto com o link acima, nós queremos fazer com gênero.
sns.barplot(data['Pclass'], data['Fare'], hue = data["Sex"])
plt.show()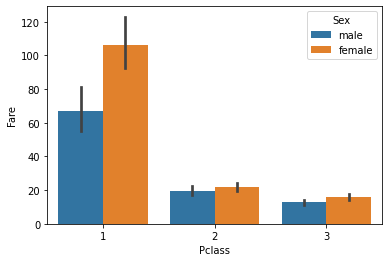
2) Box plot
Ya hemos estudiado sobre plotagens de caixaDiagramas de caixa, Também conhecido como diagramas de caixa e bigode, são ferramentas estatísticas que representam a distribuição de um conjunto de dados. Esses diagramas mostram a mediana, Quartis e outliers, permitindo que a variabilidade e a simetria dos dados sejam visualizadas. Eles são úteis na comparação entre diferentes grupos e na análise exploratória, facilitando a identificação de tendências e padrões nos dados.... en el análisis univariante anterior. podemos desenhar um gráfico de caixa separado para ambas as variáveis. Vamos explorar o gênero com a idade usando um gráfico de caixa.
sns.boxplot(data['Sex'], data["Age"])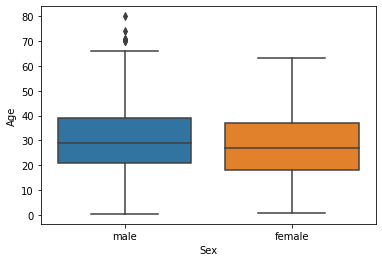
Análise multivariada com box plot
Junto com idade e sexo, vamos ver quem sobreviveu e quem não.
sns.boxplot(data['Sex'], data["Age"], data["Survived"])
plt.show()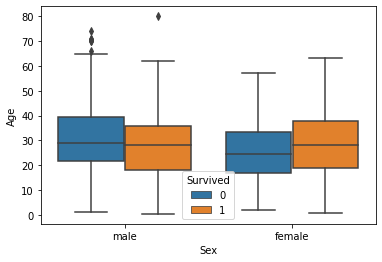
3) Distplot
Distplot explica a função PDF por meio da estimativa da densidade do kernel. Distplot não tem um parâmetro de pitch, mas podemos criá-lo. Suponha que queremos ver a probabilidade de pessoas com uma faixa etária de probabilidade de sobrevivência e descobrir cuja probabilidade de sobrevivência é alta para a faixa etária da taxa de mortalidade.
sns.distplot(data[data['Survived'] == 0]['Age'], hist=False, color="blue")
sns.distplot(data[data['Survived'] == 1]['Age'], hist=False, color="orange")
plt.show()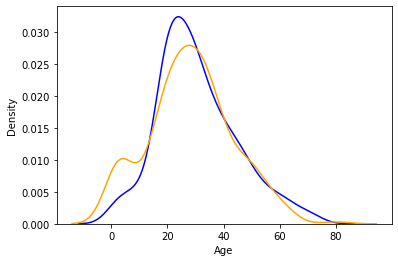
Como podemos ver, o gráfico é realmente muito interessante. o azul mostra a probabilidade de morrer e o gráfico laranja mostra a probabilidade de sobrevivência. Se observarmos, podemos ver que a probabilidade de sobrevivência dos filhos é maior do que a de morte e que é o contrário no caso dos idosos.. Essa pequena análise às vezes diz algumas coisas importantes sobre os dados e ajuda na preparação de histórias de dados.
Categórico e categórico
Agora vamos trabalhar em colunas categóricas e categóricas.
1) Mapa de caloruma "mapa de calor" é uma representação gráfica que usa cores para mostrar a densidade de dados em uma área específica. Comumente usado em análise de dados, Estudos de marketing e comportamentais, Esse tipo de visualização permite identificar padrões e tendências rapidamente. Através de variações cromáticas, Os mapas de calor facilitam a interpretação de grandes volumes de informações, ajudando a tomar decisões informadas....
Se você já usou uma função de crosstab do pandas, O mapa de calor é uma representação visual equivalente de apenas. Simplesmente, mostra quanta presença de uma categoria em link com outra categoria está presente no conjunto de dados. deixe-me mostrar primeiro com a crosstab e depois com o mapa de calor.
pd.crosstab(data['Pclass'], data['Survived'])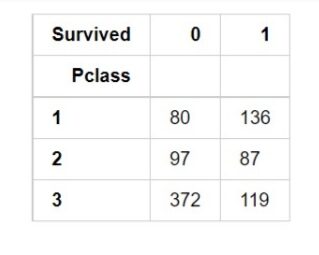
Agora, com o mapa de calor, temos que descobrir quantas pessoas sobreviveram e morreram.
sns.heatmap(pd.crosstab(data['Pclass'], data['Survived']))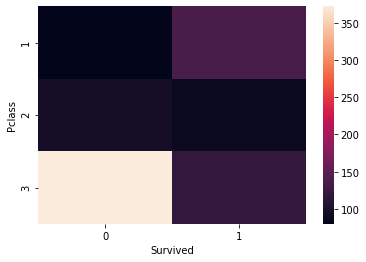
2) Mapa de Cluster
também podemos usar um mapa de cluster para entender a ligação entre duas variáveis categóricas. Um mapa de cluster simplesmente desenha um dendrograma mostrando as categorias de comportamento equivalente juntas..
sns.clustermap(pd.crosstab(data['Parch'], data['Survived']))
plt.show()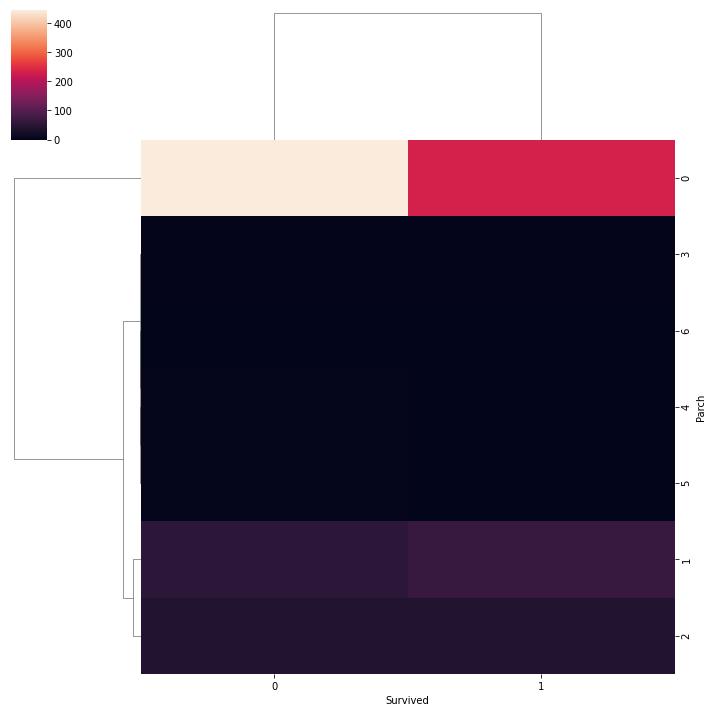
Se você conhece algoritmos de clustering principalmente em DBSCAN, então você deve saber o dendrograma. Então, todos esses são gráficos usados principalmente ao fazer análises exploratórias. Existem mais alguns enredos que você pode desenhar como um enredo violento, padrão de linha, uma trama de junta que não é usada principalmente.
O Notebook completo para mais prática em EDA e visualização de dados está habilitado em meus Notebooks por kaggle, acessá-lo de aqui.
Notas finais
EDA é apenas uma chave para entender e representar seus dados de uma maneira melhor, o que, como consequência, ajuda a construir um modelo poderoso e mais generalizado. A visualização de dados é fácil de realizar EDA, tornando mais fácil para outras pessoas entenderem nossa análise.
Espero que tenha sido fácil acompanhar todos os gráficos que desenhamos. Se você tiver alguma dúvida, mencione-o na seção de comentários abaixo. Ficarei feliz em ajudá-lo.
Sobre o autor
Raghav Agrawal
Estou buscando meu diploma em ciência da computação. Eu realmente gosto de ciência de dados e big data. Adoro trabalhar com dados e aprender novas tecnologias. Por favor, sinta-se à vontade para se conectar comigo no Linkedin.





